


Python中Numpy数组NaN与Inf值的均值填充处理

本文介绍如何在Python的Numpy库中处理NaN和Inf值。通过将NaN替换为对应列的均值,避免直接填0对统计结果的影响。同时讲解了使用np.nanmean等函数在计算时忽略NaN值的方法,并提供完整的代码示例。
NaN与Inf的基本概念及类型
NaN代表Not a Number,即非数值。
Inf代表Infinity,即无穷大(正无穷)。
在Numpy库中,NaN和Inf的数据类型均为float。
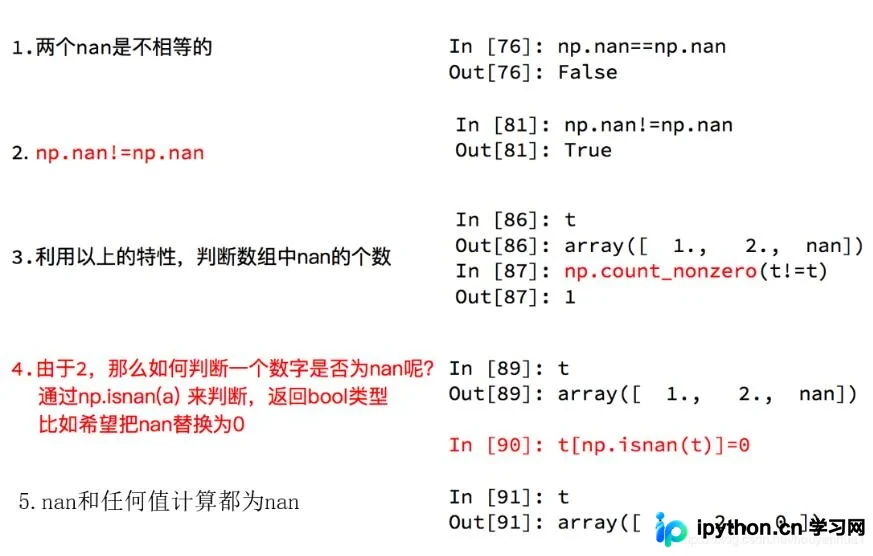
通过表达式t!=t可以生成一个布尔类型的数组(或矩阵),用于标识NaN位置。
np.count_nonzero()函数用于统计数组中非零元素的数量,在此场景下可用于计算布尔数组中True(即NaN)的个数。
np.isnan()函数返回一个布尔类型的数组,标识原数组中哪些元素为NaN。
NaN值替换策略:均值填充法
这里存在一个关键问题:在数据集中单纯将NaN替换为0是否合适?这会对后续分析产生何种影响?
例如,若将所有NaN替换为0,且原数据的平均值大于0,则替换后的整体均值必然减小。因此,更通用的做法是将缺失值替换为该列的均值(或中位数),或者直接删除包含缺失值的行。
Numpy数组NaN均值填充代码示例
以下是一个示例代码文件demo.py,演示如何使用Numpy将数组中的NaN替换为对应的均值。
# coding=utf-8
import numpy as np

def fill_ndarray(t1):
 for i in range(t1.shape[1]): # 遍历每一列(每一列中的nan替换成该列的均值)
 temp_col = t1[:, i] # 当前的一列
 nan_num = np.count_nonzero(temp_col != temp_col)
 if nan_num != 0: # 不为0,说明当前这一列中有nan
  temp_not_nan_col = temp_col[temp_col == temp_col] # 去掉nan的ndarray

  # 选中当前为nan的位置,把值赋值为不为nan的均值
  temp_col[np.isnan(temp_col)] = temp_not_nan_col.mean() # mean()表示求均值。
 return t1

if __name__ == '__main__':
 t1 = np.array([[ 0., 1., 2., 3., 4., 5.],
   [ 6., 7., np.nan, np.nan, np.nan, np.nan],
   [12., 13., 14., 15., 16., 17.],
   [18., 19., 20., 21., 22., 23.]])

 t1 = fill_ndarray(t1) # 将nan替换成对应的均值
 print(t1)
 '''
 [[ 0. 1. 2. 3. 4. 5.]
 [ 6. 7. 12. 13. 14. 15.]
 [12. 13. 14. 15. 16. 17.]
 [18. 19. 20. 21. 22. 23.]]
 '''
忽略NaN值的统计计算方法
补充知识:在Numpy中对数组求平均值时如何忽略NaN值。
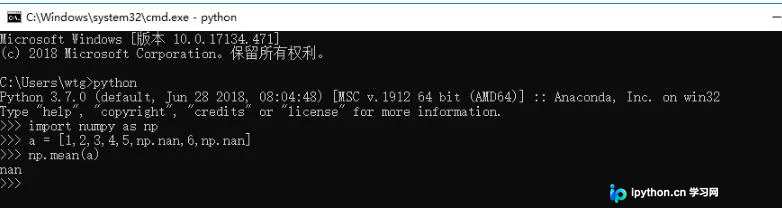
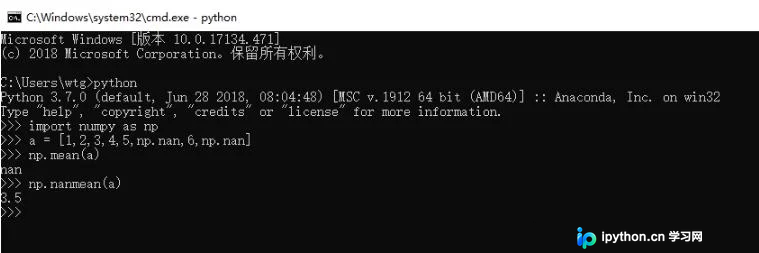
前言:在使用np.mean()、np.max()或np.min()计算Numpy数组的平均值或最大/最小值时,如果数组中包含NaN,结果将返回NaN。若要忽略其中的NaN值,应使用np.nanmean()、np.nanmax()或np.nanmin()函数。
展示使用np.mean()处理含NaN数组的效果。
展示使用np.nanmean()处理含NaN数组的效果。
以上关于Python实现将Numpy中NaN和Inf替换为对应均值的内容分享给大家,希望能为读者提供参考,并欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















