


sklearn实现线性与非线性逻辑回归详解

本文通过Python代码演示如何利用sklearn库实现线性与非线性逻辑回归。文章首先介绍线性逻辑回归在简单数据集上的建模、拟合及评估过程,随后深入讲解非线性逻辑回归中通过多项式特征扩展决策边界的方法。对比两者在代价函数与预估函数复杂度上的异同,并展示高准确率的分类结果,帮助读者掌握sklearn在分类任务中的核心应用。
线性逻辑回归实现
线性逻辑回归
本文将通过代码示例,展示如何使用sklearn库执行线性逻辑回归的计算流程。首先,我们需要明确所使用的数据集结构。
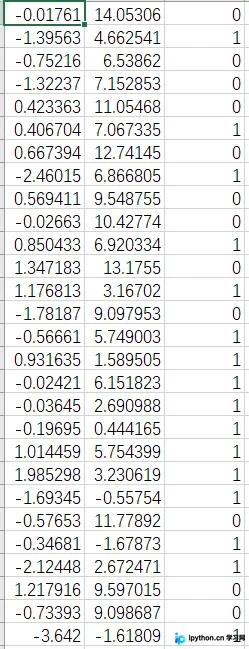
该数据集包含两行特征数据,第三行则对应数据的标签信息。
python代码
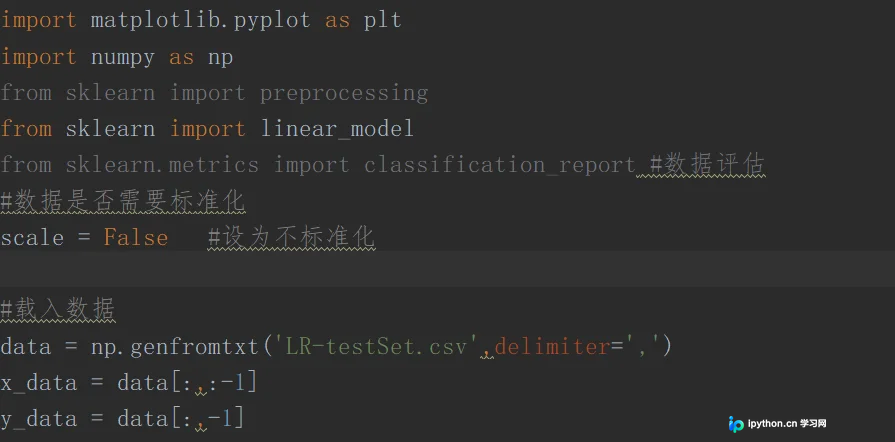
第一步是导入必要的库并加载数据。
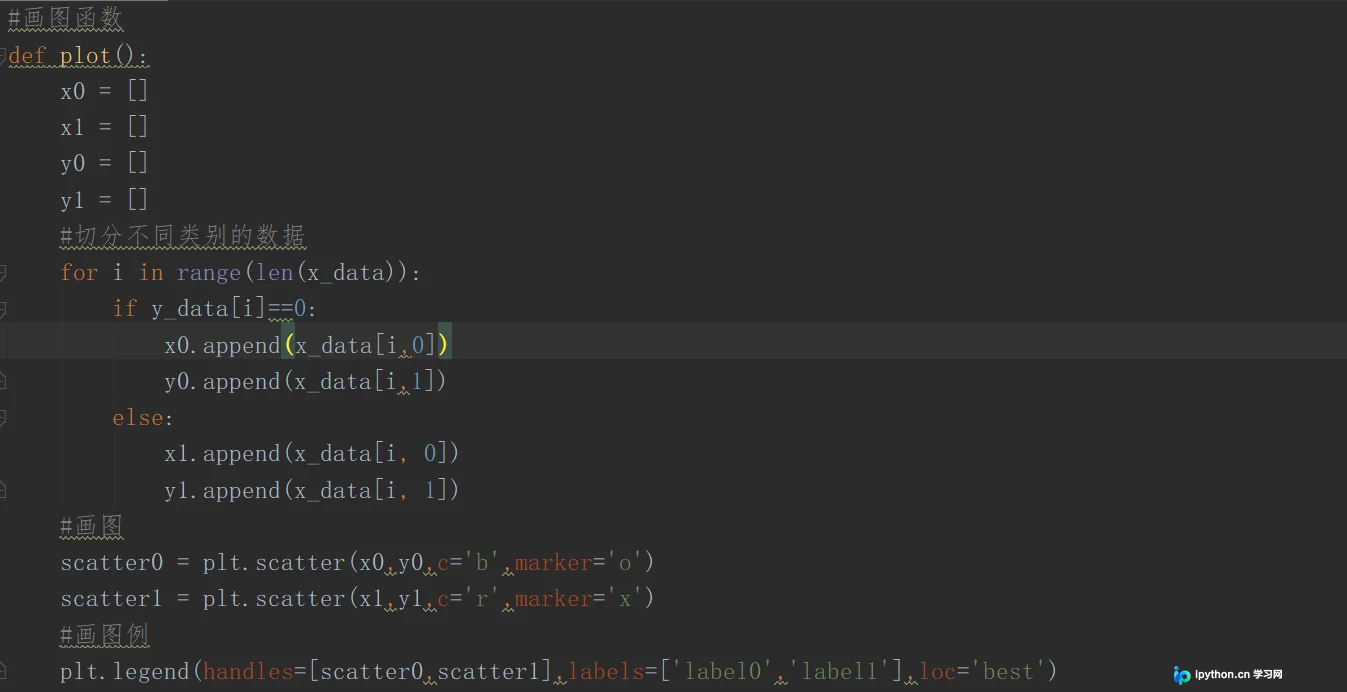
接下来编写一个绘图函数,用于可视化展示这些数据点分布情况:
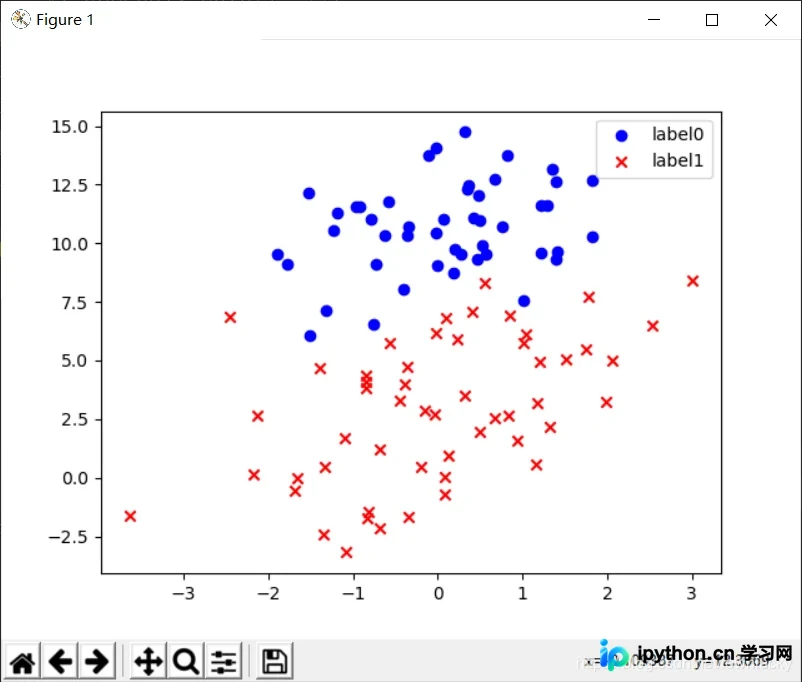
调用上述函数后,我们得到如下可视化图像:
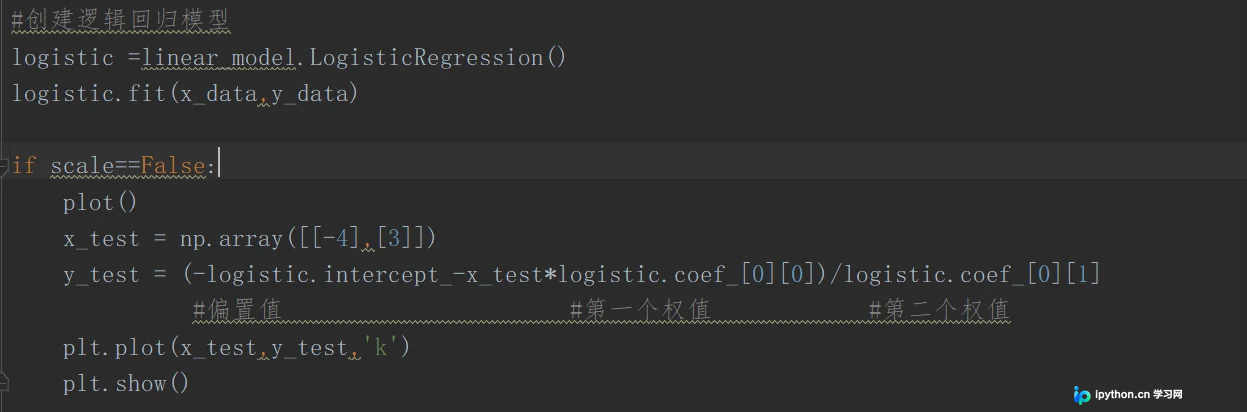
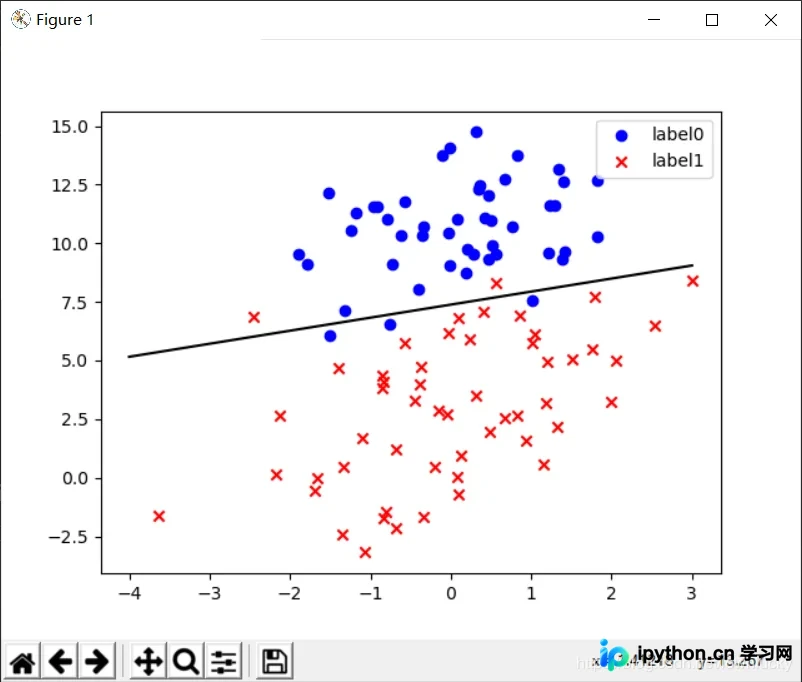
随后开始构建模型并进行拟合。调用sklearn中的逻辑回归方法,该函数会自动计算权值和偏置值,操作十分简便。最后,我们将模型结果绘制成图像。
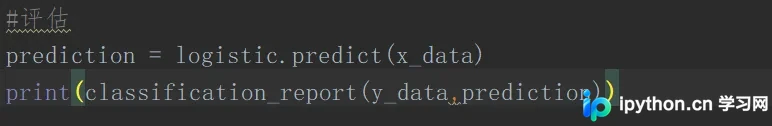
最后,我们可以查看模型的评估指标:
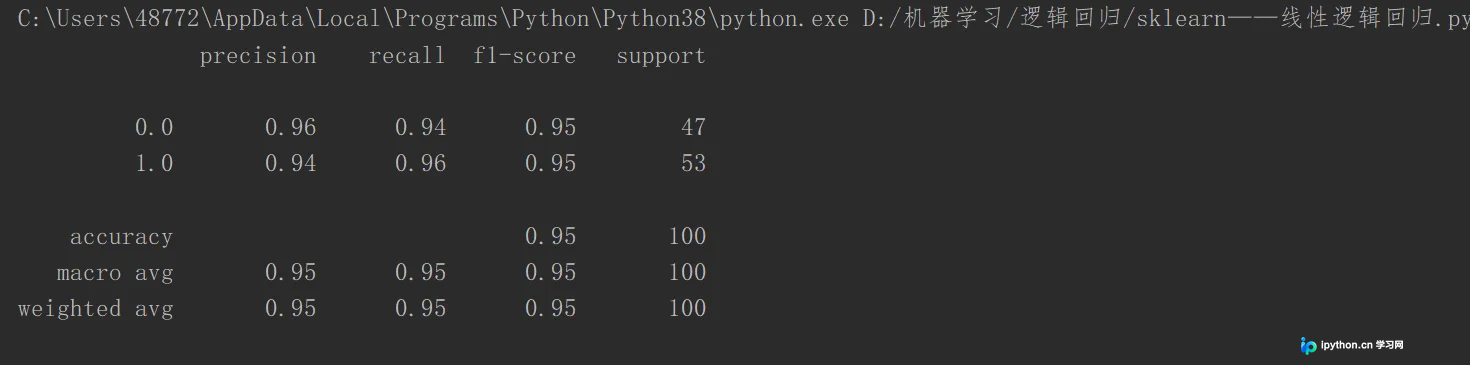
结果显示,正确率、召回率以及F1值均达到了95%。
非线性逻辑回归实现
非线性逻辑回归
非线性逻辑回归的特征在于其决策边界为曲线,其基本原理与线性逻辑回归相似。此处使用的数据由datasets模块自动生成。
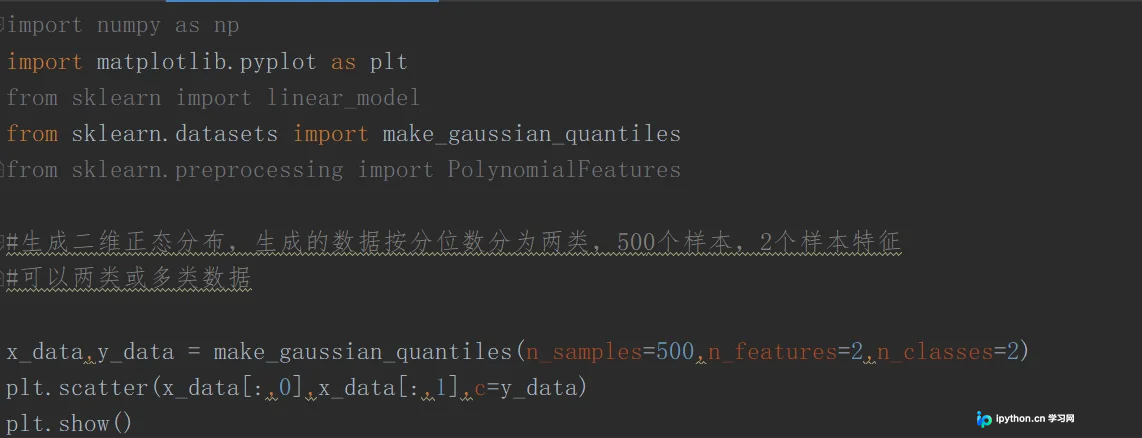
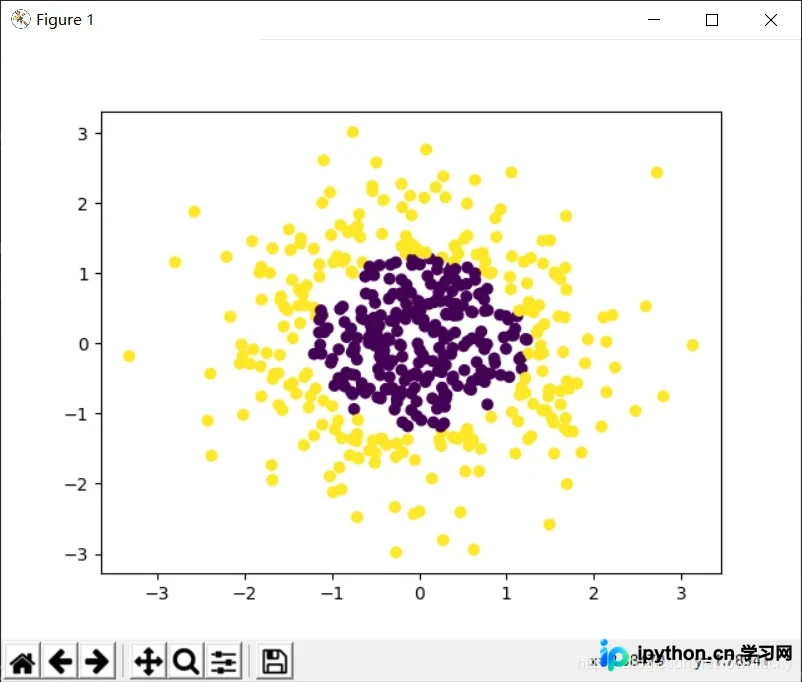
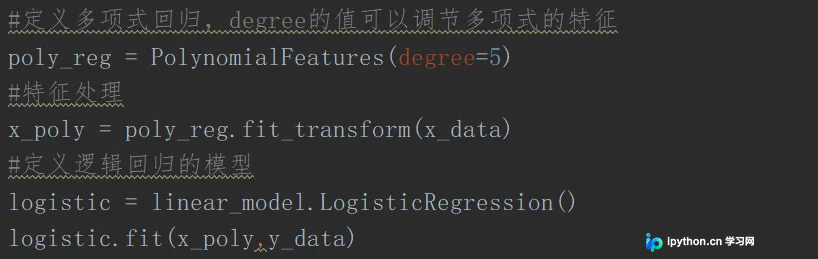
接下来需要对数据进行多项式处理,其核心思路是增加数据的特征维度。
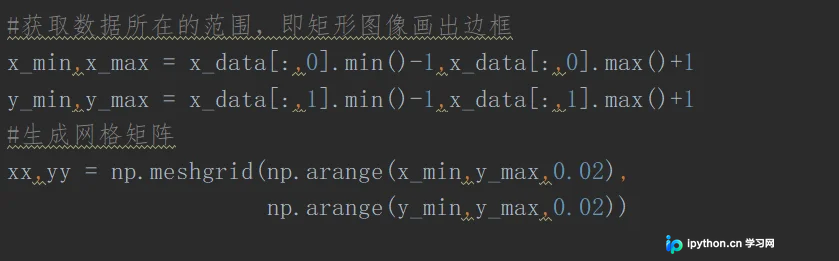
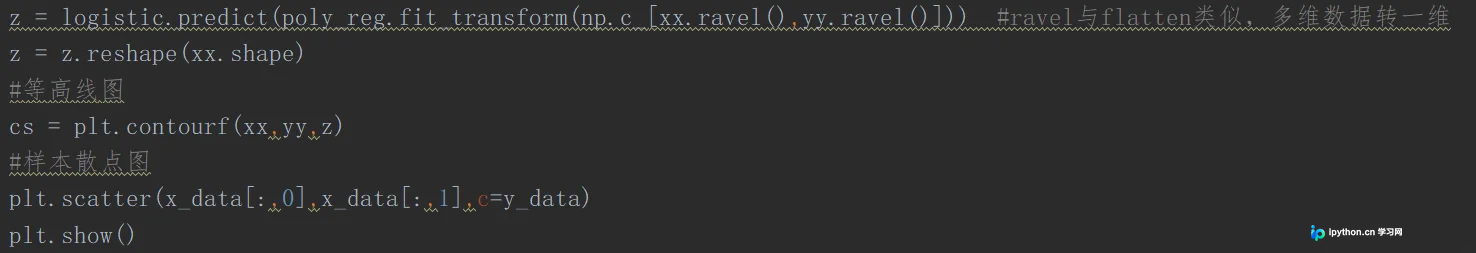
随后设定图像的坐标范围,并生成一个网格矩阵。
定义等高线的绘制高度。
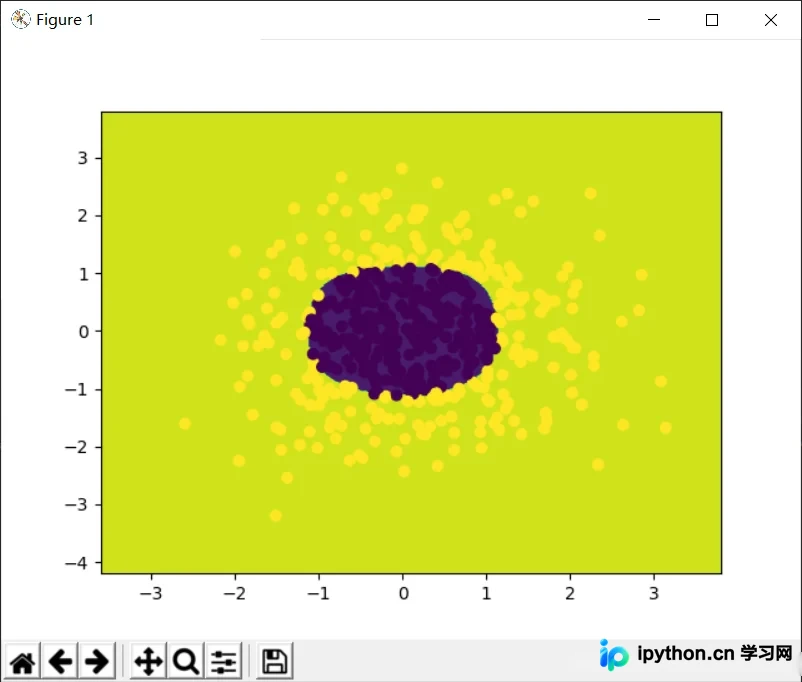
结果清晰可见,数据被很好地分为了两类。
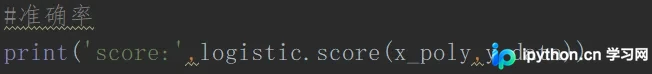
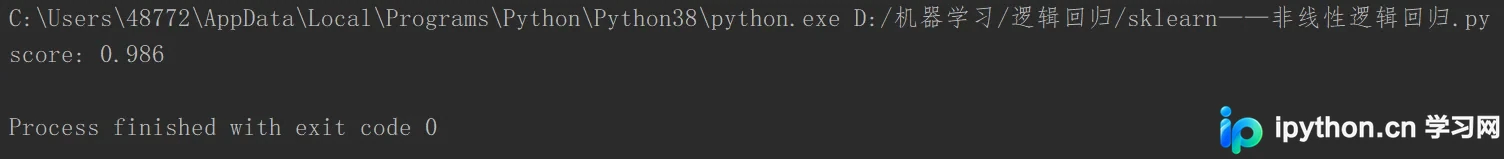
查看准确率,结果为98%,说明该方法较为成功,具有较高的准确率。
线性逻辑回归与非线性逻辑回归所采用的代价函数相同,基本原理一致。两者的主要区别在于预估函数的复杂度:非线性逻辑回归需要对数据进行多项式处理,从而增加数据的特征数量。
至此,关于sklearn线性逻辑回归和非线性逻辑回归的实现介绍完毕。如需了解更多相关sklearn线性逻辑回归和非线性逻辑回归内容,请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















