


Python数据清洗实战:从缺失值到数据泄漏的完整处理流程

本文详细介绍利用Python进行数据清洗的核心步骤。涵盖缺失值的分析与填补策略、基于IQR的异常值识别与裁剪、字符型数据不一致性的手动修正,以及无效数据的逻辑校验。重点强调在预处理前必须拆分数据集以规避数据泄漏,并推荐使用sklearn Pipeline简化流程,确保模型评估的独立性。
在数据科学领域,有一句广为流传的名言:
数据科学家约80%的工作时间都耗费在数据处理上。
若尚未听闻此言,请务必牢记:数据清洗构成了数据科学工作流的基石。机器学习模型的性能直接取决于输入数据的质量,杂乱无章的数据不仅会导致性能下滑,甚至可能引发错误的预测结果;相反,高质量的数据是模型发挥最佳性能的前提。当然,干净的数据并非性能保证的唯一因素,模型选型(即剩余的20%工作)同样关键,但若缺乏清洁的数据,再先进的算法也无法达到预期效果。
本文将梳理数据清洗过程中常见的问题及其对应的解决方案,通过逐步演示,帮助读者掌握系统化的数据清洗方法。
缺失值
当数据集中存在缺失数据时,在实施填充策略前,建议先对数据进行探索性分析。因为空值出现的分布位置本身可能蕴含重要信息。例如:
- 若NA值仅集中出现在数据集的尾部或中间特定区域,这可能暗示数据收集环节存在技术故障。此时需深入分析该特定样本序列的采集流程,以定位问题根源。
- 若某列的NA值比例超过70%至80%,通常建议直接删除该列。
- 若NA值出现在表单的可选问题列中,可将其编码为二元变量:用户已回答标记为1,未回答标记为0。
Python库可用于可视化检查上述情况,其使用方式十分简便。如下图中所示的白线即代表NA值:
import missingno as msno
msno.matrix(df)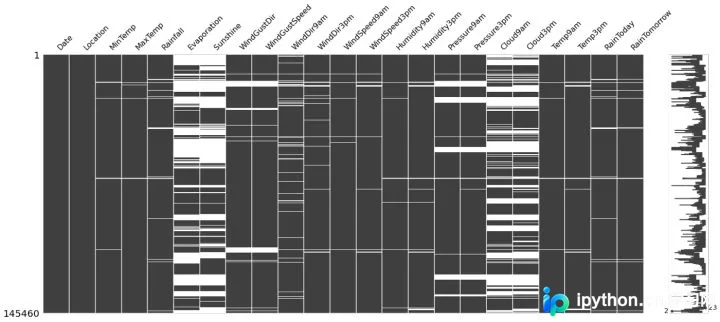
针对缺失值的填补计算存在多种方法,例如:
- 使用平均值、中位数或众数进行填充
- 基于k近邻(kNN)算法进行预测填补
- 使用零值或固定常数填充等
不同方法各有优劣,并不存在适用于所有场景的“最佳”技术。具体细节可参考我们此前发布的文章
异常值
异常值是指相对于数据集中其他观测点而言极大或极小的数值。它们的存在会对数学模型的性能产生显著影响。观察以下简单示例:
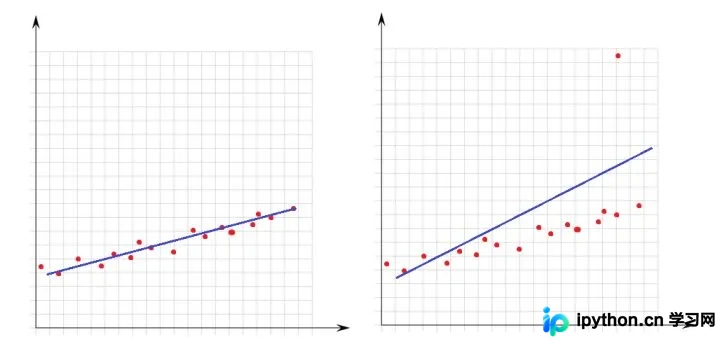
左图所示数据无异常值,线性模型拟合效果良好;右图包含一个异常值,该极端值迫使模型调整拟合方式以覆盖所有点,导致模型无法准确拟合至少一半的数据点。
因此,明确如何界定“极大”或“极小”至关重要,这需要从数学角度定义异常值的判定标准。
通常将大于Q3+1.5×IQR或小于Q1-1.5×IQR的值视为异常值。其中,IQR(四分位距)定义为Q3与Q1之差(即IQR = Q3 - Q1)。
可使用以下函数统计数据集中异常值的数量:
def number_of_outliers(df):

    df = df.select_dtypes(exclude = 'object')

    Q1 = df.quantile(0.25)
    Q3 = df.quantile(0.75)
    IQR = Q3 - Q1

    return ((df < (Q1 - 1.5 * IQR)) | (df > (Q3 + 1.5 * IQR))).sum()
处理异常值的一种策略是将其截断至Q1或Q3的边界值。下面的函数利用pandas和numpy库计算超出范围的异常值区间,并通过clip函数将数值裁剪至指定范围。
def lower_upper_range(datacolumn):
    sorted(datacolumn)
    Q1,Q3 = np.percentile(datacolumn , [25,75])
    IQR = Q3 - Q1
    lower_range = Q1 - (1.5 * IQR)
    upper_range = Q3 + (1.5 * IQR)
    return lower_range,upper_range

for col in columns:
    lowerbound,upperbound = lower_upper_range(df[col])
    df[col]=np.clip(df[col],a_min=lowerbound,a_max=upperbound)
数据不一致
前述异常值问题主要针对数值型特征,现在转向字符型(分类)特征。数据不一致表现为列中唯一类别存在多种表示形式。例如,在性别栏中可能同时存在“m/f”与“male/female”,这会导致实际上仅有两个类别,却错误地识别出四个类别。
此类问题目前缺乏全自动处理方案,需进行手动分析。pandas的unique函数正是为此类分析设计,以下展示一个汽车品牌的处理案例:
df['CarName'] = df['CarName'].str.split().str[0]
print(df['CarName'].unique())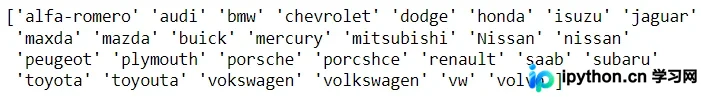
通过映射规则,可将“maxda”合并为“mazda”,“Nissan”统一为“nissan”,“porcshce”修正为“porsche”,“toyouta”修正为“toyota”等。
df.loc[df['CarName'] == 'maxda', 'CarName'] = 'mazda'
df.loc[df['CarName'] == 'Nissan', 'CarName'] = 'nissan'
df.loc[df['CarName'] == 'porcshce', 'CarName'] = 'porsche'
df.loc[df['CarName'] == 'toyouta', 'CarName'] = 'toyota'
df.loc[df['CarName'] == 'vokswagen', 'CarName'] = 'volkswagen'
df.loc[df['CarName'] == 'vw', 'CarName'] = 'volkswagen'
无效数据
无效数据指在逻辑上完全站不住脚的数值。例如:
- 某人年龄记录为560岁;
- 某项操作耗时-8小时;
- 某人身高记录为1200 cm等;
对于数值型列,可利用pandas的describe函数快速识别此类逻辑错误:
df.describe()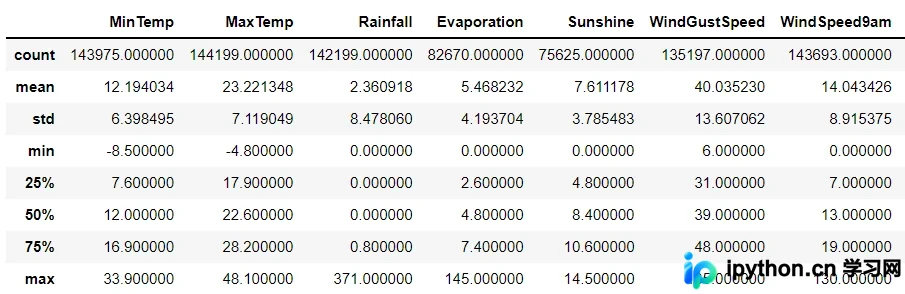
无效数据的产生原因主要归结为两类:
1、数据收集错误:例如输入时未进行范围校验,将身高179cm误录为1799cm,且程序未对数据范围进行有效判断。
2、数据操作错误
数据集的某些列可能经过特定函数处理。例如,某函数根据生日计算年龄,但因存在BUG导致输出结果不正确。
上述两类随机错误均可视为空值,并与其他NA值一同进行估算处理。
重复数据
当数据集中存在完全相同的行时,即产生重复数据问题。这可能源于数据合并错误(来自多个来源的同一行被重复录入),或用户重复提交答案等操作失误。处理该问题的理想方式是直接删除重复行。
可使用pandas的duplicated函数查看重复的数据:
df.loc[df.duplicated()]
在识别出重复数据后,可使用pandas的drop_duplicates函数将其删除:
df.drop_duplicates()
数据泄漏问题
在构建模型前,数据集需划分为训练集和测试集。测试集作为“未见”数据,用于评估模型性能。若在数据清洗或预处理步骤中,模型以某种方式“看到”了测试集,即构成数据泄漏(data leakage)。因此,必须在清洗和预处理步骤之前完成数据拆分:
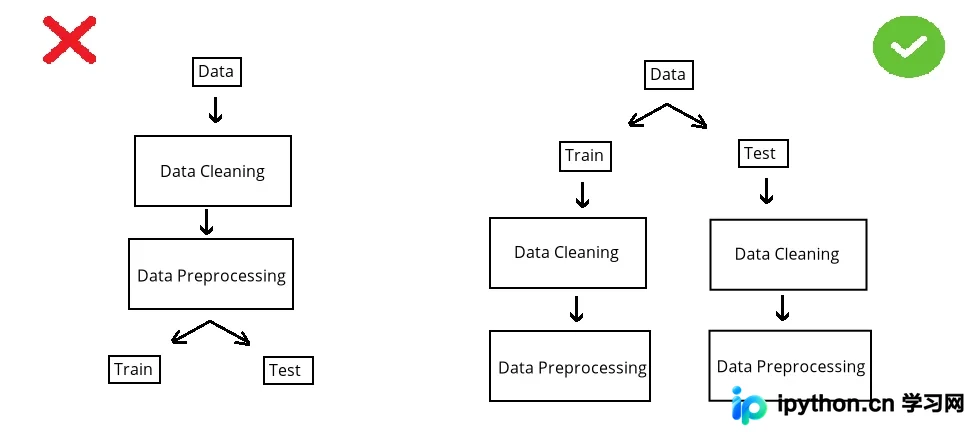
以缺失值插补为例,若数值列包含NA并采用均值法估算。若在split前完成插补,使用的是整个数据集的均值;若在split后完成,则分别使用训练集和测试集的均值。
第一种情况的问题在于,测试集中的推算值与训练集相关,因为均值基于整个数据集计算得出。当模型使用训练集构建时,实际上也“看到”了测试集信息。然而,拆分数据的初衷是保持测试集的完全独立性,使其如同新数据一般用于性能评估。因此,必须在执行任何操作前拆分数据集。
虽然分别处理训练集和测试集效率较低(因相同操作需执行两次),但这可能是确保正确性的必要代价。鉴于数据泄漏问题的严重性,为解决代码重复编写的问题,可使用sklearn库的pipeline。简言之,Pipeline是将所有数据操作步骤组合而成的管道,只需设定好操作流程,无论是训练集还是测试集,均可通过相同步骤进行处理。这不仅减少了代码开发量,还降低了出错概率。
至此,关于利用Python进行数据清洗的操作指南介绍完毕。如需了解更多Python数据清洗相关内容,请搜索本站往期文章或继续浏览后续文章,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















