


Python sklearn中model.predict与predict_proba的区别解析

本文详细解析Python sklearn库中model.predict()与model.predict_proba()函数的核心区别。通过LogisticRegression示例代码,展示predict返回具体分类标签,而predict_proba返回各类别的概率分布。文章深入探讨了多分类场景下的概率输出逻辑,并解释了predict_proba结果如何依据self.classes_进行排序,帮助开发者准确理解模型输出格式。
下面直接通过代码示例进行说明。
clf=KMeans(n_clusters=5) #创建分类器对象
fit_clf=clf.fit(X) #用训练器数据拟合分类器模型
clf.predict(X) #也可以给新数据数据对其预测

print(clf.cluster_centers_) #输出5个类的聚类中心

y_pred = clf.fit_predict(X) #用训练器数据X拟合分类器模型并对训练器数据X进行预测

print(y_pred) #输出预测结果
predict与predict_proba的核心区别
补充说明:在sklearn中调用机器学习模型时,model.predict(x)与model.predict_proba(x)的功能存在显著差异。
model.predict_proba(x)与model.predict()不同,它返回的是预测为各个类别的概率值。具体而言,若存在N个分类结果,则每行输出包含N个概率值,分别对应每个类别的预测概率。例如,在0和1的二分类任务中,输出将包含两个概率值。
接下来通过具体代码实例进一步讲解。
Python 3代码实现如下:
# -*- coding: utf-8 -*-
"""
Created on Sat Jul 27 21:25:39 2019

@author: ZQQ
"""
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from xgboost import XGBClassifier
import numpy as np
import warnings
warnings.filterwarnings("ignore")
# 这个方法只是解决了表面,没有根治

# 数据(特征,属性)
x_train = np.array([[1,2,3],
          [1,5,4],
          [2,2,2],
          [4,5,6],
          [3,5,4],
          [1,7,2]])
# 数据的标签
y_train = np.array([1, 0, 1, 1, 0, 0])

# 测试数据
x_test = np.array([[2,1,2],
          [3,2,6],
          [2,6,4]])

# 导入模型
model = LogisticRegression()

#model = RandomForestClassifier()

#model=XGBClassifier()

model.fit(x_train, y_train)

# 返回预测标签
print(model.predict(x_test))

print('---------------------------------------')

# 返回预测属于某标签的概率
print(model.predict_proba(x_test))
运行结果如下:
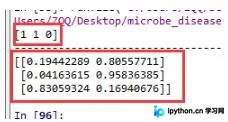
结果分析:
predict输出具体分类标签
使用model.predict()时:
输入[2,1,2]被预测为类别1
输入[3,2,6]被预测为类别1
输入[2,6,4]被预测为类别0
predict_proba输出类别概率
使用model.predict_proba()时:
输入[2,1,2]属于类别0的概率为0.19442289,属于类别1的概率为0.80557711
输入[3,2,6]属于类别0的概率为0.04163615,属于类别1的概率为0.95836385
输入[2,6,4]属于类别0的概率为0.83059324,属于类别1的概率为0.16940676
预测为类别0的概率值与预测为类别1的概率值之和恒等于1
同理,若标签类别增加至3类(0、1、2):
预测为类别0的概率值记为a
预测为类别1的概率值记为b
预测为类别2的概率值记为c
所有预测概率值之和满足a+b+c=1
概率输出的排序机制
注意:model.predict_proba()返回所有标签对应的可能性概率值,这些值的排序依据是什么?
该函数返回模型中每个类别的样本概率,类别顺序严格遵循self.classes_中的定义。
通常通过numpy.unique(label)方法,对label中的所有标签值进行去重并从小到大排序。
由此得到一个从小到大排列的唯一值序列,该序列直接对应model.predict_proba()输出行的顺序。
以上关于Python sklearn中model.predict与predict_proba用法的说明即为全部内容,希望能对读者有所帮助,也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















