


Python 爬虫原理详解:流程、HTTP协议与数据解析

本文深入解析Python爬虫的核心原理,涵盖发起请求、获取响应、解析内容及保存数据四大基本流程。详细阐述HTTP Request与Response的结构,包括GET/POST等请求方式及状态码含义,并介绍正则、BeautifulSoup等数据解析技术,以及针对JS渲染数据的Selenium等解决方案。
Python爬虫基本流程
网络爬虫本质上是自动请求网站并提取数据的程序。其核心要素在于“请求”、“提取”和“自动化”这三个关键环节。接下来我们将深入剖析爬虫工作的基本流程。
网络爬虫的基本工作流程
发起请求阶段
首先,利用HTTP库向目标站点发送Request(请求)。该请求可以包含额外的header(头部信息),随后等待服务器的响应。
获取响应内容阶段
若服务器正常响应,将返回一个Response(响应)。Response的内容即为所获取的页面内容,其类型可能包括HTML、Json字符串或二进制数据(如图片或视频)等。
解析内容阶段
获取的内容类型多样:若是HTML,可使用正则表达式或页面解析库进行解析;若是Json,可直接转换为Json对象进行解析;若是二进制数据,则需进行保存或进一步处理。
保存数据阶段
数据保存形式多样,可以存储为文本文件、存入数据库,或保存为特定格式的文件。
HTTP请求与响应详解
理解Request与Response的概念
浏览器向网址所在的服务器发送消息的过程,被称为HTTP Request(HTTP请求)。
服务器接收到浏览器发送的消息后,会根据消息内容进行相应处理,然后将处理结果回传给浏览器,这一过程即为HTTP Response(HTTP响应)。
浏览器接收到服务器的Response信息后,会对信息进行相应处理,最终展示给用户。
Request(请求)的组成部分: 请求方式
常见的请求方式主要有GET和POST两种,此外还包括HEAD、PUT、DELETE和OPTIONS。 GET与POST的主要区别在于:GET请求的数据附加在URL中,而POST请求的数据则存放在请求体(头部)中。
GET方法:用于向指定资源发出“显示”请求。在Web Application中,使用GET方法应仅用于读取数据,而不应用于产生“副作用”的操作(如修改数据)。原因在于GET请求可能被网络蜘蛛随意访问。
POST方法:用于向指定资源提交数据,请求服务器进行处理(例如提交表单或上传文件)。数据被包含在请求本文中。此请求可能会创建新资源、修改现有资源,或两者兼有。
HEAD方法:与GET方法类似,都是向服务器发出指定资源的请求。区别在于服务器不传回资源的正文部分。其优势在于,无需传输全部内容即可获取关于该资源的“元信息”(元数据)。
PUT方法:用于向指定资源位置上传其最新内容。
OPTIONS方法:用于使服务器传回该资源所支持的所有HTTP请求方法。使用'*'代替资源名称向Web服务器发送OPTIONS请求,可用于测试服务器功能是否正常运作。
DELETE方法:用于请求服务器删除Request-URI所标识的资源。
请求URL
URL(统一资源定位符),即我们常说的网址,是对可以从互联网上得到的资源的位置和访问方法的一种简洁表示,也是互联网上标准资源的地址。互联网上的每个文件都有一个唯一的URL,它包含的信息指出了文件的位置以及浏览器应如何处理它。
URL的格式由三个部分组成:
- 第一部分是协议(或称为服务方式)。
- 第二部分是存有该资源的主机IP地址(有时也包括端口号)。
- 第三部分是主机资源的具体地址,例如目录和文件名等。
爬虫在爬取数据时,必须有一个目标的URL才能获取数据,因此URL是爬虫获取数据的基本依据。
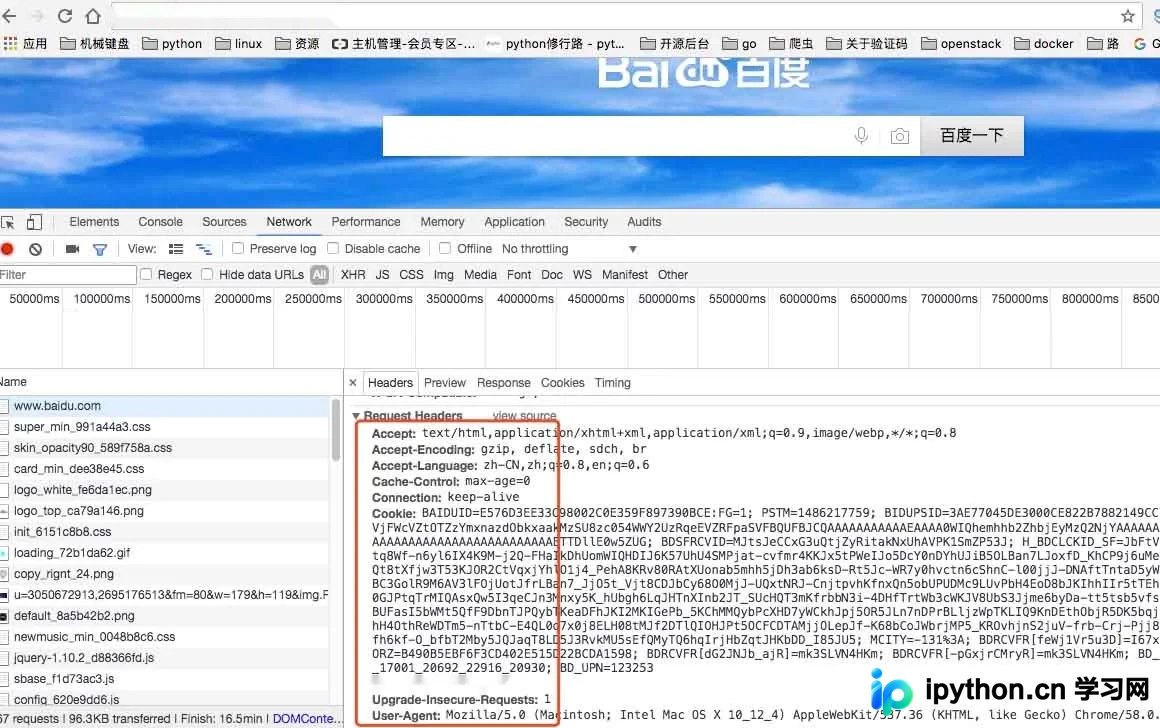
请求头
请求头包含请求时的头部信息,如User-Agent、Host、Cookies等。下图展示了请求百度时所有的请求头部信息参数。
请求体
请求体是携带的数据,例如在提交表单数据时(POST方式)所提交的表单数据。
Response(响应)的组成部分
所有HTTP响应的第一行都是状态行,依次包含当前HTTP版本号、由3位数字组成的状态代码以及描述状态的短语,彼此由空格分隔。
响应状态码
存在多种响应状态,例如:200代表成功,301代表跳转,404代表找不到页面,502代表服务器错误。
- 1xx消息:表示请求已被服务器接收,需继续处理。
- 2xx成功:表示请求已成功被服务器接收、理解并接受。
- 3xx重定向:表示需要后续操作才能完成这一请求。
- 4xx请求错误:表示请求含有词法错误或者无法被执行。
- 5xx服务器错误:表示服务器在处理某个正确请求时发生错误。常见代码包括: 200 OK:请求成功。 400 Bad Request:客户端请求有语法错误,不能被服务器所理解。 401 Unauthorized:请求未经授权,此状态代码必须和WWW-Authenticate报头域一起使用。 403 Forbidden:服务器收到请求,但拒绝提供服务。 404 Not Found:请求资源不存在,例如输入了错误的URL。 500 Internal Server Error:服务器发生不可预期的错误。 503 Server Unavailable:服务器当前不能处理客户端的请求,一段时间后可能恢复正常。 301:目标永久性转移。 302:目标暂时性转移。
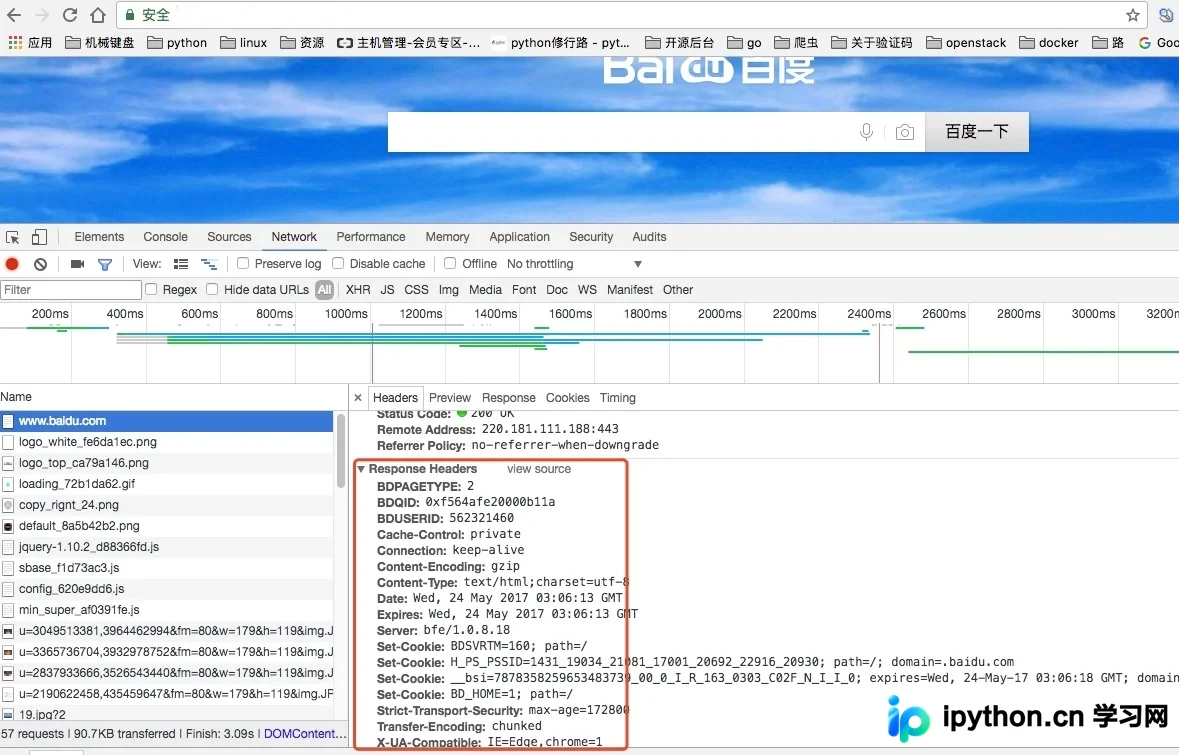
响应头
响应头包含内容类型、类型长度、服务器信息、设置Cookie等信息,如下图所示。
响应体
响应体是最主要的部分,包含请求资源的内容,如网页HTML、图片或二进制数据等。
数据解析与存储方案
可爬取的数据类型
网页文本:如HTML文档、Json格式化文本等。 图片:获取到的是二进制文件,保存为图片格式。 视频:同样是二进制文件。 其他:只要请求到的数据,都可以获取。
数据解析方法
- 直接处理
- Json解析
- 正则表达式处理
- BeautifulSoup解析处理
- PyQuery解析处理
- XPath解析处理
动态网页数据处理
关于抓取的页面数据与浏览器显示不一致的问题
出现这种情况是因为,许多网站中的数据是通过JS、AJAX动态加载的,因此直接通过GET请求获取的页面与浏览器实际显示的内容不同。
如何解决JS渲染的问题?
- 分析AJAX请求
- 使用Selenium/webdriver
- 使用Splash
- 使用PyV8或Ghost.py
数据保存方案
文本格式:纯文本、Json、Xml等。
关系型数据库:如MySQL、Oracle、SQL Server等结构化数据库。
非关系型数据库:如MongoDB、Redis等Key-Value形式存储。
以上即为Python爬虫原理的详细内容,更多关于Python爬虫原理的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















