


Python实现中国气象网图片爬取:单线程与多线程对比

本文详解如何利用Python从www.weather.com.cn批量爬取指定数量的图片。通过对比单线程与多线程两种实现方式,展示请求头构造、HTML解析、正则提取图片链接及本地保存的完整流程。重点解析多线程模块threading的使用及异常处理,帮助开发者提升数据抓取效率。
1.1 题目要求
任务是指定一个目标网站,爬取该网站内所有的图片资源。以中国气象网(www.weather.com.cn)为例,需要分别采用单线程和多线程两种模式进行爬取操作。需要注意的是,爬取图片的数量必须严格限制为学号的后三位数字。
输出要求包括:在控制台打印下载图片的URL信息,并将所有下载的图片文件存储到名为images的子文件夹中。此外,还需提供相应的截图以验证结果。
1.2 实现思路
1.2.1 发送请求阶段
首先构造请求头(Headers),模拟浏览器行为以通过服务器的基础反爬验证。
import requests,re
import urllib

headers = {
    'Connection': 'keep-alive',
    'Cache-Control': 'max-age=0',
    'Upgrade-Insecure-Requests': '1',
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/94.0.4606.61 Safari/537.36',
    'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.9',
    'Accept-Language': 'zh-CN,zh;q=0.9',
}

url = "http://www.weather.com.cn/"
request = urllib.request.Request(url, headers=headers)
接着使用构造好的请求头发送HTTP请求,获取网页原始数据。
request = urllib.request.Request(url, headers=headers)
r = urllib.request.urlopen(request)
1.2.2 解析网页阶段
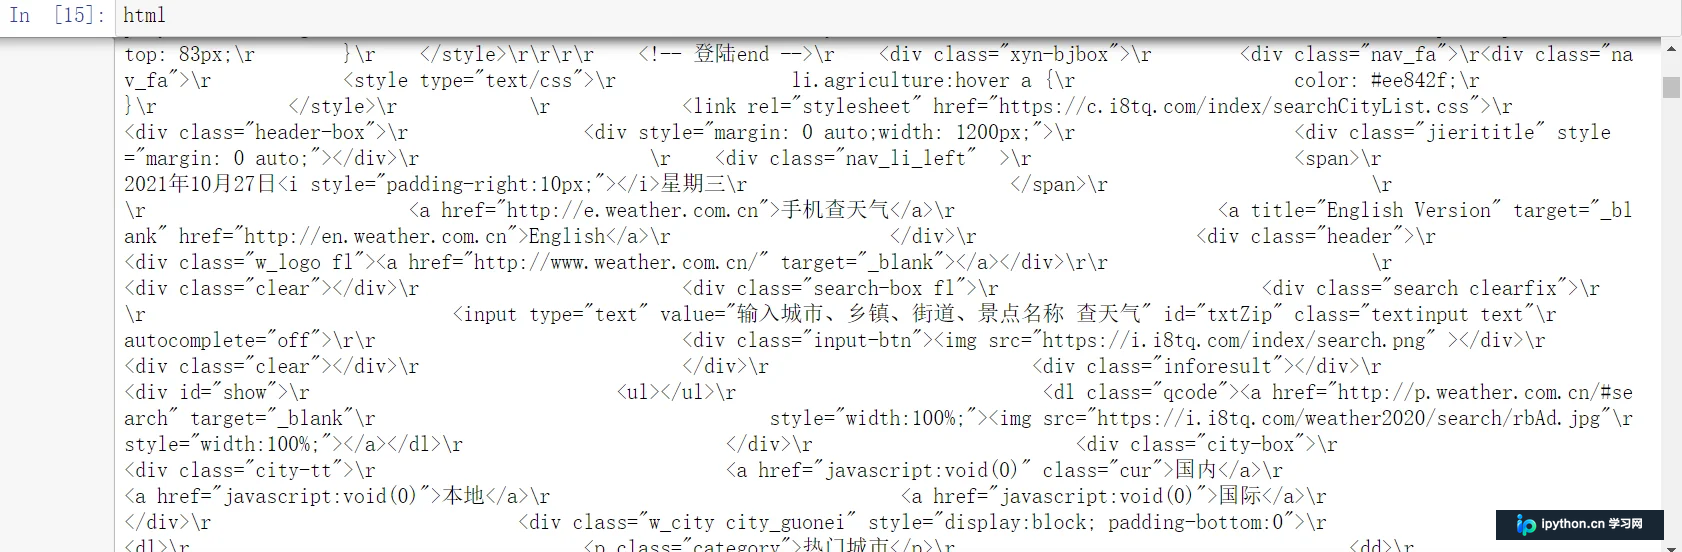
对获取的页面HTML内容进行解析,并替换其中的换行符,以便于后续使用正则表达式精准匹配图片链接。
html = r.read().decode().replace('\n','')
1.2.3 获取节点阶段
利用正则表达式先提取页面中所有的a标签,随后深入爬取这些a标签指向页面下的所有图片资源。
urlList = re.findall('<a href="(.*?)" ',html,re.S)
最终目标是获取所有符合条件的图片链接列表。
allImageList = []
for k in urlList:
    try:
        request = urllib.request.Request(k, headers=headers)
        r = urllib.request.urlopen(request)
        html = r.read().decode().replace('\n','')
        imgList = re.findall(r'<img.*?src="(.*?)"', html, re.S)
        allImageList+=imgList
    except Exception as e:
        pass
需要注意的是,上述请求过程同样适用于多线程爬取场景,因此后续代码中会补充多线程的实现逻辑。
1.2.4 数据保存(单线程模式)
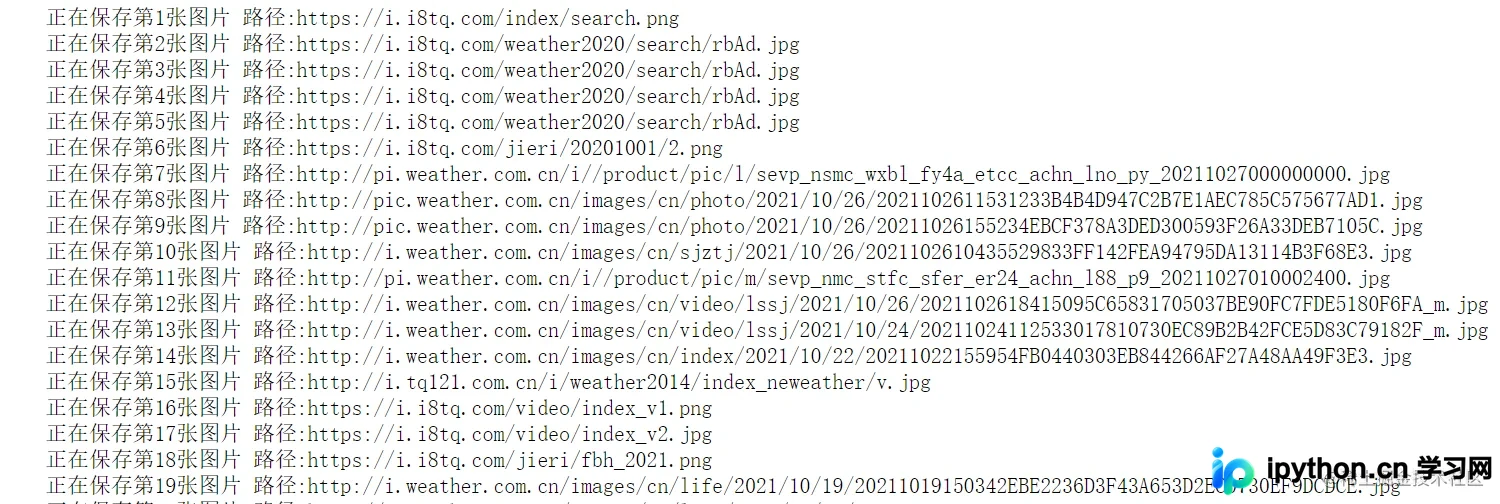
for i, img in enumerate(allImageList[:102]):
    print(f"正在保存第{i + 1}张图片 路径:{img}")
    resp = requests.get(img)
    with open(f'./image/{img.split("/")[-1]}', 'wb') as f:  # 保存到这个image路径下
        f.write(resp.content)
1.2.4 数据保存(多线程模式)
引入Python的多线程模块threading,为并发下载做准备。
import threading
# 多线程
def download_imgs(imgList,limit):
    threads = []
    T = [
        threading.Thread(target = download, args=(url,i))
        for i, url in enumerate(imgList[:limit + 1])
    ]
    for t in T:
        t.start()
        threads.append(t)
    return threads
编写具体的下载函数,处理单个图片的获取与保存逻辑。
def download(img_url,name):
    resp = requests.get(img_url)
    try:
        resp = requests.get(img_url)
        with open(f'./images/{name}.jpg', 'wb') as f:
                f.write(resp.content)
    except Exception as e:
        print(f"下载失败: {name} {img_url} -> {e}")
    else:
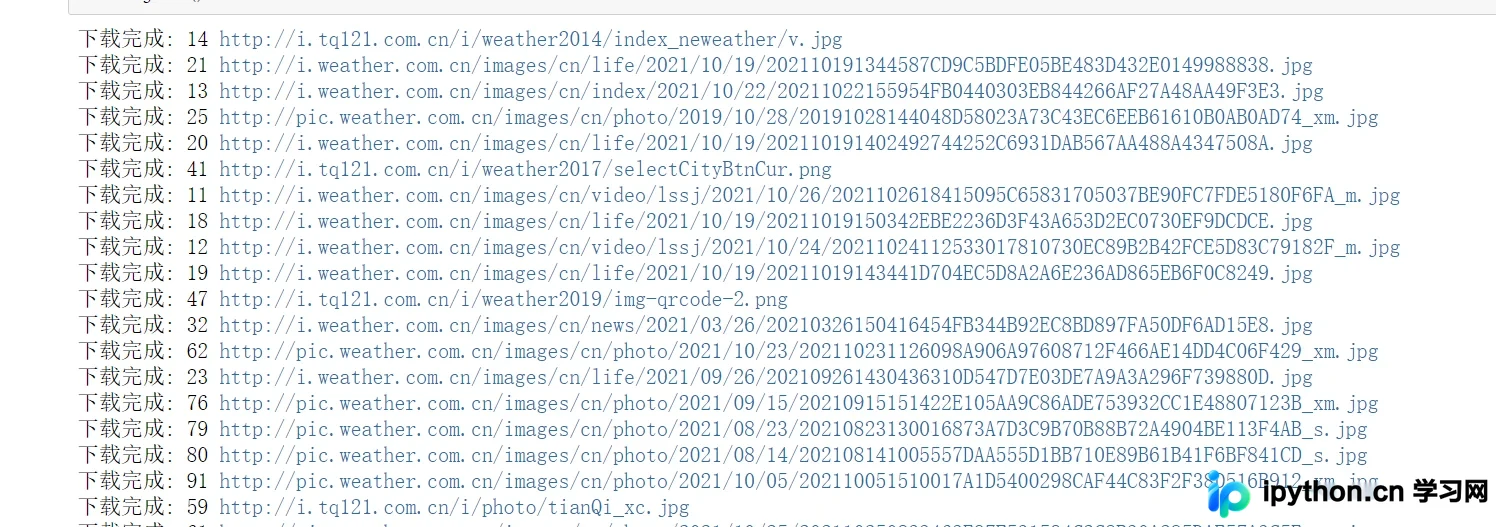
        print(f"下载完成: {name} {img_url}")
此处的实现逻辑较为随机,主要体现多线程调用的灵活性。
总结
至此,关于如何利用Python多线程爬取天气网站图片并保存的教程介绍完毕。如需了解更多Python爬取天气网站图片的相关内容,建议搜索本站历史文章或继续浏览后续文章,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















