


Python爬虫实战:使用requests模块抓取百度翻译与搜狗首页

本文详细介绍Python中requests模块的安装与基础用法,涵盖指定URL、参数处理、发起请求及数据持久化存储的完整流程。通过百度翻译POST请求案例演示UA伪装技巧,并结合搜狗首页GET请求案例,讲解如何获取网页源码并保存为本地文件,帮助开发者快速掌握网络爬虫核心技能。
requests模块简介与安装
requests模块是Python中用于处理网络请求的核心库。
作为Python原生提供的网络请求工具,它具有功能强大、接口简洁且执行效率极高的特点。
其主要作用是模拟浏览器向服务器发送HTTP请求。
需要注意的是,虽然早期版本常使用urllib模块,但requests模块在易用性和代码简洁度上更具优势,建议初学者直接学习requests模块。
requests模块编码流程
使用requests模块进行数据抓取的标准流程包括以下步骤。
第一步是确定目标网页的URL地址。
1.1 针对需要反爬机制的网站,需进行User-Agent(UA)伪装。
1.2 对请求所需的参数进行解析与封装处理。
第二步是向指定URL发起HTTP请求。
第三步是接收并解析服务器返回的响应数据。
第四步是将获取到的数据进行持久化存储,如保存为文件或数据库。
在使用前,需通过pip命令安装该模块。
执行命令:pip install requests
案例一:百度翻译POST请求爬取
案例一:通过POST请求爬取百度翻译接口数据。
具体实现代码如下:
#爬取百度翻译
#导入模块
import requests
import json

#UA伪装:将对应的User-Agent封装到一个字典中
headers = {
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) '
           'Chrome/57.0.2987.98 Safari/537.36'}

  #网页访问连接
 url='https://fanyi.baidu.com/sug'
 #处理url携带的参数:封装到字典中
word=input("input a word: ")
data={
  'kw': word
}

#请求发送
res=requests.post(url=url,data=data,headers=headers)
#获取响应数据:json()方法返回的是obj(如果确认响应数据是json类型的,才可以使用json())
dic_obj=res.json()

#持久化存储
filename=word+'.json'
fp=open(filename,'w',encoding='utf-8')
json.dump(dic_obj,fp=fp,ensure_ascii=False)

#打印完成提示
print('finish')
代码逻辑解析如下。
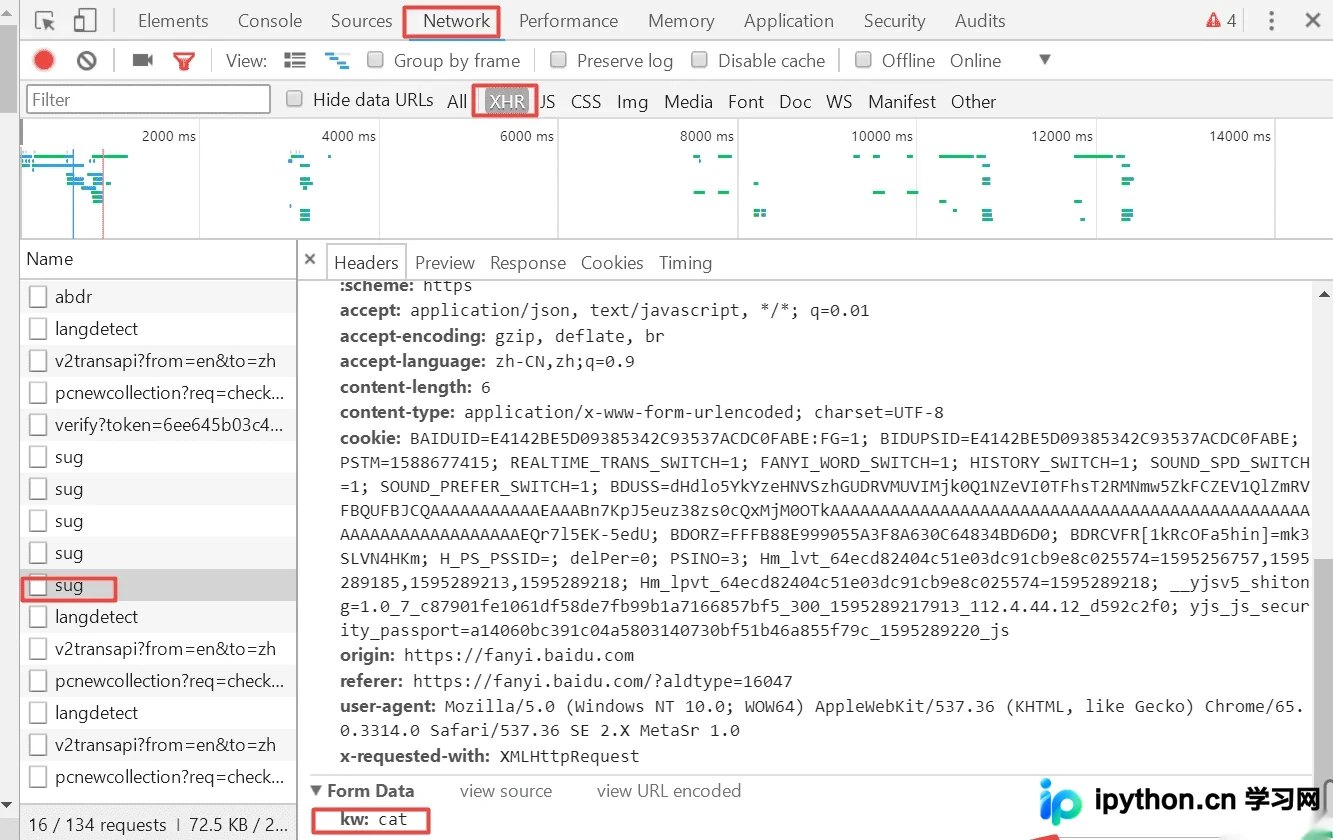
目标URL https://fanyi.baidu.com/sug 的具体位置参考下图所示。
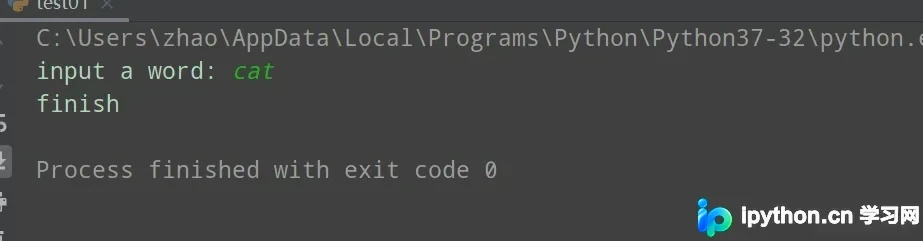
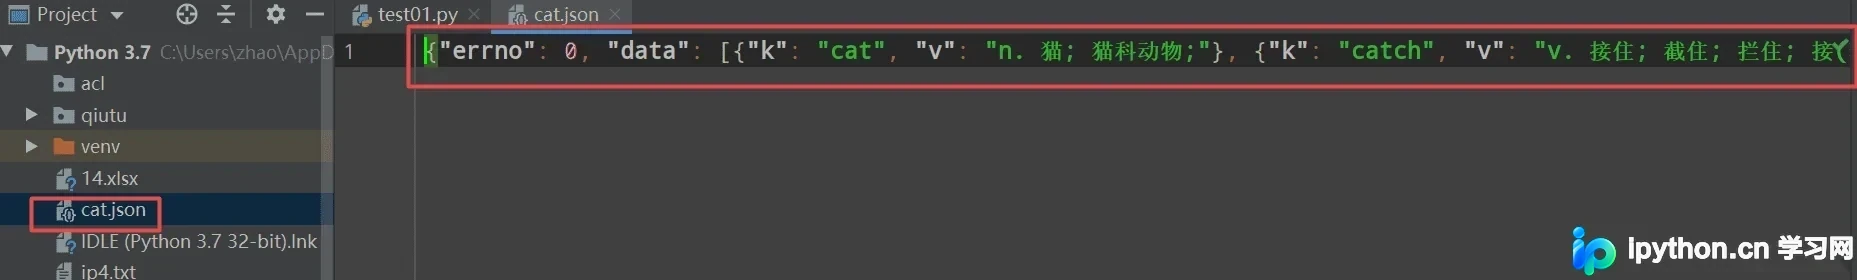
程序运行后的输出结果如下。
案例二:搜狗首页GET请求爬取
案例二:通过GET请求爬取搜狗首页页面数据。
相关实现代码如下。
import requests
if __name__ == "__main__":
  #step_1:指定url
  url = 'https://www.sogou.com/'
  #step_2:发起请求
  #get方法会返回一个响应对象
  response = requests.get(url=url)
  #step_3:获取响应数据.text返回的是字符串形式的响应数据
  page_text = response.text
  print(page_text)
  #step_4:持久化存储
  with open('./sogou.html','w',encoding='utf-8') as fp:
    fp.write(page_text)
  print('爬取数据结束!!!')
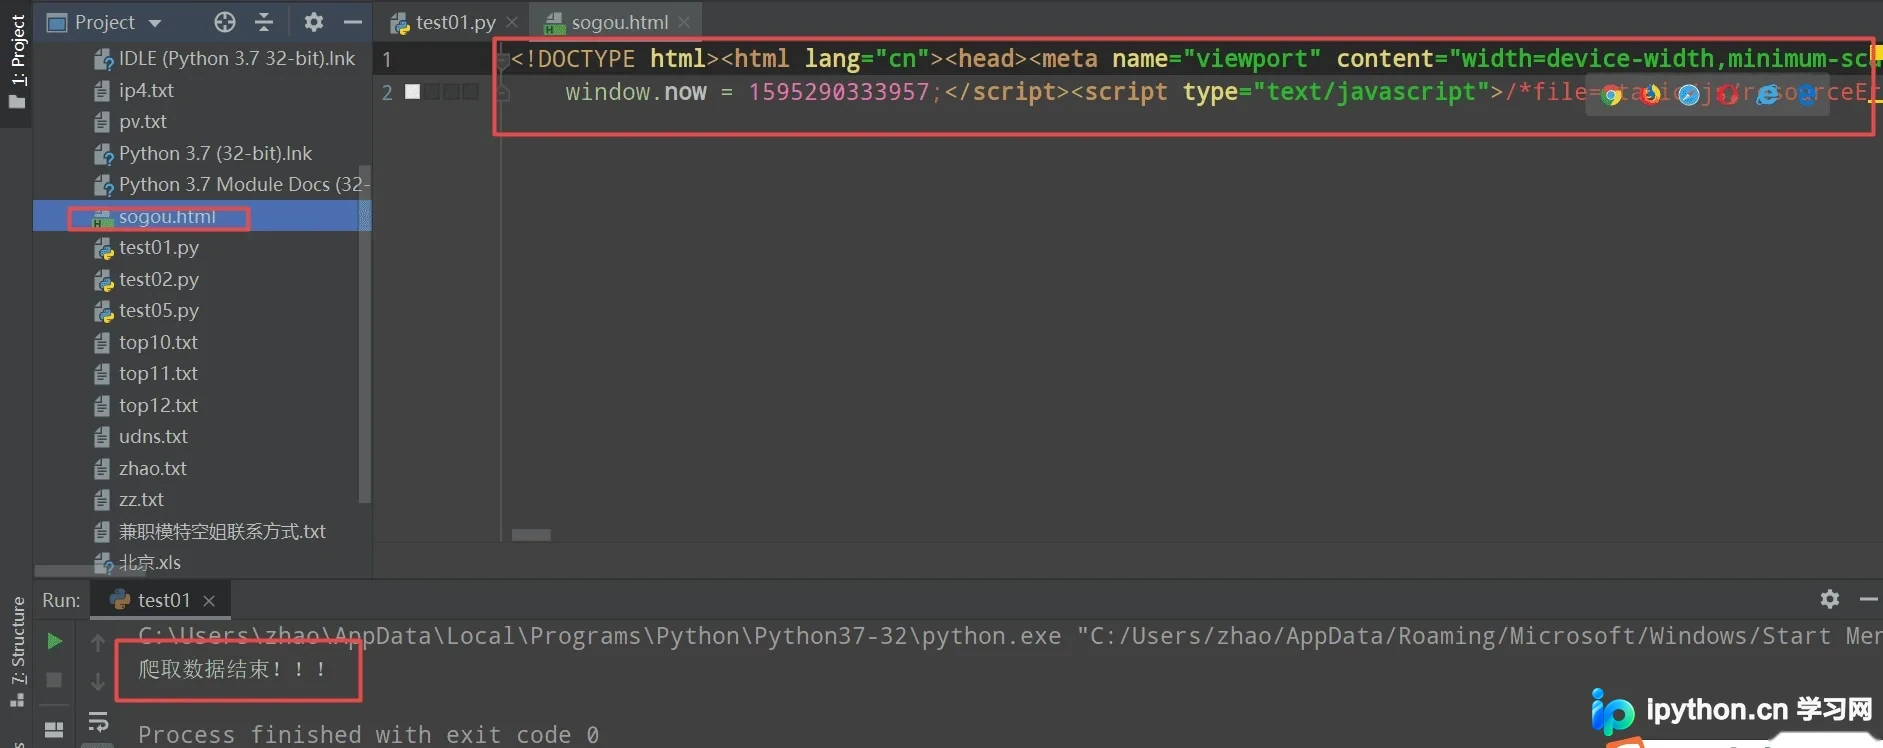
该案例的运行结果展示如下。
以上内容涵盖了requests模块的基本使用与两个典型爬虫案例,希望能为读者的学习提供有效帮助,欢迎持续关注本站获取更多技术分享。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















