


K-Means均值聚类算法原理与Python实现详解

本文详细解析K-Means均值聚类算法的核心原理,包括质心初始化、距离计算、类别分配及质心更新迭代过程。通过Python代码结合make_blobs数据集,演示如何利用scikit-learn进行聚类建模与可视化,帮助读者理解无监督学习中的特征分组逻辑。
K-Means算法基本原理
第一步:随机生成初始质心
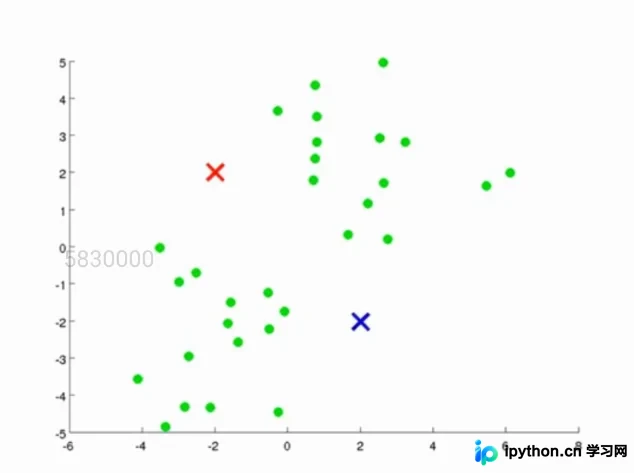
K-Means属于无监督学习算法。在二维坐标系中,我们首先随机生成一组数据点,并随机指定两个初始质心。算法的目标是根据数据点的坐标特征将其划分为两类。当数据点能够依据这两个质心被合理划分为两组时,即达到聚类效果。具体分布情况可参考下图所示:
第二步:根据距离进行分类
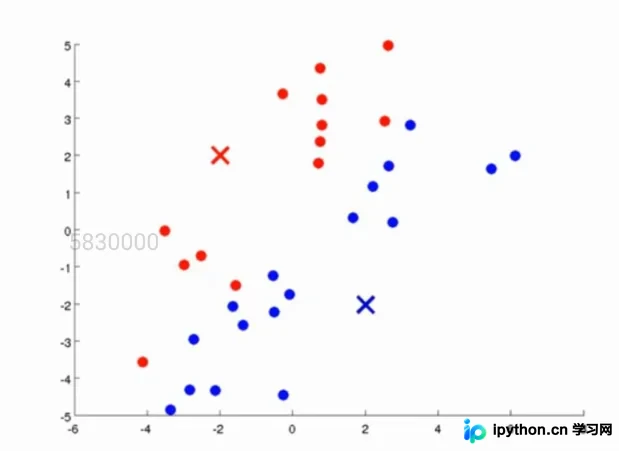
图中红色和蓝色的点代表随机选取的初始质心。为了实现将数据点分为两组且使每组点到其对应质心的距离最小,我们需要计算每个数据点到各个质心的距离。若某点距离红色质心更近,则将其归为红色类别;反之,则归为蓝色类别。分类结果如图所示:
第三步:计算同类点的均值并更新质心
在此步骤中,我们将同一类别内所有数据点的x和y坐标值分别求平均,得到该组数据的中心位置(x, y)。这个新的中心点即为更新后的质心位置。具体变化如下图所示:
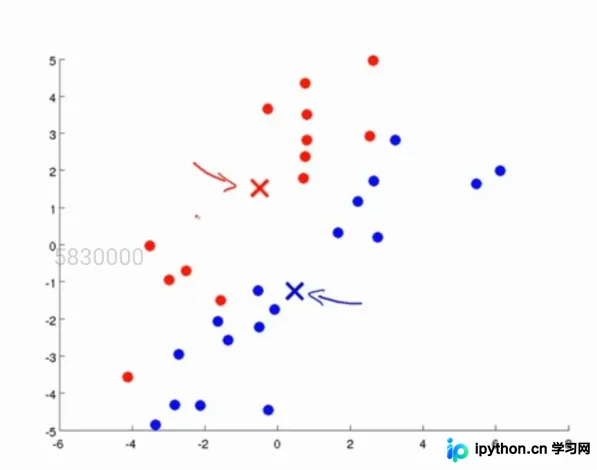
可以看到,质心的位置已经发生了移动。
第四步:重复分类与更新过程
我们重复执行第二步和第三步的操作:不断计算数据点到质心的最小距离并进行分类,随后更新质心位置。迭代过程会在达到预设的最大迭代次数(如10000次)时停止,或者当连续两次迭代的质心位置不再发生变化时提前终止。具体收敛过程如下图所示:
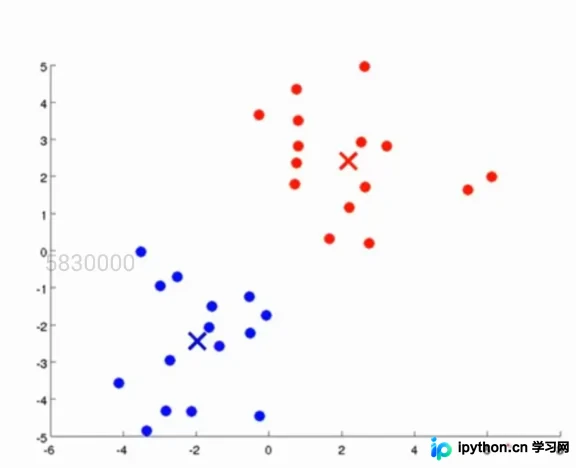
此时,我们便在没有监督标签的情况下,根据数据特征成功将其分为了两类。
五、多特征情况下的聚类实现
当面对具有多个确定特征的点时,如何计算聚类距离?这里引入一个关键概念:欧式距离(Euclidean Distance)。其定义直观且易于理解:
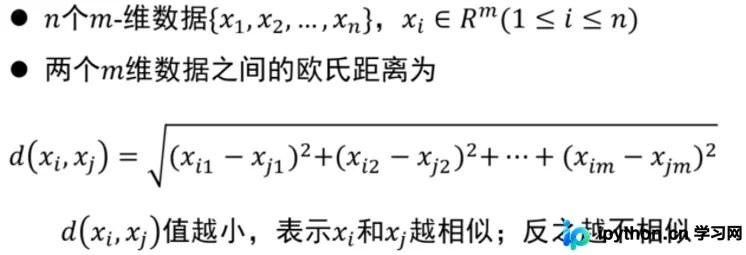
显然,欧式距离d(xi, xj)等于各维度上两点特征值之差的平方和再开根号,计算逻辑清晰明了。
我们也可以从另一个角度理解K-Means算法:即通过最小化某个点与其他点之间的方差来实现聚类目标。具体示意如下图所示:
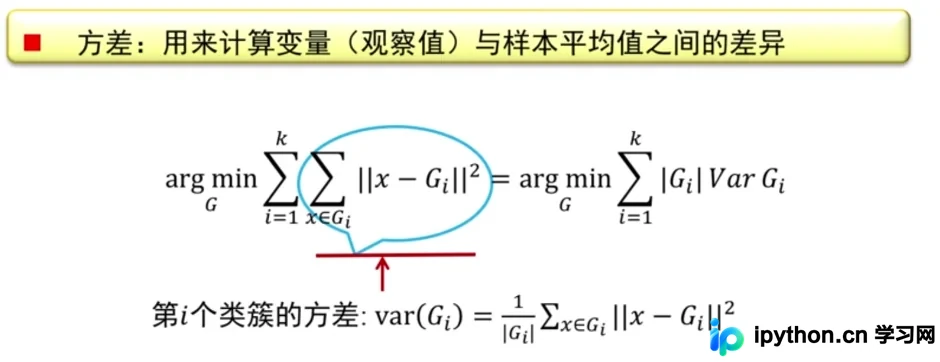
至此,原理部分得解。
Python代码实现与可视化
六:代码实现
接下来使用Python语言实现K-Means均值聚类算法。首先导入make_blobs数据集模块,并使用变量X和y接收数据。其中X表示生成的数据特征,y表示数据所属的真实类别。在实际应用中,我们通常只有X数据,而不知道真实的y标签。需要注意的是,make_blobs库要求必须同时接收这两个参数,不能仅接收X,具体代码如下:
plt.figure(figsize=(15,15))#规定我们绘图的大小为12*12

X, y=make_blobs(n_samples=1600,random_state=170)#一共取用1600个sample,同时状态设定为随机
#不知道这个状态随机是什么意思,只能查有关这个库的官方文档,同时这个数据集规定了是具备三个数据中心,也就是三个簇
y_pred=KMeans(n_clusters=3,random_state=170).fit_predict(X)

plt.subplot(221)#表示四个方格当中的第一格
plt.scatter(X[:,0],X[:,1],c=y_pred)#表示数据的第0个和第1个维度,同时数据的colour与predict的结果有关
plt.title("The result of the Kmeans")

plt.subplot(222)#表示四个方格当中的第一格
plt.scatter(X[:,0],X[:,1],c=y)
plt.title("The Real result of the Kmeans")

array=np.array([[0.60834549,-0.63667341],[-0.40887178,-0.85253229]])
lashen=np.dot(X,array)
y_pred=KMeans(n_clusters=3,random_state=170).fit_predict(lashen)

plt.subplot(223)#表示四个方格当中的第一格
plt.scatter(lashen[:,0],lashen[:,1],c=y_pred)#表示数据的第0个和第1个维度,同时数据的colour与predict的结果有关
plt.title("The Real result of the tranfored data")
在使用scatter函数绘图时,需根据数据结构编写相应代码。此处生成的X数据集包含1600行数据,每个数据点仅有两个特征(即XY轴坐标),因此X是一个二维的ndarray对象(来自numpy库)。我们可以打印查看数据构成,如下图所示:
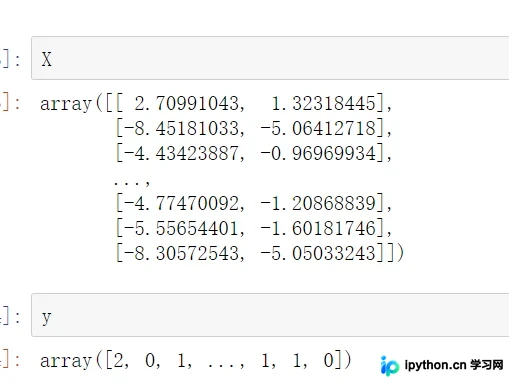
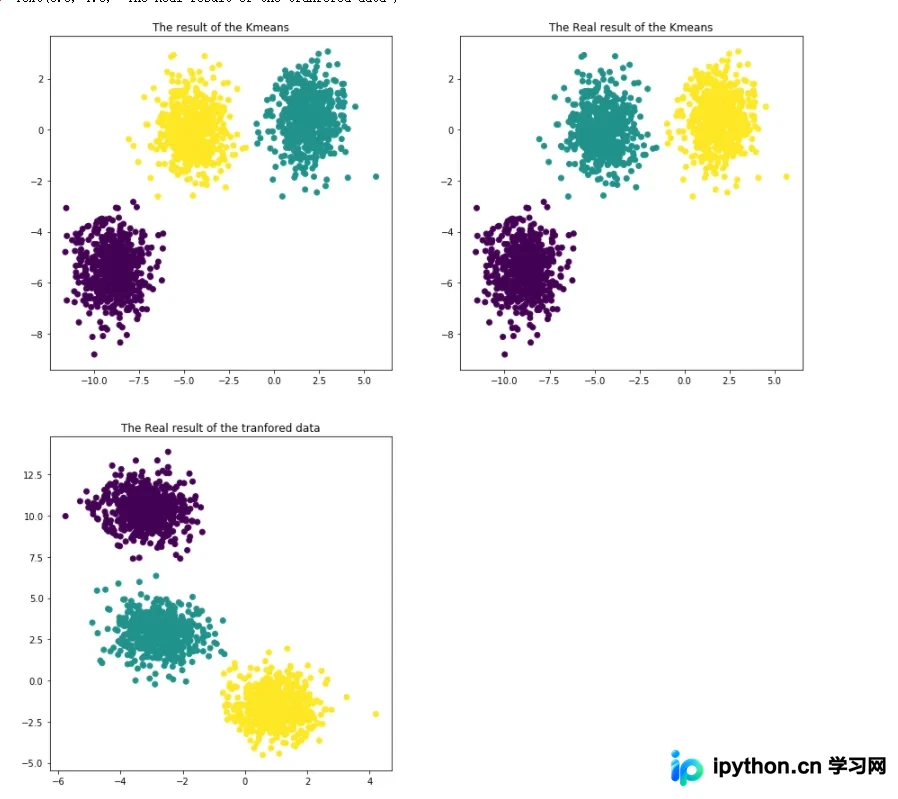
同时,y也是ndarray对象。由于在生成数据时指定了3个簇(cluster),make_blobs默认生成三个簇,因此y的值仅包含0、1、2三种可能。通过matplotlib绘图,我们可以展示分类结果,即上述代码的运行效果如下:
以上即为K-Means均值聚类算法的原理详解及Python实现方法。如需了解更多相关技术资料,请关注本站其他文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















