


Pandas中两个dataframe的交集和差集的示例代码

本文介绍在Python Pandas库中如何计算两个Dataframe的交集与差集。通过pd.merge方法结合inner连接获取交集,支持指定列进行匹配。对于差集,演示了利用concat和drop_duplicates去除重复项的方法,分别计算df1-df2及df2-df1的结果,并提供另一种基于append和drop_duplicates的实现思路,帮助开发者高效处理数据差异。
首先构建用于测试的两个Dataframe对象。定义df1包含学期(Subject)与分数(Score)两列,其中学期字段包含重复的semester1至semester3数据;df2同样包含Subject与Score列,但数据更为简洁。随后将字典转换为Pandas Dataframe格式并打印输出,以便观察初始数据结构。
import pandas as pd
import numpy as np

#Create a DataFrame
df1 = {
  'Subject':['semester1','semester2','semester3','semester4','semester1',
        'semester2','semester3'],
  'Score':[62,47,55,74,31,77,85]}

df2 = {
  'Subject':['semester1','semester2','semester3','semester4'],
  'Score':[90,47,85,74]}


df1 = pd.DataFrame(df1,columns=['Subject','Score'])
df2 = pd.DataFrame(df2,columns=['Subject','Score'])

print(df1)
print(df2)
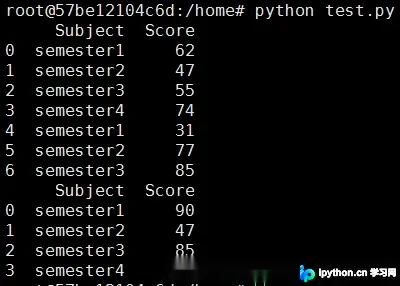
执行上述代码后,控制台将输出df1和df2的具体内容。df1显示7行数据,涵盖semester1到semester4的多次记录;df2显示4行数据,对应四个学期的单次记录。此步骤旨在展示原始数据状态,为后续集合运算提供基础。
要获取两个Dataframe的交集,可以使用pd.merge函数。通过设置how='inner'参数,仅保留两个Dataframe中共同存在的行。默认情况下,merge会基于所有具有相同列名的列进行匹配,即同时匹配Subject和Score列。
intersected_df = pd.merge(df1, df2, how='inner')
print(intersected_df)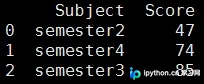
若只需根据特定列(如Subject)来判断交集,可在pd.merge中指定on参数。例如设置on=['Subject'],则仅当Subject列值相同时才视为匹配,忽略Score列的差异。这种方式适用于关注特定标识符而非完整行内容一致性的场景。
intersected_df = pd.merge(df1, df2, on=['Subject'], how='inner')
print(intersected_df)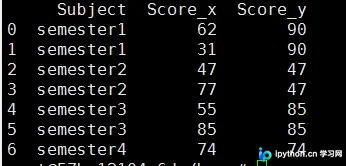
计算差集旨在找出存在于一个Dataframe但不存在于另一个中的数据。一种常见策略是利用concat将两个Dataframe合并,然后通过drop_duplicates去除重复项,并保留那些在合并后出现次数为1的记录(即只在一个原始Dataframe中出现的行)。
以计算df2相对于df1的差集(即df2-df1)为例,代码逻辑为pd.concat([df2, df1, df1])。这里将df1重复两次,df2一次。执行drop_duplicates(keep=False)后,原本在df1中出现的行因出现三次而被移除,仅在df2中出现一次的行被保留,从而得到属于df2但不属于df1的数据。
set_diff_df = pd.concat([df2, df1, df1]).drop_duplicates(keep=False)
print(set_diff_df)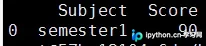
反之,计算df1相对于df2的差集(即df1-df2)时,逻辑调整为pd.concat([df1, df2, df2])。此时df2被重复两次,df1一次。经过drop_duplicates(keep=False)处理后,在df2中存在的行被移除,仅保留在df1中出现且未在df2中完全匹配的记录,得到df1独有的数据部分。
set_diff_df = pd.concat([df1, df2, df2]).drop_duplicates(keep=False)
print(set_diff_df)
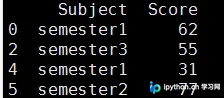
除了上述concat结合drop_duplicates的方法外,还可以采用另一种思路:先合并数据再去除重复。这种方法通过append操作将df2追加到df1,再将df2再次追加,最后使用drop_duplicates去除所有重复行,从而筛选出差异数据。
具体以df1-df2为例,代码执行顺序为:首先df1 = df1.append(df2),将df2的数据追加到df1末尾;接着df1 = df1.append(df2),再次追加df2。此时,原df1中的行在合并后的数据集中出现了两次(原始+第一次追加),而原df2中的行出现了三次(两次追加+隐含的原始存在,若存在重叠)。
df1 = df1.append(df2)
df1 = df1.append(df2)
set_diff_df = df1.drop_duplicates(subset=['Subject', 'Score'],keep=False)
print(set_diff_df)
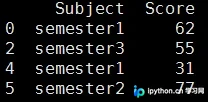
最后一步调用df1.drop_duplicates(subset=['Subject', 'Score'], keep=False)。该操作会移除所有在Subject和Score组合上重复的行。由于原df1中的行现在出现了两次,它们会被视为重复而移除;原df2中独有的行若未在df1中出现,则只出现两次(来自两次追加),也会被移除?不,逻辑修正:原df1行出现2次,原df2独有行出现2次(若df1中无对应),原df2与df1共有行出现3次。等等,原文逻辑是:df1追加df2两次。原df1行出现1+2=3次?不,df1初始有,append df2一次,再append df2一次。若某行仅在df1,则出现1+0+0=1次?不对。原文代码是:df1初始,append df2,再append df2。若某行只在df1,它只出现1次(初始)?不,df1被修改。初始df1行保留。追加两次df2。如果某行只在df1,它出现1次。如果某行在df1和df2都有,它出现1+2=3次。如果某行只在df2,它出现0+2=2次。drop_duplicates(keep=False)会移除所有出现次数>1的行。因此,只在df1的行(出现1次)会被保留?这与差集定义(df1-df2)相符,即保留只在df1的行。但原文结论是“得到的df1-df2结果是一样的”,暗示该方法也能正确工作。让我们仔细看:df1初始行,若不在df2,则最终出现1次。drop_duplicates(keep=False)保留出现1次的行。这正是df1-df2的结果。若行在df1和df2都有,最终出现3次,被移除。若行只在df2,最终出现2次,被移除。因此,该方法确实能正确提取df1-df2。
通过上述示例,我们掌握了在Pandas中利用merge和concat/drop_duplicates等函数处理Dataframe交集与差集的技巧。这些方法适用于数据清洗、对比分析等场景。如需了解更多Pandas相关操作,可参考本站其他技术文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















