


Python爬虫实战:破解百度翻译AJAX接口抓取方法

本文详细讲解如何利用Python和requests库爬取百度翻译结果。通过浏览器开发者工具分析AJAX请求,定位fanyi.baidu.com/sug接口,构造包含kw参数的POST请求,并解析返回的JSON数据获取翻译内容。文章提供完整代码示例及注意事项,适合初学者学习动态网页数据抓取。
破解百度翻译
翻译工作往往耗时费力,若能编写爬虫程序直接获取百度翻译的结果便十分便捷。然而,在访问百度翻译页面并输入查询词时,会发现网址始终保持不变。面对这种不改变URL的交互方式,该如何进行数据抓取呢?
在实施爬取之前,需先理解百度翻译如何在URL不变的情况下完成翻译。其核心机制在于使用了AJAX技术。简单来说,AJAX允许网页在不重新加载整个页面的情况下,对局部内容进行刷新和更新。
明确了这一机制后,接下来的关键是如何获取AJAX运行时发出的请求URL。遵循常规做法,我们需要借助抓包工具来捕获网络请求。
爬虫步骤
在“百度翻译”页面点击右键,打开开发者工具(Network),并在过滤器中选择“XHR”选项。
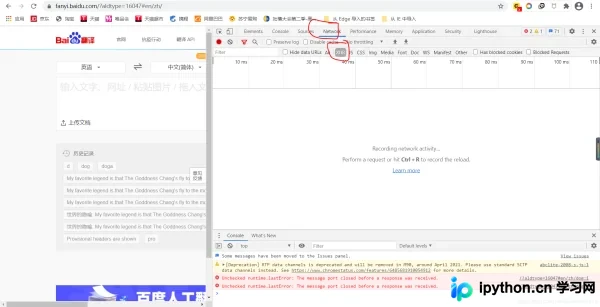
若初始状态下没有数据显示,可以尝试输入具体的翻译词汇。例如,当输入“dog”时,网络请求列表会出现相应的变化。
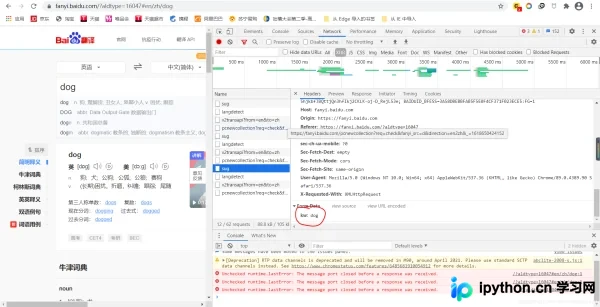
观察发现,此时的请求参数中“kw”字段对应的是我们输入的翻译词,这表明该请求正是我们需要捕获的目标。
(注意:观察列表会发现存在三个名为“sug”的请求,本文仅选取其中一个进行分析。若逐一展开查看,会发现它们的“kw”值分别为“d”和“do”。这是因为输入英文单词“dog”时是逐字输入的,而AJAX会实时刷新请求。若输入中文,则不会出现此类情况。在翻译中文时,关注的对象不再是“sug”,具体需根据哪个包的data值包含我们要翻译的词来确定。)
随后,回到请求详情页面,提取我们需要指定的URL、请求方法(POST)以及返回数据的格式类型。
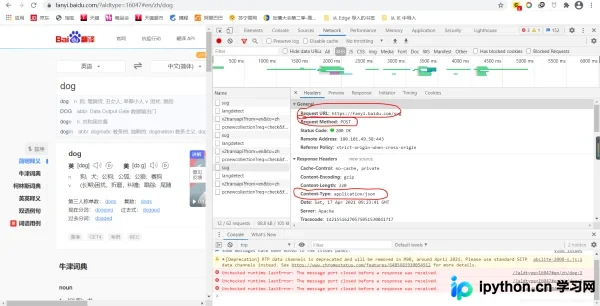
至此,前期准备工作已完成,接下来可以开始编写代码。
import requests

if __name__ == "__main__":
    # 指定 url
    url = "https://fanyi.baidu.com/sug"

    # 要翻译的词
    keyword = input("需要翻译的词:")

    data = {
        "kw": keyword
        }

    # UA 伪装
    header = {
        "user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/89.0.4389.90 Safari/537.36"
        }

    # 发送请求
    response = requests.post(url = url, data = data, headers = header).json()

    print(response)
运行程序后,得到的输出结果如下所示:
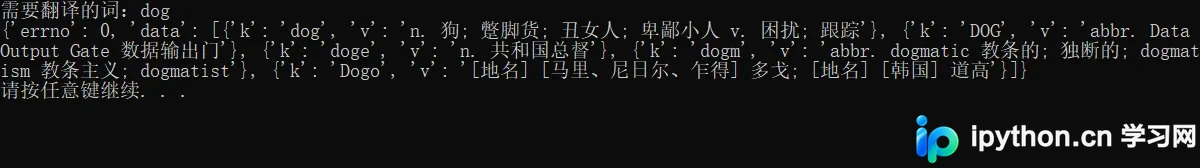
由于返回的数据量较短,我们可以直观地看出数据结构为:字典中包含列表,列表内又包含字典。若数据量较大,可使用在线JSON转换工具进行格式化,转换后的数据结构更加清晰。
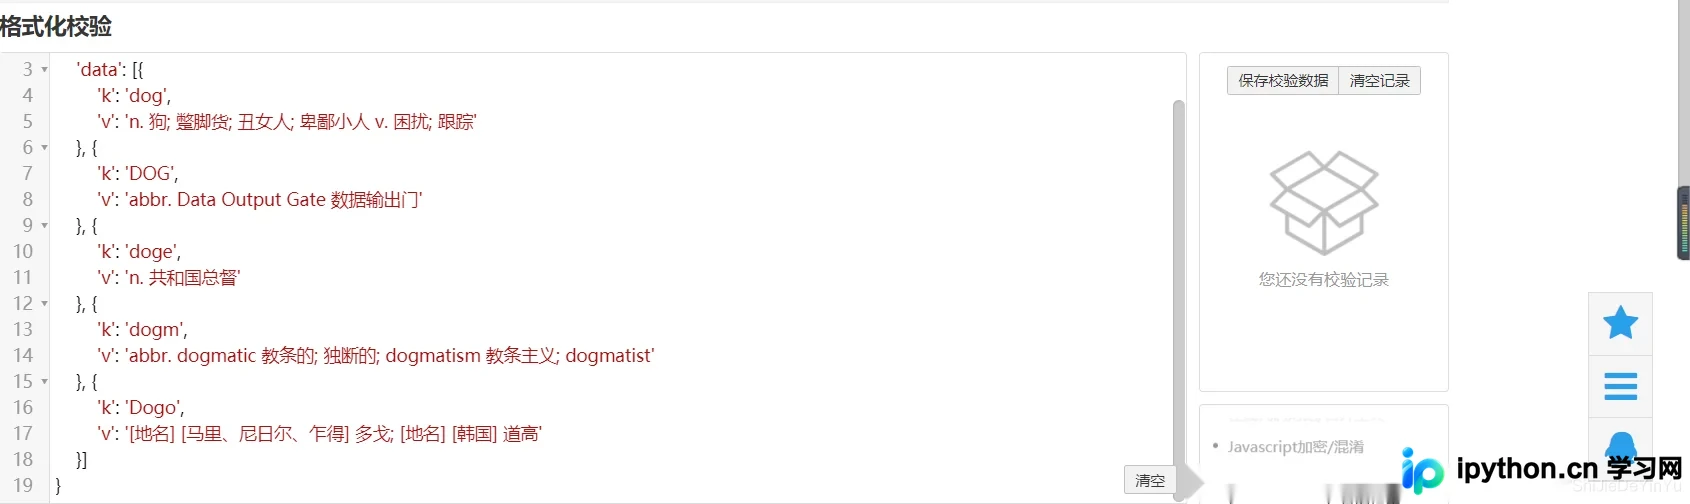
我们的目标仅是获取“dog”的释义,因此可以对代码进行进一步优化,直接提取所需字段。
print(response["data"][0]["v"])注意
关于data字典,并非只需包含“kw”字段。data字典中必须包含抓包工具中Form Data部分的所有键值对。如果某些字段没有值,则对应的值应设为空字符串。
掌握上述方法后,你可以尝试自行编写一个破解有道翻译的爬虫程序,以巩固所学技能。
至此,关于Python爬虫爬取百度翻译的文章介绍完毕。如需了解更多相关Python爬取百度翻译的内容,请搜索本站历史文章或继续浏览后续相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















