


使用AI写作助手会泄露隐私吗?数据安全与版权注意事项

在使用AI写作助手生成文案、代码或创意内容时,最核心的顾虑往往不是“它写得好不好”,而是“我发给它的内容去了哪里”。许多用户担心输入的机密商业计划、未公开的个人故事或私有代码会被模型记忆并泄露给其他用户,或者生成的內容存在版权瑕疵。
实际上,主流AI服务商通常有明确的数据处理政策,但风险依然存在,主要源于用户自身的操作习惯和对平台条款的忽视。要实现“既利用AI效率,又确保数据主权”,关键在于理解数据流向并执行严格的输入过滤。
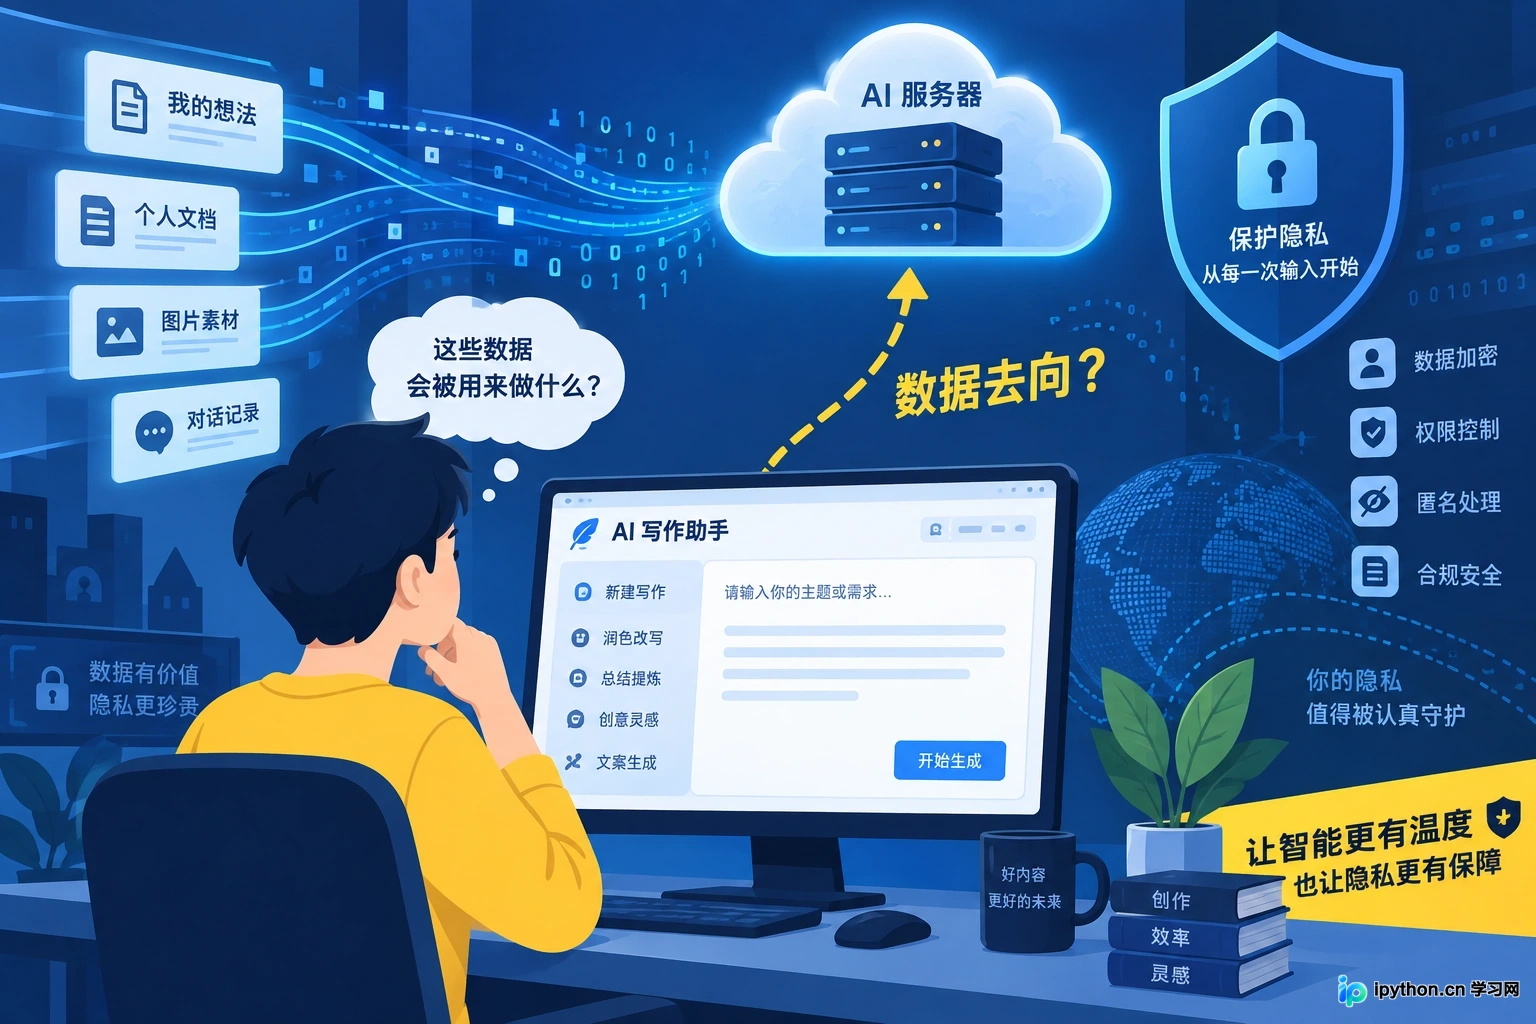
AI写作助手数据处理流程与潜在风险示意
1. 识别敏感数据边界
在打开任何AI写作窗口前,必须先对即将输入的内容进行分级。并非所有信息都适合直接粘贴进对话框。
首先,选中你要处理的文本,检查是否包含以下三类高敏信息:个人身份信息(如姓名、电话、身份证号)、企业机密(如未发布的财务数据、核心算法代码、客户名单)以及第三方受版权保护的完整作品。
如果包含上述信息,严禁直接输入。对于必须辅助润色的内部文档,应先进行脱敏处理。例如,将真实人名替换为“用户A”、“客户B”,将具体金额替换为“[金额]”,将公司名替换为“[本公司]”。
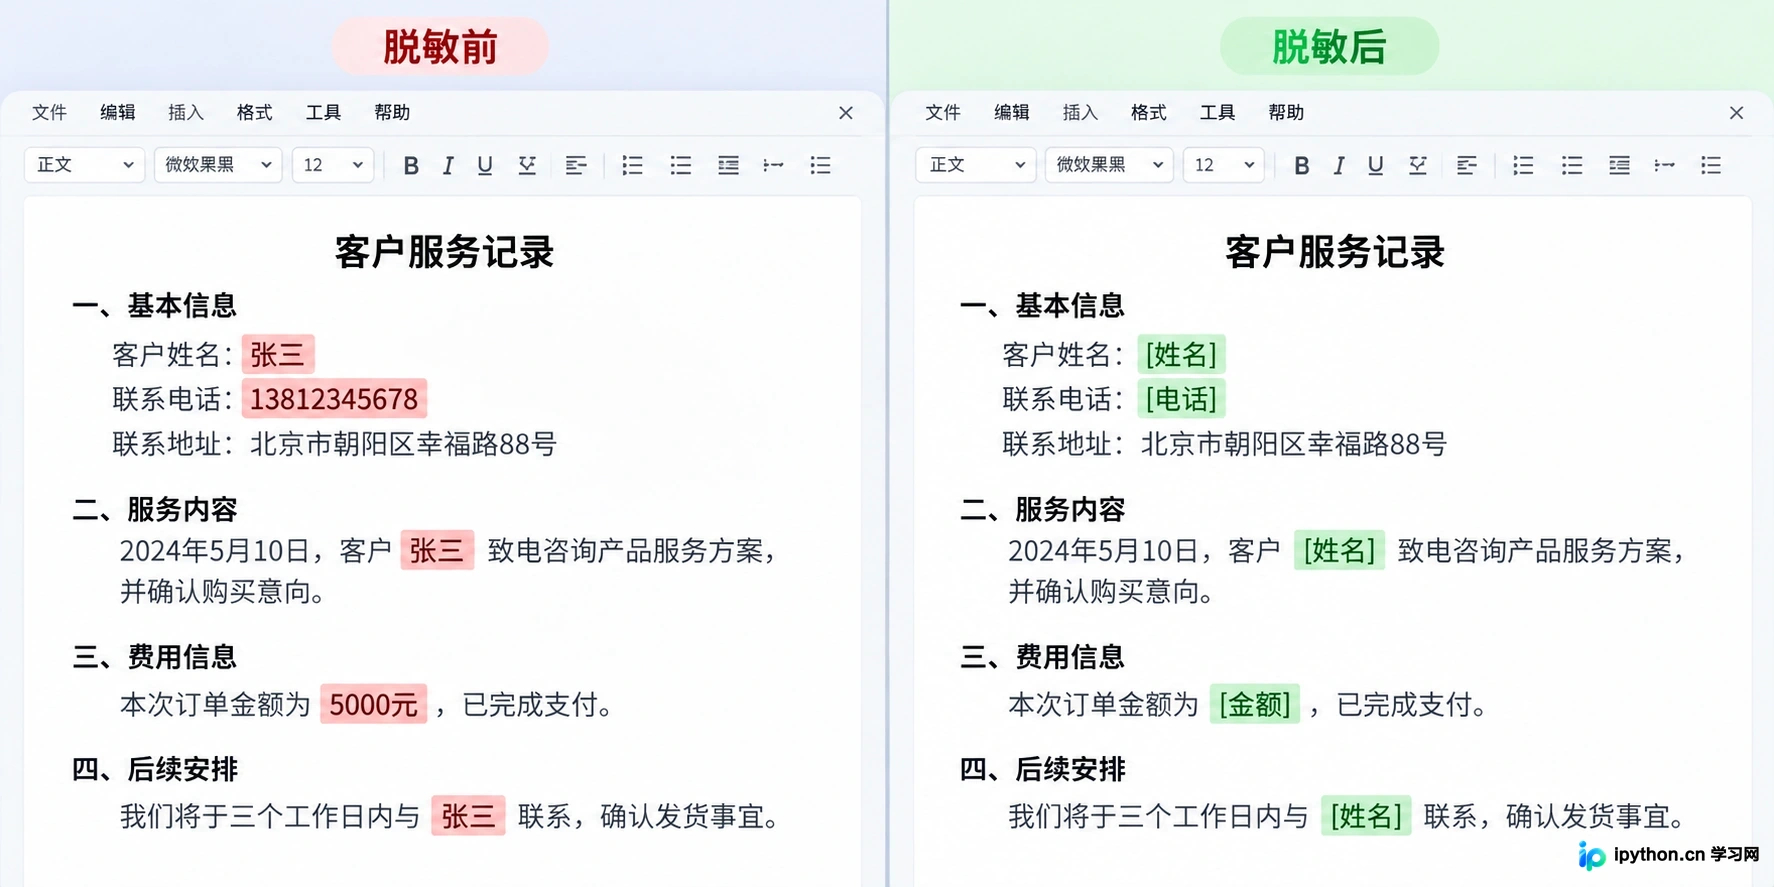
文本脱敏前后对比示例
2. 配置平台隐私设置
不同AI平台对数据的留存策略不同,大多数主流消费级AI工具默认会将对话记录用于模型训练,除非用户手动关闭。
登录你常用的AI写作平台,找到【设置】或【个人中心】。寻找类似“数据控制”、“隐私设置”或“改进模型”的选项。通常会看到一个勾选框,表述为“允许使用我的数据训练模型”或“保存聊天记录以改进体验”。
取消勾选该选项。此时,界面通常会提示“您的对话将不会被用于训练”或“聊天记录将在30天后自动删除”。这一动作能显著降低你的输入被长期存储并混入公共训练集的风险。注意,部分企业版API服务默认不保留数据,需查阅具体服务的SLA协议。
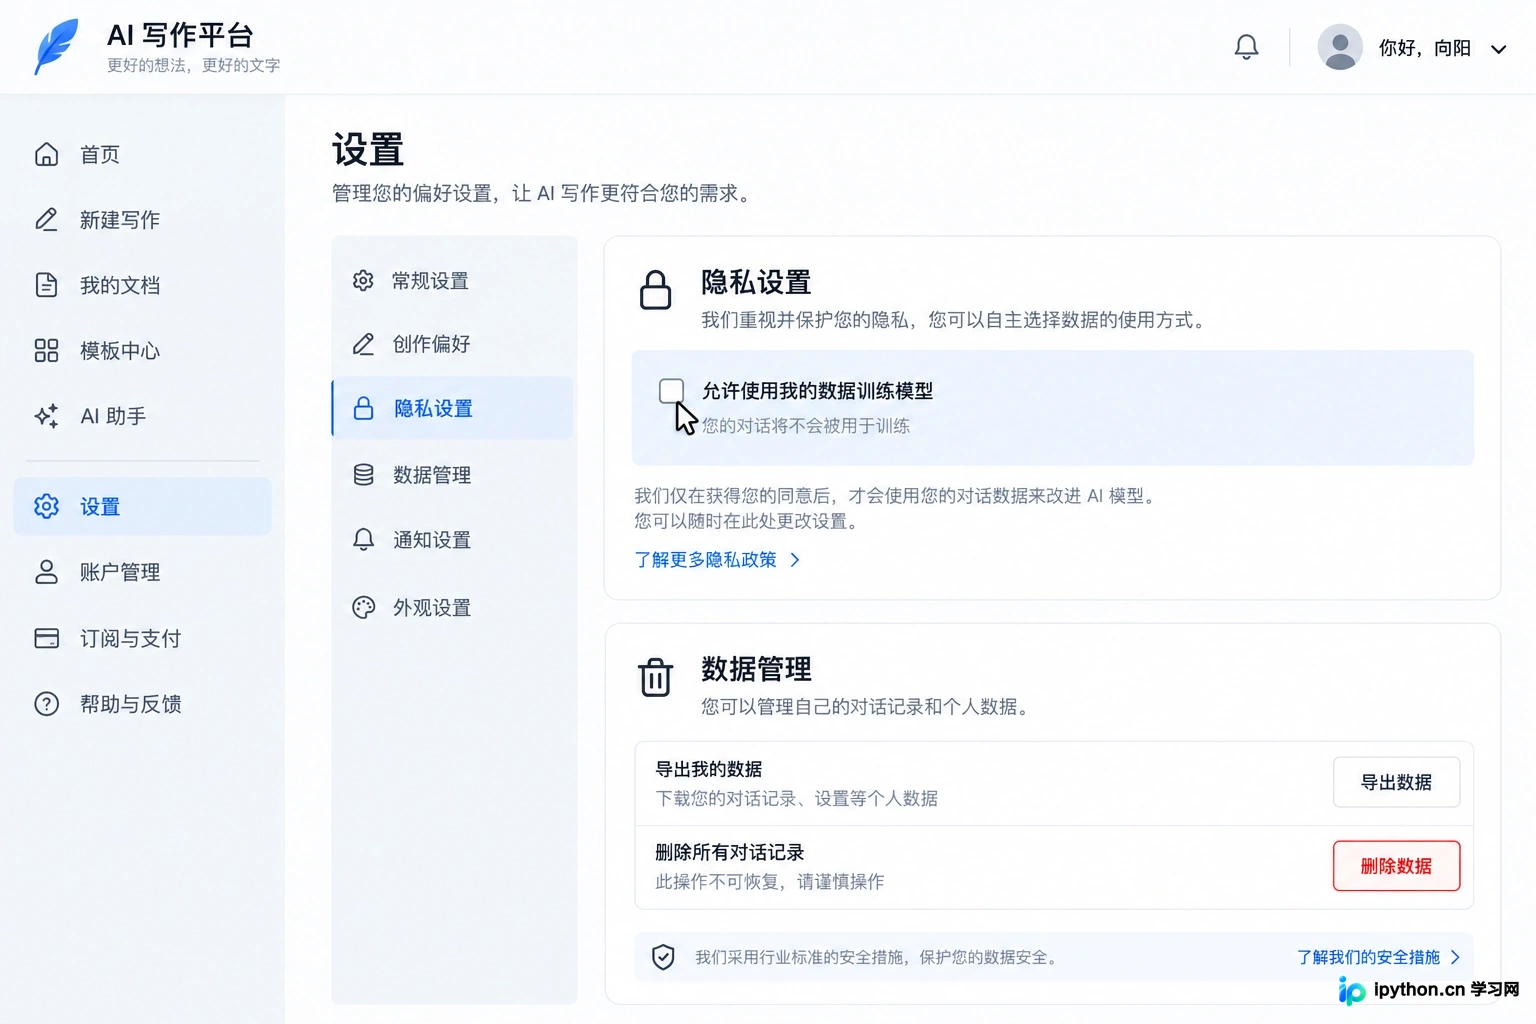
关闭数据训练选项的设置界面
3. 验证生成内容的版权归属
AI生成的内容在法律上的版权归属尚存争议,且不同司法辖区规定不同。为了避免侵权纠纷,不要直接复制AI生成的长段落作为最终发布内容。
在获得AI生成的初稿后,必须进行实质性修改。这意味着你需要重写至少30%-50%的句子结构,融入独特的个人观点、最新的事实数据或特定的品牌语调。单纯的同义词替换不足以构成新的著作权。
此外,使用AI检测工具或人工校对,确保生成内容中没有无意中复述训练数据中的受版权保护片段。如果AI引用了特定来源,务必手动核实该来源的真实性和授权状态,避免“幻觉”导致的虚假引用或侵权。
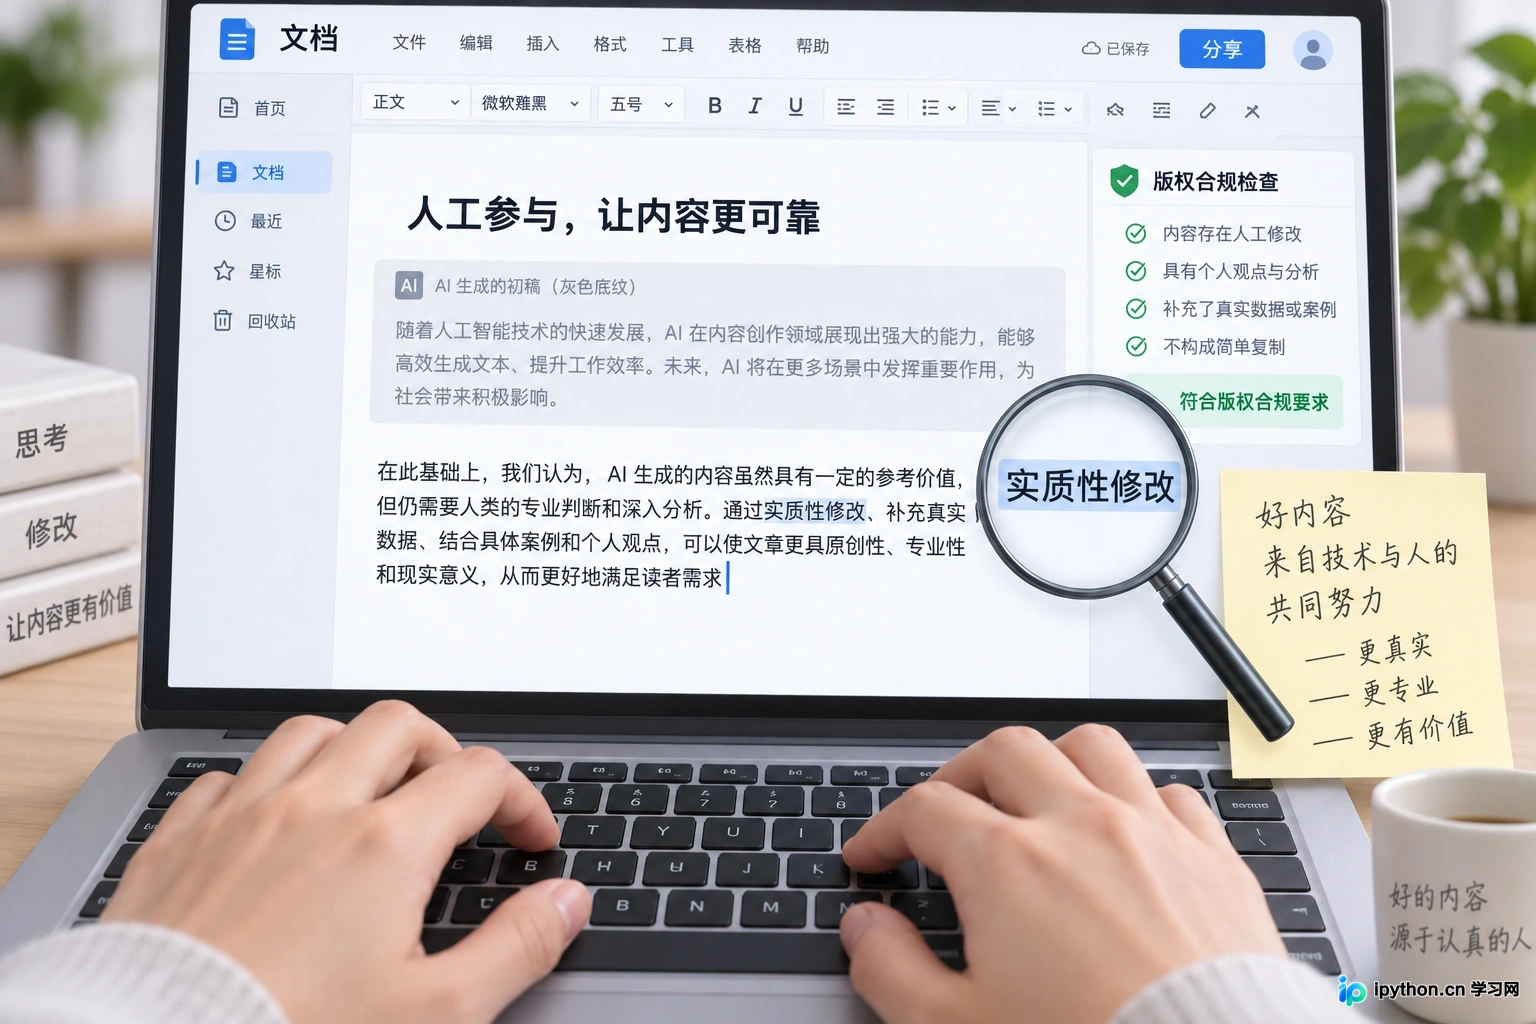
人工深度修改内容的过程
4. 建立本地化工作流
为了彻底杜绝云端泄露风险,对于极高敏感度的任务,应采用“本地隔离”的工作方式。
不要在在线对话框中处理核心机密。可以将AI仅作为“结构顾问”:询问它“请给我一个关于XX主题的写作大纲”或“这段逻辑是否有漏洞”,而不提供具体数据。待获得框架后,断开网络或在本地文档中填充具体内容。
对于代码辅助,优先使用支持本地部署的大语言模型(LLM),或使用明确声明“零数据留存”的企业级私有化部署工具。在本地环境中,数据始终停留在你的硬盘上,物理上切断了外泄路径。
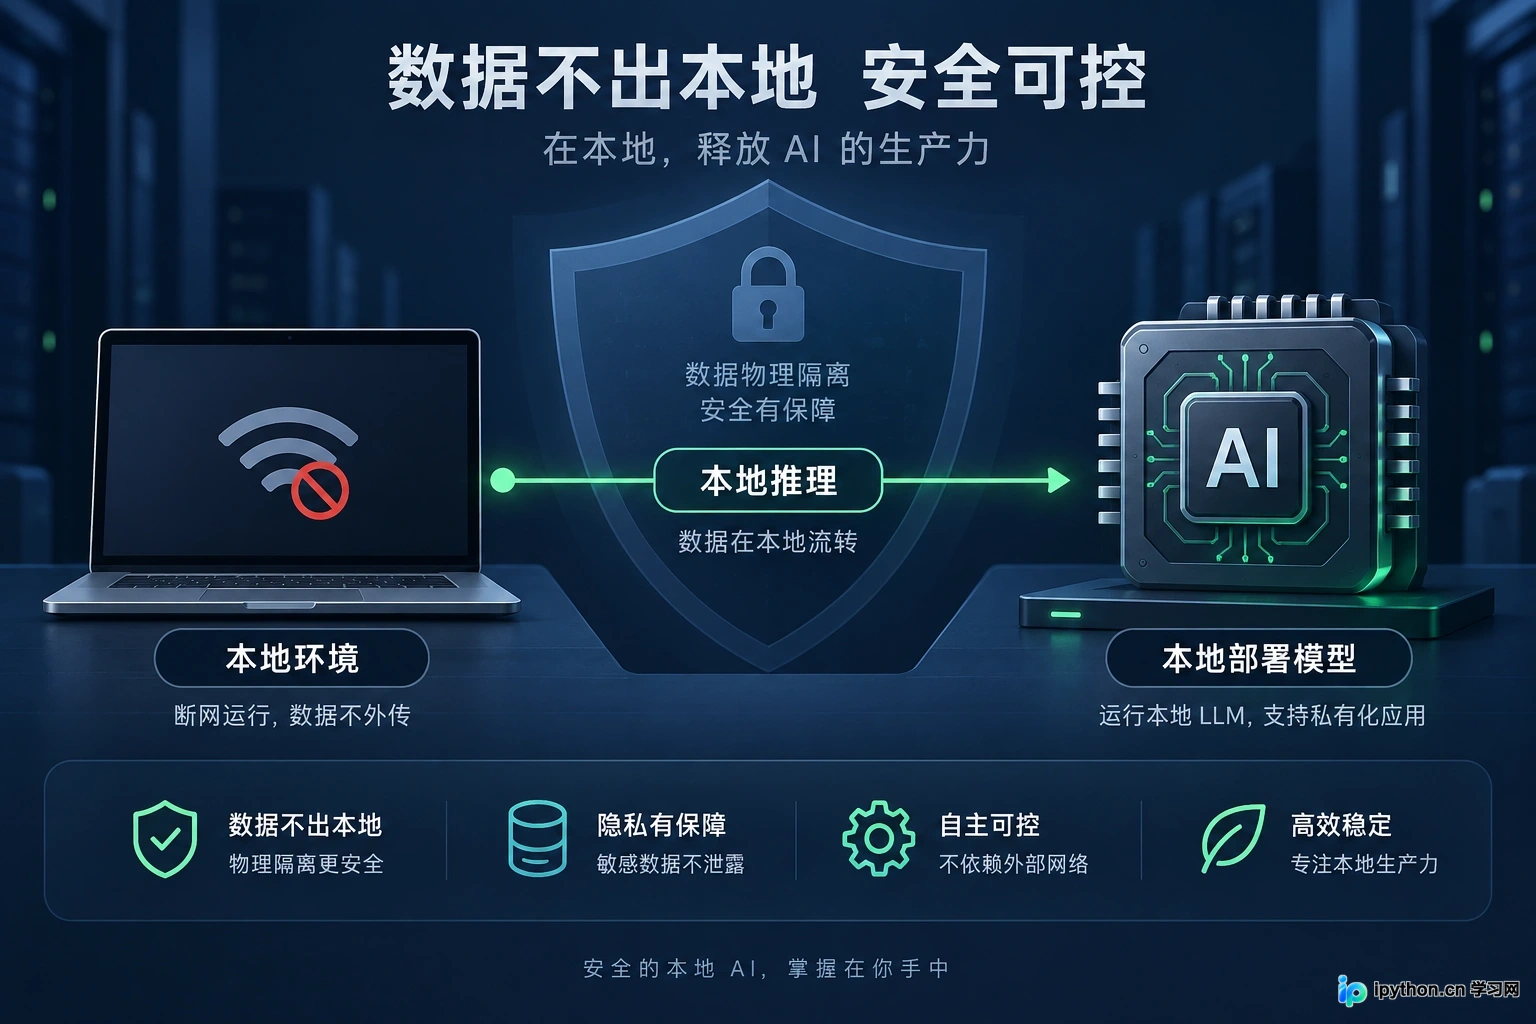
本地隔离与AI辅助结合的工作流
完成上述步骤后,你可以再次检查最终文档。确认其中不含原始敏感数据,且语言表达已具备鲜明的个人风格。此时,这份内容既享受了AI的效率红利,又在法律和隐私层面建立了足够的防火墙。保留好你的修改记录和原始脱敏版本,以备可能的版权举证之需。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















