



这两年,LLM 正在从“会对话的模型”走向“能自己判断并完成任务的 Agent”,不少开发者也开始从调用单轮接口,转向设计完整的智能体系统。但一旦离开框架包装,问题马上变得很具体:一个 Agent 到底要有哪些基本部件,哪些是概念,哪些是必须亲手落地的工程层能力?
如果把这些问题拆开看,Agent 的主线并不复杂。本文按感知、规划、工具、记忆、执行五个核心组件展开,结合 Go 里的最小实现思路解释它们分别解决什么问题、如何协作,以及判断一个 Agent 架构是否靠谱时,应该重点看哪些细节。
Agent 的基本工作循环
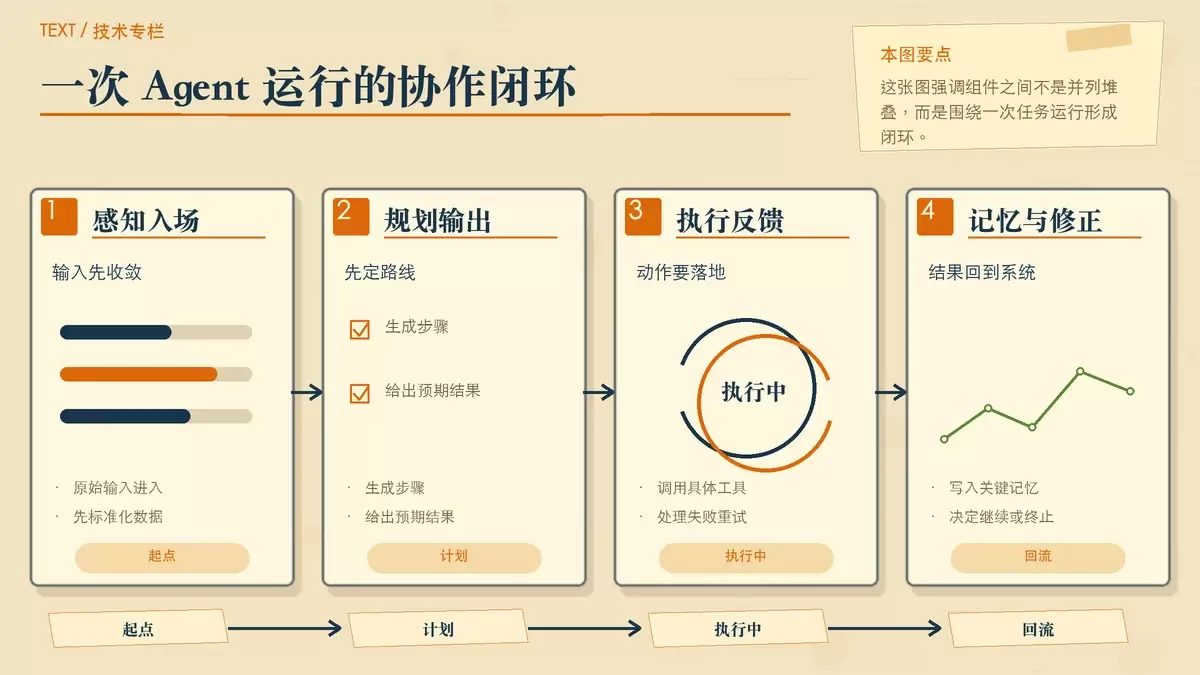
在讨论组件之前,先把 Agent 的运行方式看清楚。它本质上不是“回答一次问题”,而是一个持续迭代的闭环:接收输入、理解任务、决定动作、调用外部能力、根据结果修正判断,再把有价值的信息沉淀下来。
原文把这个过程概括为一条很清晰的链路:
感知 → 规划 → 工具调用 → 执行 → 反思 → 记忆存储如果你熟悉 Go,可以把它理解成一个持续运转的调度循环:系统不断从输入侧拿到信息,结合当前状态做决策,再把动作结果反馈回内部状态,进入下一轮。也正因为它是循环,Agent 才不只是“生成文本”,而是具备了逐步完成任务的能力。
理解这一点之后,再看下面五个组件的职责划分,会比直接记概念更容易落到实现层。
五个核心组件分别做什么
感知层:先把输入变成可处理的数据
感知层的职责,是接收并解析外部输入,包括用户问题、工具返回结果、环境状态变化,或者图片、附件这类额外信息。它解决的不是“怎么回答”,而是“系统拿到的东西能不能先被规范地读懂”。
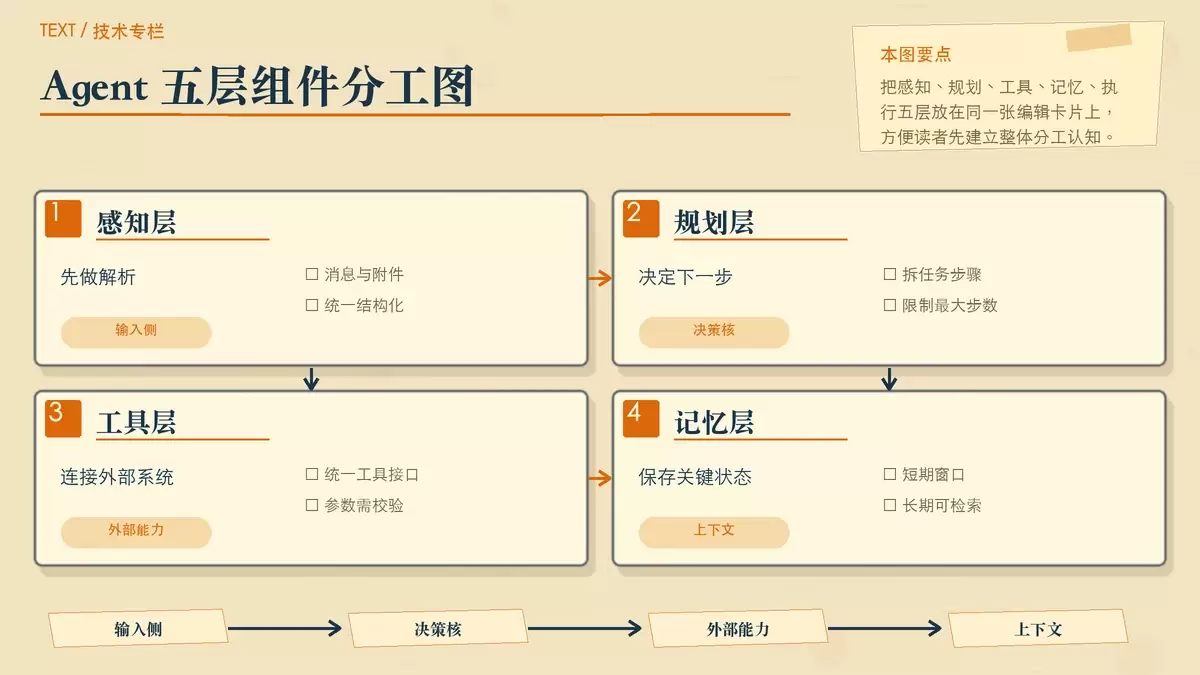
从工程角度看,这一层很像 HTTP 中间件:先做清洗、解析和标准化,再交给后续模块。好处是后面的规划层和执行层不需要直接面对杂乱原始输入,系统也更容易扩展新的输入类型。
type Perception struct {
    UserMessage  string
    Images       []string
    Attachments  []string
    Metadata     map[string]interface{}
}

func NewPerception(rawInput string) *Perception {
    return &Perception{
        UserMessage: rawInput,
        Images:      make([]string, 0),
        Attachments: make([]string, 0),
        Metadata:    make(map[string]interface{}),
    }
}
这段代码很简单,但意义很明确:无论原始输入来自聊天框、上传文件还是别的系统事件,进入 Agent 内部时都先收敛成统一结构。这样后面要支持更多模态,通常只需要补解析逻辑,而不是重写整个 Agent。
规划层:决定下一步该做什么
规划层是 Agent 的决策中枢。它负责分析当前任务、制定执行计划,并在执行过程中根据反馈调整策略。很多人把 Agent 理解成“模型+工具”,但如果没有规划层,系统往往只能机械地调用工具,很难稳定完成复杂任务。
原文提到规划层里至少有三项关键能力:
- 任务拆解:把复杂目标拆成可执行子任务,例如“分析销售数据并生成报告”可以分成获取数据、分析趋势、生成报告。
- 推理引擎:结合上下文、可用工具和当前状态,判断下一步应该采取什么动作。
- 自我反思:发现结果不符合预期时,主动修正策略,而不是沿着错误路径一直走下去。
type Planner struct {
    llm      LLMClient
    tools    []Tool
    maxSteps int
}

type Plan struct {
    Steps       []Step
    CurrentStep int
}

type Step struct {
    Action, Tool string
    Input        map[string]interface{}
    Expected     string
}

func (p *Planner) CreatePlan(ctx context.Context, task string) (*Plan, error) {
    // 遍历 p.tools 构建工具描述列表,拼装 prompt 并限制最大步数
    // response, err := p.llm.Chat(ctx, prompt)
    // return parsePlan(response), nil
    return nil, nil // 省略具体实现
}
这里有两个非常关键的工程约束不能省。第一是 maxSteps 之类的最大步数限制,原文建议例如 10 步,这类限制直接关系到系统会不会因为模型误判进入死循环。第二是每一步都要带上明确的 Expected 预期结果,否则执行完之后,系统很难判断这一步到底算成功、失败,还是需要重试。
工具层:把语言能力接到外部世界
LLM 本身擅长理解和生成,但真正让 Agent 能做事的,是工具层。它为系统提供统一的外部能力接口,让 Agent 可以搜索、查数据库、调用 API、执行代码、操作文件,甚至触发业务流程。
这一层最重要的不是“工具越多越强”,而是接口要稳定、参数要明确、返回值要结构化。只有这样,规划层才能可靠地选择工具,执行层也才能有机会做重试和错误恢复。
type Tool interface {
    Name() string
    Description() string
    Parameters() map[string]Parameter
    Execute(ctx context.Context, params map[string]interface{}) (*Result, error)
}

type WebSearchTool struct { apiKey string }

// Name() 返回 "web_search",Description() 返回工具描述
// Parameters() 返回 {"query": {Type: "string", Required: true}}

func (w *WebSearchTool) Execute(ctx context.Context, params map[string]interface{}) (*Result, error) {
    query, ok := params["query"].(string)
    if !ok {
        return nil, fmt.Errorf("missing or invalid parameter: query")
    }
    // 调用搜索API并返回结构化结果...
    return &Result{Content: "搜索结果..."}, nil
}
这个接口设计很符合 Go 的习惯:通过接口定义统一契约,不同工具按同一协议注册和调用。对 Go 开发者来说,这一层天然适合做成插件式扩展。真正需要注意的点有两个:一是参数校验不能完全交给模型,二是工具权限边界必须清晰,尤其涉及数据库写入、文件删除、代码执行时,安全控制不能省略。
记忆层:让 Agent 不只会“当前这一步”
如果没有记忆,Agent 每一轮都像刚启动一样,只能依赖眼前输入。记忆层解决的是上下文连续性和知识沉淀问题,让系统既能记住当前会话,也能保留长期有价值的信息。
原文把记忆分成两类,这个划分很实用:
- 短期记忆:保存当前对话过程中的历史消息、回复和中间状态,生命周期短,但访问频繁。
- 长期记忆:保存用户偏好、领域知识、工作流程、历史经验等需要持久化的信息,通常依赖数据库或向量检索。
type Memory struct {
    shortTerm *ShortTermMemory
    longTerm  *LongTermMemory
    embedding EmbeddingClient
}

type ShortTermMemory struct {
    messages []Message
    maxSize  int
}

type LongTermMemory struct {
    facts, procedures []Fact
    db                *gorm.DB
}

func (m *Memory) AddMessage(msg Message) {
    m.shortTerm.messages = append(m.shortTerm.messages, msg)
    if len(m.shortTerm.messages) > m.shortTerm.maxSize {
        copy(m.shortTerm.messages, m.shortTerm.messages[1:])
        m.shortTerm.messages = m.shortTerm.messages[:len(m.shortTerm.messages)-1]
    }
}

// SaveImportantFact 先写数据库成功后再更新内存,保证状态一致性
这段实现里有一个很值得注意的细节:短期记忆通过 maxSize 做窗口控制,避免上下文无限增长;而长期记忆的注释则强调“先写数据库成功后再更新内存”,这是典型的状态一致性问题。很多 Agent Demo 容易忽略这类细节,但到了生产环境,记忆写入失败、检索粒度过粗或过细,都会直接影响系统稳定性和回答质量。
执行层:把计划真正跑起来
规划层负责想,执行层负责把计划一步步落实。它需要接收动作指令、调用对应工具、处理失败和重试、记录结果,并把执行反馈再交回规划层,让系统决定下一步怎么走。
执行层真正考验的是工程能力,而不是概念表达。因为只要进入真实环境,就一定会遇到超时、依赖失败、部分成功、上下文取消等问题。
type Executor struct {
    tools    map[string]Tool
    retryMax int
}

type Action struct {
    ToolName string
    Params   map[string]interface{}
}

type ExecutionResult struct {
    Action   Action
    Success  bool
    Output   string
    Error    error
    Duration time.Duration
}

func (e *Executor) Execute(ctx context.Context, action Action) (*ExecutionResult, error) {
    tool, ok := e.tools[action.ToolName]
    if !ok {
        return nil, fmt.Errorf("unknown tool: %s", action.ToolName)
    }
    // 循环重试:调用 tool.Execute(),失败时使用 select+timer 监听 ctx.Done()
    // 成功则返回 ExecutionResult{Success: true, Output: result.Content}
    return nil, nil // 省略具体实现
}
原文点到的三个关键词很重要:执行原子性、部分失败处理、重试机制。简单说,就是每一步要尽量边界清晰、失败可识别、恢复有策略。比如调用第三方 API 时,是否允许幂等重试;文件操作失败后是否需要补偿;用户主动取消时,是否能通过 context 及时终止,这些都属于执行层必须兜住的事。
五个组件如何组装成一个完整 Agent
单看每个模块都不难,真正的问题在于它们怎么接起来。原文给出了一份最小化的 Agent 结构:
type Agent struct {
    name       string
    perception *Perception
    planner    *Planner
    executor   *Executor
    memory     *Memory
    llm        LLMClient
}

func (a *Agent) Run(ctx context.Context, input string) (string, error) {
    perc := NewPerception(input) // 1. 感知阶段
    plan, err := a.planner.CreatePlan(ctx, perc.UserMessage) // 2. 规划阶段
    if err != nil {
        return "", fmt.Errorf("plan creation failed: %w", err)
    }
    // 3. 执行循环:遍历 plan.Steps,选择工具并执行,结果存入记忆
    // 4. 调用 a.generateResponse(ctx) 生成最终响应
    return "", nil // 省略具体实现
}
这段代码把主流程压缩得很直接:先感知输入,再生成计划,接着执行步骤、写入记忆,最后输出结果。也就是说,五个组件并不是并列摆设,而是在一次运行里承担不同环节的责任。
如果把这个流程进一步展开,可以得到一条更贴近工程实践的协作链:
- 感知层把原始输入标准化,避免后续模块反复处理脏数据。
- 规划层根据任务、上下文和工具描述生成步骤,并设定预期结果。
- 执行层按步骤调用工具,处理成功、失败、重试和取消。
- 记忆层记录关键中间结果,为下一步推理提供上下文。
- 规划层根据执行反馈决定继续、修正还是终止。
到了生产环境,还要补上一些横切能力。原文提到并发控制、超时处理、错误恢复、日志记录,这些都不是“可选优化”,而是决定系统能否稳定上线的基础设施。尤其在 Go 里,goroutine、channel 和 context 的组合,天然适合做这类可取消、可并发、可追踪的执行流设计。
看懂底层之后,再看主流框架
理解五个组件之后,再去看框架,视角会完全不同。你不会只关心“这个框架能不能做 Agent”,而会更清楚它在规划、工具抽象、记忆管理和执行控制上分别帮你做了什么,又隐藏了什么。
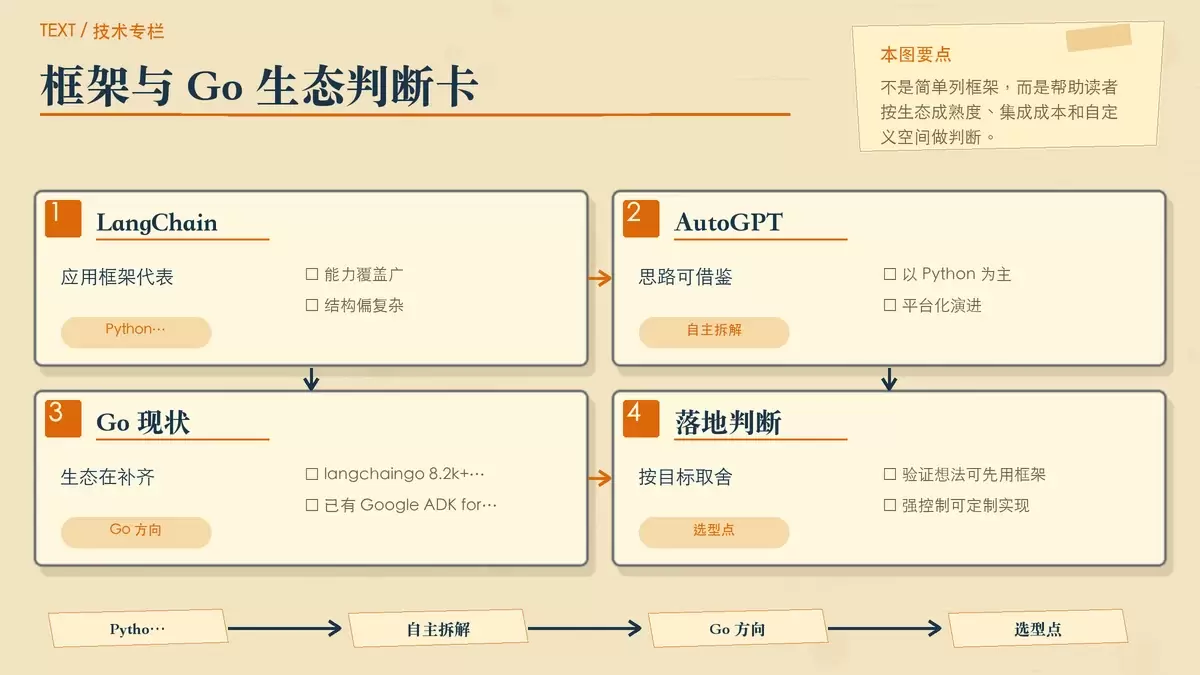
原文列了几个代表性方向:
- LangChain:较早被广泛使用的 LLM 应用开发框架之一,包含 Agent 能力,但整体设计偏复杂,而且主要面向 Python 生态,对 Go 开发者来说集成成本相对更高。
- AutoGPT:以 Python 为主的多语言项目,包含 TypeScript 等实现,以自主任务分解能力出名,后来逐步演化为更完整的平台,其思路仍然值得借鉴。
- Go 生态:目前也在快速补齐,已有 langchaingo(8.2k+ Stars) 和 Google ADK for Go(Google 官方 Agent Development Kit)等项目。和 Python 生态相比还有差距,但也意味着设计空间仍然很大。
这里的关键判断不是“该不该自己从零写”,而是你要做的系统复杂度和可控性需求在哪里。如果只是验证想法,直接用现成框架通常更快;如果要做强约束、强集成、强调并发与控制边界的业务系统,那么理解底层组件后再定制实现,会更符合 Go 的工程风格。
真正难点不在概念,而在工程取舍
回到最初的问题,一个 Agent 有哪些核心组件?答案并不复杂:感知层负责接收和整理输入,规划层负责判断和拆解任务,工具层负责接入外部能力,记忆层负责保存上下文与经验,执行层负责把动作跑通并处理失败。
真正拉开差距的,从来不是能不能说出这五层,而是每一层做到什么程度。比如记忆检索的粒度怎么定,工具调用的安全边界怎么收,规划层的步数限制如何设置,执行层的重试策略如何避免放大错误,这些细节决定了 Agent 是一个能演示的 Demo,还是一个能进入生产环境的系统。
对 Go 开发者来说,这条路线并不陌生。接口适合定义工具契约,goroutine 和 channel 适合组织并发执行,context 很适合承载取消和超时语义。随着 langchaingo、Google ADK for Go 等项目逐渐成熟,Go 在 Agent 生态里的角色也在从“可以做”走向“值得优先考虑”。
所以,理解 Agent 架构的价值,不是为了追逐下一个新框架,而是为了在面对框架、协议和实现方案时,知道哪些部分必须掌握,哪些地方可以借助现成能力,哪些工程约束绝对不能省。把这五个组件想清楚,基本就搭起了 Agent 系统的骨架。















