


pandas DataFrame 行列选取、条件过滤与值替换详解

本文详细介绍在 pandas 中如何高效处理 DataFrame 数据。涵盖按列、索引及特定行列的选取方法,包括 loc、iloc 等核心属性;讲解基于单一或多条件的行记录筛选技巧;演示将分类变量如性别进行数值替换的两种常用方式;最后提供删除特定条件行的操作示例,帮助开发者快速掌握数据预处理关键步骤。
pandas DataFrame 行列选取基础
在 pandas 中,对 DataFrame 进行行列选取是基础且高频的操作。我们可以按列名提取单列或多列,也可以基于索引(行标签)或位置(数字索引)来选取特定的行。此外,通过组合行列索引,可以精确获取数据子集。
import numpy as np
from pandas import DataFrame
import pandas as pd


df=DataFrame(np.arange(12).reshape((3,4)),index=['one','two','thr'],columns=list('abcd'))

df['a']#取a列
df[['a','b']]#取a、b列

#ix可以用数字索引,也可以用index和column索引
df.ix[0]#取第0行
df.ix[0:1]#取第0行
df.ix['one':'two']#取one、two行
df.ix[0:2,0]#取第0、1行,第0列
df.ix[0:1,'a']#取第0行,a列
df.ix[0:2,'a':'c']#取第0、1行,abc列
df.ix['one':'two','a':'c']#取one、two行,abc列
df.ix[0:2,0:1]#取第0、1行,第0列
df.ix[0:2,0:2]#取第0、1行,第0、1列

#loc只能通过index和columns来取,不能用数字
df.loc['one','a']#one行,a列
df.loc['one':'two','a']#one到two行,a列
df.loc['one':'two','a':'c']#one到two行,a到c列
df.loc['one':'two',['a','c']]#one到two行,ac列

#iloc只能用数字索引,不能用索引名
df.iloc[0:2]#前2行
df.iloc[0]#第0行
df.iloc[0:2,0:2]#0、1行,0、1列
df.iloc[[0,2],[1,2,3]]#第0、2行,1、2、3列

#iat取某个单值,只能数字索引
df.iat[1,1]#第1行,1列
#at取某个单值,只能index和columns索引
df.at['one','a']#one行,a列
基于条件的行记录筛选
除了基础的行列选取,根据特定条件筛选行记录也是数据处理中的重要环节。这通常涉及比较运算、集合包含判断以及多条件逻辑组合,旨在从原始数据中提取符合业务逻辑的子集。
选取等于某些值的行记录 用 ==
df.loc[df[‘column_name'] == some_value]

选取某列是否是某一类型的数值 用 isin
df.loc[df[‘column_name'].isin(some_values)]

多种条件的选取 用 &
df.loc[(df[‘column'] == some_value) & df[‘other_column'].isin(some_values)]

选取不等于某些值的行记录 用 !=
df.loc[df[‘column_name'] != some_value]

isin返回一系列的数值,如果要选择不符合这个条件的数值使用~
df.loc[~df[‘column_name'].isin(some_values)]
数据值替换与映射
在获取目标数据后,往往需要对特定列的值进行替换或映射,以便后续分析或模型训练。例如,将文本类型的分类标签转换为数值型编码,是常见的数据预处理步骤。
df = pd.DataFrame({"id": [25,53,15,47,52,54,45,9], "sex": list('mfmfmfmf'), 'score': [1.2, 2.3, 3.4, 4.5,6.4,5.7,5.6,4.3],"name":['daisy','tony','peter','tommy','ana','david','ken','jim']})
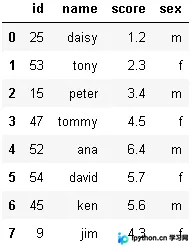
以性别字段为例,通常需要将男性(m)映射为数值 1,女性(f)映射为数值 0,以便进行数值计算或机器学习建模。
第一种实现方式是利用旧版 pandas 中的 ix 属性进行赋值。该方法通过布尔索引定位满足条件的行,并直接修改对应列的值。
df.ix[df['sex']=='f','sex']=0
df.ix[df['sex']=='m','sex']=1
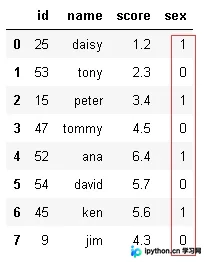
需要注意的是,在上述代码结构中,逗号后的 'sex' 参数用于明确指定目标列名,确保赋值操作作用于正确的列,避免歧义。
第二种实现方式是利用 Series 的布尔索引直接赋值。这种方式更为简洁,通过选取满足条件的子 Series 并直接赋予新值,实现批量替换。
df.sex[df['sex']=='m']=1
df.sex[df['sex']=='f']=0
特定行记录的删除操作
当需要移除不符合条件的行记录时,可以使用 drop 方法。通过筛选出需要删除的行索引,并将其从原 DataFrame 中剔除,即可完成数据清洗。
# 要删除列“score”<50的所有行:
df = df.drop(df[df.score < 50].index)

df.drop(df[df.score < 50].index, inplace=True)

# 多条件情况
# 可以使用操作符: | 只需其中一个成立, & 同时成立, ~ 表示取反,它们要用括号括起来。
# 例如删除列“score<50 和>20的所有行
df = df.drop(df[(df.score < 50) & (df.score > 20)].index)
本文内容参考了以下资料,供读者深入查阅:
[1] pandas 根据列的值选取所有行
[2] pandas小技巧之--值替换
[3] [译]如何根据条件从pandas DataFrame中删除不需要的行? - everfight - 博客园
[4] pandas 官方文档
至此,关于 pandas 中 DataFrame 特定行与列的选取、条件过滤及值替换的方法已介绍完毕。如需了解更多相关内容,建议查阅本站过往文章或关注后续更新,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















