


Python使用OpenCV和K-Means聚类实现图像分割

本文详解如何利用Python和OpenCV库中的K-Means聚类算法进行图像分割。内容涵盖将图像转换为RGB格式、展平像素数据、设置cv2.kmeans()函数的关键参数(如criteria、flags),以及通过调整聚类中心实现特定颜色区域的屏蔽与可视化,适用于毕业照等场景的色彩简化处理。
图像分割与K-Means算法概述
图像分割旨在将图像划分为多个独立区域或片段,从而简化图像表示并提升其语义可读性。
本文将介绍一种基于K-Means聚类的图像分割方法。
K-Means是一种无监督机器学习算法,核心目标是将N个观测值划分为K个簇,每个观测值归属于距离其均值最近的簇。在图像分割语境下,这些簇对应不同的颜色分布。
环境配置与数据预处理
实验环境依赖包为pip install opencv-python numpy matplotlib。
测试素材选用学校毕业照,图片来源为学校公众号发布的公开图片。
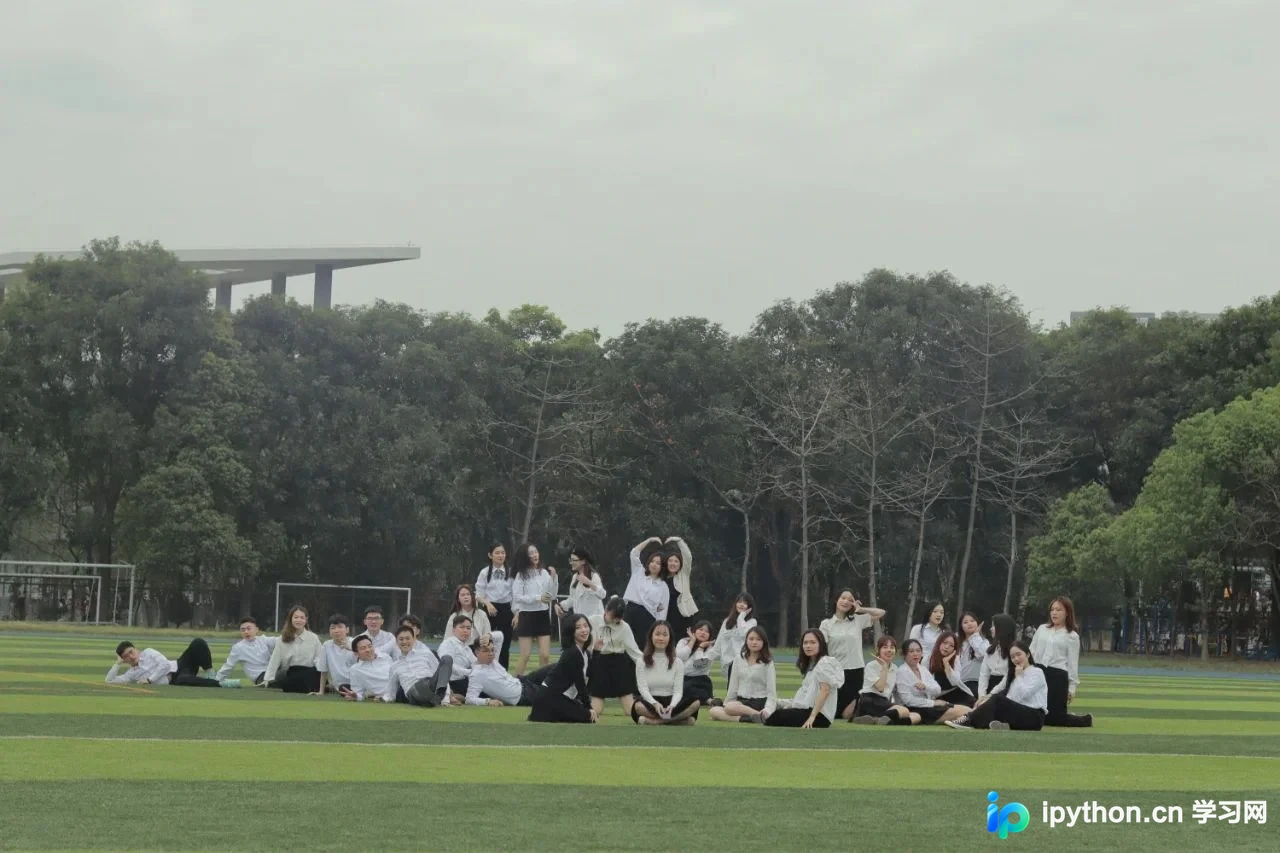
首先导入必要的Python模块。
import cv2
import numpy as np
import matplotlib.pyplot as plt
# read the image
image = cv2.imread("Graduation.jpg")
在实施分割前,需将图像数据转换为RGB色彩空间。
image = cv2.cvtColor(image, cv2.COLOR_BGR2RGB)
调用cv2.kmeans()函数,该函数接收2D数组作为输入。由于原始图像为3D结构(包含宽度、高度及3个RGB通道),需将高度和宽度维度展平,形成包含所有像素RGB值的单向量数组。
# 将图像重塑为像素和3个颜色值(RGB)的2D数组
print(image.shape) #(853, 1280, 3)
pixel_values = image.reshape((-1, 3))
# 转换为numpy的float32
pixel_values = np.float32(pixel_values)
print(pixel_values.shape) #(1091840, 3)
cv2.kmeans函数参数详解
OpenCV中K-Means算法的核心函数为cv2.kmeans(),其标准调用格式为:kmeans(data, K, bestLabels, criteria, attempts, flags)。
data参数指定分类数据,建议采用np.float32类型以提升运算速度;若使用uint类型,处理效率会显著降低,且每个特征应独立成列。
K参数指定聚类数量,OpenCV2版本要求预先已知该数值。
bestLabels用于预设分类标签,若未提供则设为None。
criteria参数定义迭代终止条件,为包含三个元素的元组,格式遵循(type,max_iter,epsilon),其中由max_iter(最大迭代次数)和epsilon(结果精度阈值)组成。
type参数提供三种终止模式选择:
- cv2.TERM_CRITERIA_EPS:当误差满足epsilon阈值时停止。
- cv2.TERM_CRITERIA_MAX_ITER:当迭代次数超过max_iter上限时停止。
- cv2.TERM_CRITERIA_EPS+cv2.TERM_CRITERIA_MAX_ITER:同时满足上述任一条件即停止迭代。
- attempts参数指定算法重复执行的次数,函数将返回表现最佳的一次结果。
flags参数用于指定初始聚类中心的选择策略,支持两种方法。
cv2.KMEANS_PP_CENTERS采用K-Means++算法初始化中心点;cv2.KMEANS_RANDOM_CENTERS则采用随机初始化方式。
聚类执行与结果可视化
此处需配置criteria以设定停止标准。例如,当迭代次数达到500次或簇中心移动距离小于0.1(epsilon值)时停止,OpenCV中定义该标准的代码如下。
# 确定停止标准
criteria = (cv2.TERM_CRITERIA_EPS + cv2.TERM_CRITERIA_MAX_ITER, 500, 0.1)
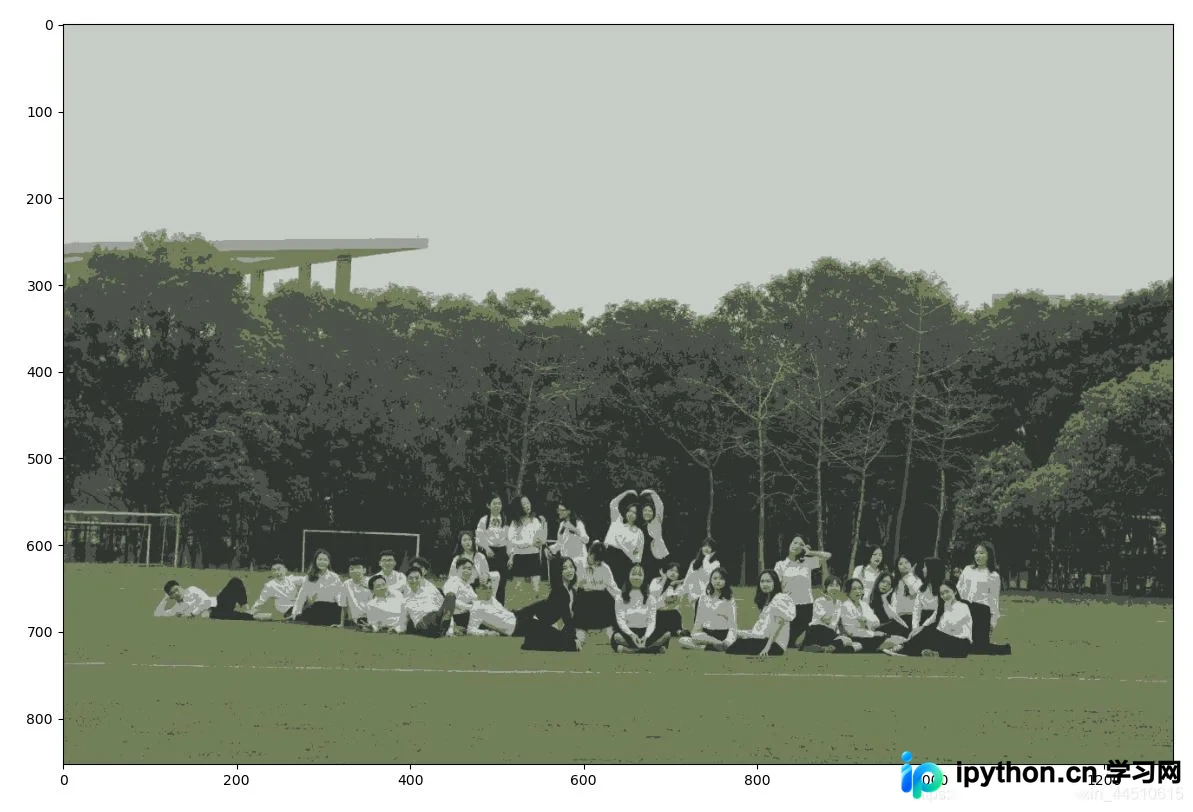
观察处理后的图像,可识别出五种主要颜色,分别对应天空、草地、树木、人物上身白色衣物及人物下身黑色衣物。
基于上述颜色分布,设定K=5进行聚类:
k = 5
_, labels, (centers) = cv2.kmeans(pixel_values, k, None, criteria, 10, cv2.KMEANS_RANDOM_CENTERS)
cv2.KMEANS_RANDOM_CENTERS指示OpenCV在初始阶段随机分配聚类中心值。
将展平的图像像素值转换为float32类型以适配cv2.kmeans()要求,随后将浮点数结果转换回8位像素值np.uint8(centers)。
# 转换回np.uint8
centers = np.uint8(centers)

# 展平标签阵列
labels = labels.flatten()

segmented_image = centers[labels.flatten()]
将处理后的数据重塑回原始图像形状并显示结果。
#重塑回原始图像尺寸
segmented_image = segmented_image.reshape(image.shape)
plt.imshow(segmented_image)
plt.show()
特定聚类簇的屏蔽与应用
此外,可通过屏蔽特定K-Means聚类簇来隐藏图像中的某些部分。例如,屏蔽编号为1的簇并显示处理后的图像。
# 禁用2号群集(将像素变为黑色)
masked_image = np.copy(segmented_image)
# 转换为像素值向量的形状
masked_image = masked_image.reshape((-1, 3))
cluster1 = 1
masked_image[labels == cluster1] = [0, 0, 0]
# 转换回原始形状
masked_image = masked_image.reshape(image.shape)
plt.imshow(masked_image)
plt.show()
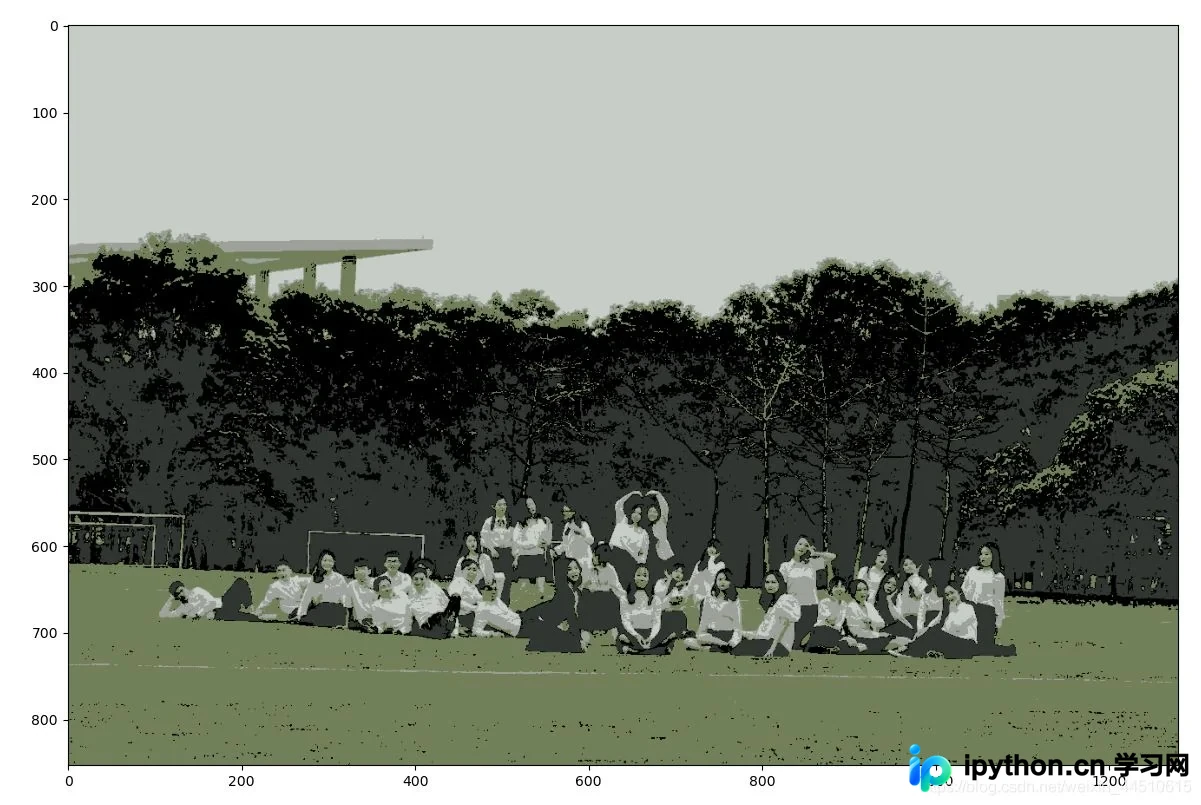
经分析,原K-Means聚类中的2号簇对应图像中的树木区域。
需注意,图像分割还存在霍夫变换、轮廓检测及当前最先进的语义分割等其他技术路径。
本文介绍了利用Python、OpenCV及K-Means聚类对图像进行分割的方法,更多相关OpenCV与K-Means图像分割内容可查阅本站历史文章或继续浏览后续教程,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















