


为什么选择MySQL?开源免费与高性能核心优势解析

在构建 Web 应用程序、在线交易系统或内部企业平台时,选择数据库通常意味着在开发预算、后期维护成本与系统吞吐能力之间权衡。MySQL 能够成为全球应用最广泛的开源关系型数据库,关键在于它在提供真正可落地的开源免费生态的同时,依靠成熟的存储引擎分层架构与精细的内存缓存机制,支撑起了企业级的高并发与低延迟读写。本文将直接切入 MySQL 的核心技术实现,拆解其低拥有成本与高性能底座的根本原因。
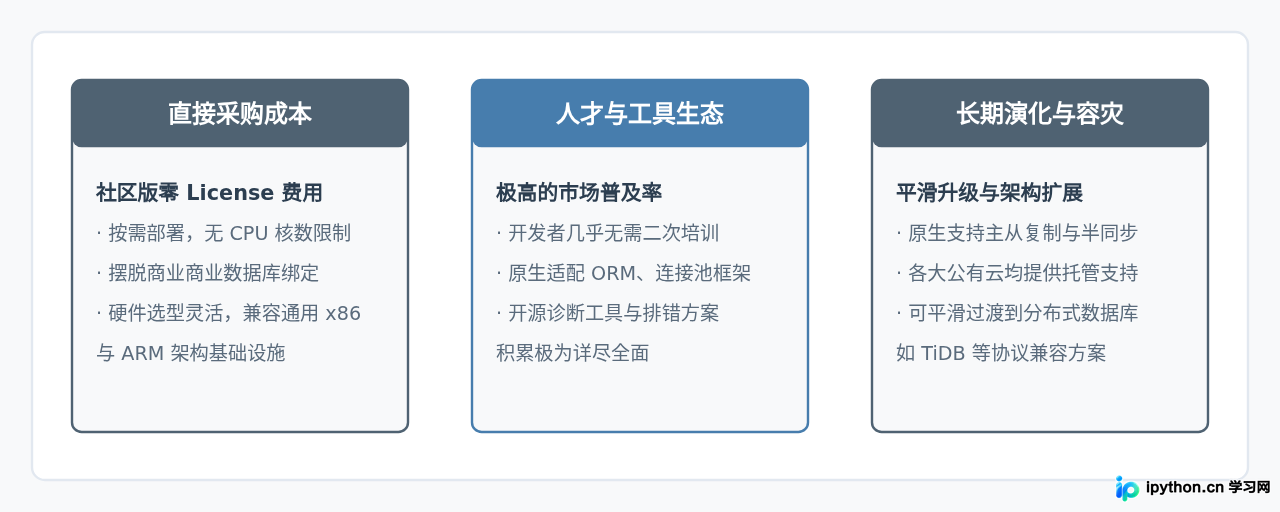
开源免费背后的真实成本优势与生态落地
许多团队在技术选型时对“免费”存在误解,认为这仅仅意味着“省下了一笔软件授权费”。在实际生产环境下,软件授权费往往只占技术生命周期总成本的一小部分,后续的人员招聘、工具链配套、故障排查和迁移容灾才是持续开销。MySQL 在此展现出了体系化的综合成本优势。
MySQL 社区版采用 GPL(GNU General Public License)开源协议。对于绝大多数搭建自有服务、SaaS 云平台或内部系统的团队,在服务器上部署运行 MySQL 并对外提供网络服务,不涉及修改并分发独立商业闭源软件,完全可以合规地免费商用。更关键的是围绕其展开的生态:开发人员储备充沛,各类编程语言的连接器(如 Connector/J、PyMySQL、Go-SQL-Driver)高度成熟,运维监控体系(Prometheus 导出的 mysqld_exporter、Percona Toolkit)完善且免费。
高性能基础:服务层与存储引擎分离的分层架构
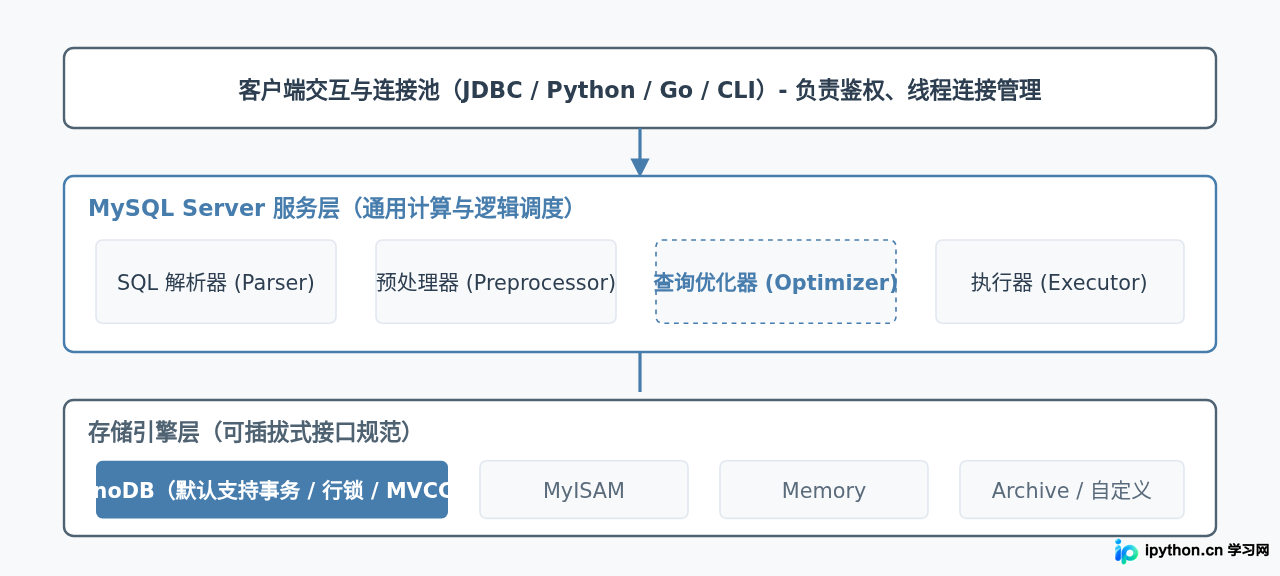
MySQL 之所以能长期保持高性能,核心在于其经典的“上下分层”架构。MySQL 的整体处理逻辑清晰地划分为两层:负责通用的连接管理、SQL 解析、优化执行的服务层(Server 层),以及负责物理数据实际存取、事务锁实现的存储引擎层(Storage Engine 层)。
这种解耦设计让 MySQL 可以保持极高的专注度。无论底层使用的是具备事务安全特性的 InnoDB,还是适用于只读归档的 CSV/Archive 引擎,Server 层的查询优化器(Optimizer)都能使用统一的代价模型(Cost Model)来选择最优执行计划。在实际应用中,绝大多数业务都默认采用 InnoDB 作为标准引擎。
InnoDB 核心:B+树聚簇索引与高效点查、范围查询
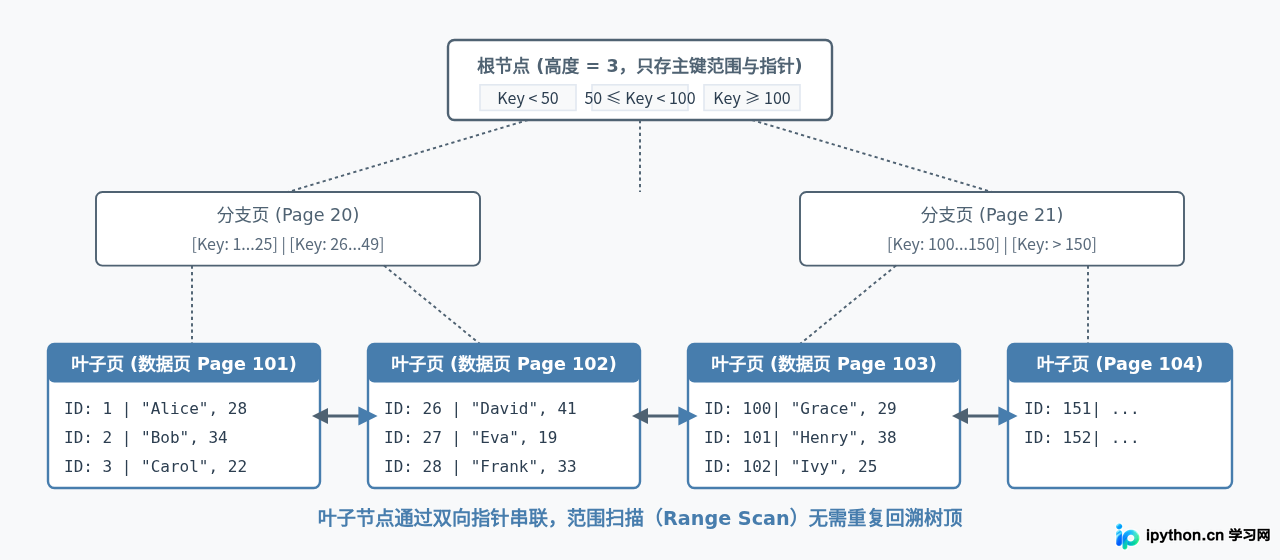
决定数据库日常吞吐能力的最重要因素,是数据在磁盘和内存中的组织形式。InnoDB 采用聚簇索引(Clustered Index)架构,其物理存储完全建立在一棵平衡的 B+ 树上。理解 B+ 树的运作方式,就能明白为什么 MySQL 的主键点查和主键区间范围检索具备确定性的毫秒级响应。
在 InnoDB 的数据文件中,数据表本身就是按主键顺序组织的 B+ 树。这种数据结构具备三大性能优势:
- 非叶子节点只存索引键与页指针: 每一个数据页(默认 16KB)内能容纳更多的索引记录,从而极大地增加了树的“扇出”(Fan-out),整棵树的高度通常仅为 3 到 4 层,几千万行的数据单次查询最多仅需 3 至 4 次寻址。
- 叶子节点按顺序双向链表相连: 在执行
BETWEEN ... AND ...或分页扫描时,只需在树中定位到范围的起始边界节点,随后直接顺着双向链表向后线性读取即可,无需重复回到树的根部重新寻路。 - 主键与整行数据捆绑(聚簇存储): 只要命中聚簇索引,定位到叶子节点即拿到完整行记录,无需再次进行物理回表(Lookup)寻址。
内存与磁盘协调:缓冲池与 WAL 机制的高效写入
对任何数据库而言,磁盘 I/O 都是最缓慢的操作。如果每次执行 INSERT 或 UPDATE 都要实时把数据写回数据文件的指定物理扇区,系统的并发写入吞吐将迅速被磁盘寻道所瓶颈化。MySQL 的高性能很大程度上归功于其内存缓冲池(Buffer Pool)和写前日志(Write-Ahead Logging, WAL)的协同机制。
当执行写入操作时,MySQL 的处理顺序是这样的:
- 首先在内存中修改对应的数据页。如果该页不在 Buffer Pool 中,则先从磁盘载入内存再做修改,此时该页变成“脏页”(Dirty Page)。
- 将变更内容以极其紧凑的物理格式顺序追加写入
Redo Log缓冲区。 - 事务提交时,系统通过
fsync仅将顺序追加的 Redo Log 刷入磁盘,此时事务即确认持久化成功。 - 内存中的脏页并不急于同步写入磁盘数据文件,而是由后台专门的 I/O 线程按照 LRU 算法或 Checkpoint 机制,批量异步刷盘(Flush)。
通过“顺序写 Redo Log 代替随机写数据页”,MySQL 成功把高延时的离散磁盘写入转化成了高速的顺序追加写,并在内存中消化了大量并发修改,从而实现了极高的每秒写操作数(QPS/TPS)。
关键配置提醒:
在生产环境的专有数据库服务器上,参数 innodb_buffer_pool_size 通常建议配置为主机物理内存的 50% 至 75%。充足的 Buffer Pool 可以将核心工作数据集完全常驻内存,让几乎所有的读请求和行级更新都命中内存缓存。
从验证到落地:MySQL 基础配置与执行效率检验
为了让上述理论转化成可落地的操作,我们需要了解如何检查当前系统的存储引擎状态,以及如何通过查询优化器验证索引是否有效命中。
1. 检查默认引擎与缓冲池大小
在连接至 MySQL 终端后,可以通过运行以下命令,验证实例当前的引擎支持情况以及内存分配:
-- 检查各存储引擎的支持状态
SHOW ENGINES;

-- 查看 InnoDB 缓冲池实际配置大小(单位为字节)
SHOW VARIABLES LIKE 'innodb_buffer_pool_size';在返回结果中,InnoDB 的 Support 字段应显示为 DEFAULT。如果系统配置了 8GB 的缓冲池,变量查询将返回近似 8589934592 的数值。
2. 使用 EXPLAIN 确认索引命中与性能开销
评估一条查询是否处于高性能状态,主要依托于 EXPLAIN 执行计划命令。以下通过一个具体的订单表示例进行说明:
-- 创建一个包含主键与普通联合索引的订单表
CREATE TABLE `customer_orders` (
  `order_id` BIGINT NOT NULL AUTO_INCREMENT,
  `customer_id` INT NOT NULL,
  `order_date` DATE NOT NULL,
  `total_amount` DECIMAL(10, 2) NOT NULL,
  PRIMARY KEY (`order_id`),
  KEY `idx_cust_date` (`customer_id`, `order_date`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

-- 分析根据客户 ID 与日期范围检索订单的执行计划
EXPLAIN SELECT `order_id`, `total_amount`
FROM `customer_orders`
WHERE `customer_id` = 10086 AND `order_date` >= '2026-01-01';
执行后重点查看输出中的三项核心指标:
| 关键字段 | 理想表现 | 需要优化的表现 | 工程含义说明 |
|---|---|---|---|
type |
const / ref / range |
ALL / index |
访问数据的方式。ref 或 range 说明命中了索引区间;ALL 代表全表扫描,极耗 I/O。 |
key |
PRIMARY 或指定索引名 |
NULL |
优化器实际选用的索引。若为 NULL,说明该查询没有利用任何索引。 |
rows |
几行到几百行之间 | 接近表总行数 | 优化器根据代价模型估算需要扫描读取的行数,数值越小越优。 |
全景总结:MySQL 适用场景与选型决策
任何架构工具都有其适用的场景边界。MySQL 的高性能建立在行级操作、强一致性事务以及高度规范化的结构化数据查询之上。理解这些特点,有助于在面对不同业务需求时做出清晰的判断:
- 最适合选择 MySQL 的场景: 在线电商交易、用户账户鉴权、SaaS 核心业务单据等典型的 OLTP(在线事务处理)系统。这些系统要求强 ACID 保证、单行毫秒级点查,以及高并发读写。
- 建议辅助或替换 MySQL 的场景: 包含海量复杂统计聚合计算的报表分析系统(更适合选用 ClickHouse 等列式存储);存储无固定 Schema 的非结构化文档或日志聚合(更适合 Elasticsearch 或 MongoDB)。
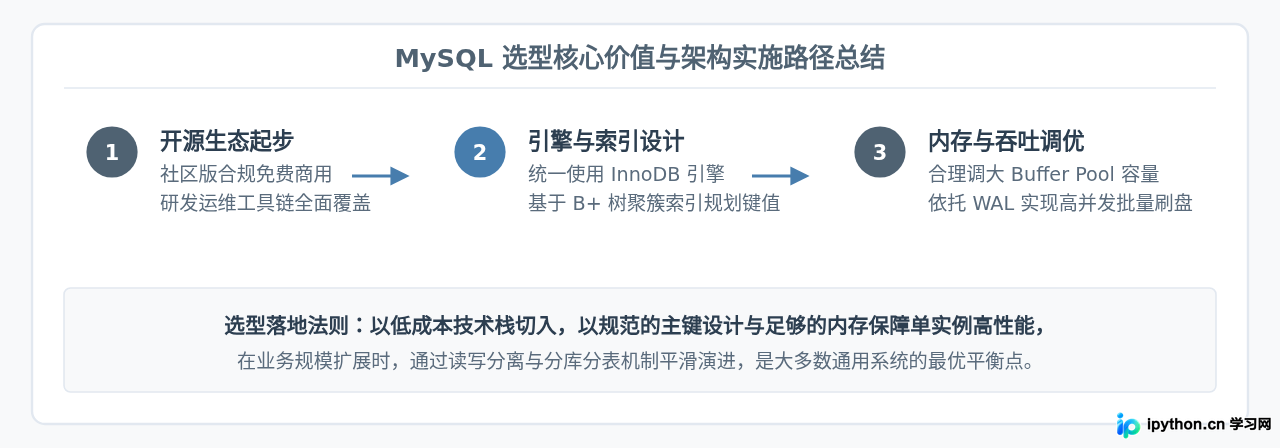
综上所述,MySQL 经受住长期考验的根本原因,不在于某个单独的参数,而在于其开源生态带来的极低试错成本与以 InnoDB 聚簇索引和内存缓冲为核心的高效 I/O 模型形成了成熟闭环。遵循标准设计规范、用好执行计划诊断,MySQL 就能为绝大多数业务场景提供兼具稳定性、经济性与高吞吐的持久化基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















