


Python实战:利用requests与matplotlib爬取并可视化江苏疫情实时数据

本文介绍如何使用Python的requests库抓取腾讯新闻疫情实时数据接口,并通过json解析提取全国及江苏省各地级市的确诊、新增及治愈数据。结合PrettyTable美化输出,最后利用matplotlib库对江苏各地市疫情分布进行可视化分析,直观展示扬州等地疫情状况。
1.引言
近期,江苏南京与湖南张家界等地相继出现疫情反弹,影响范围已扩展至8省22市。目前全国划定有2个高风险地区和52个中风险地区。身处南京的笔者作为普通市民,深切关注疫情动态。为了实时掌握最新疫情信息,本文将演示如何使用Python编写爬虫程序,抓取并分析最新的疫情实时数据。
2.获取目标网站
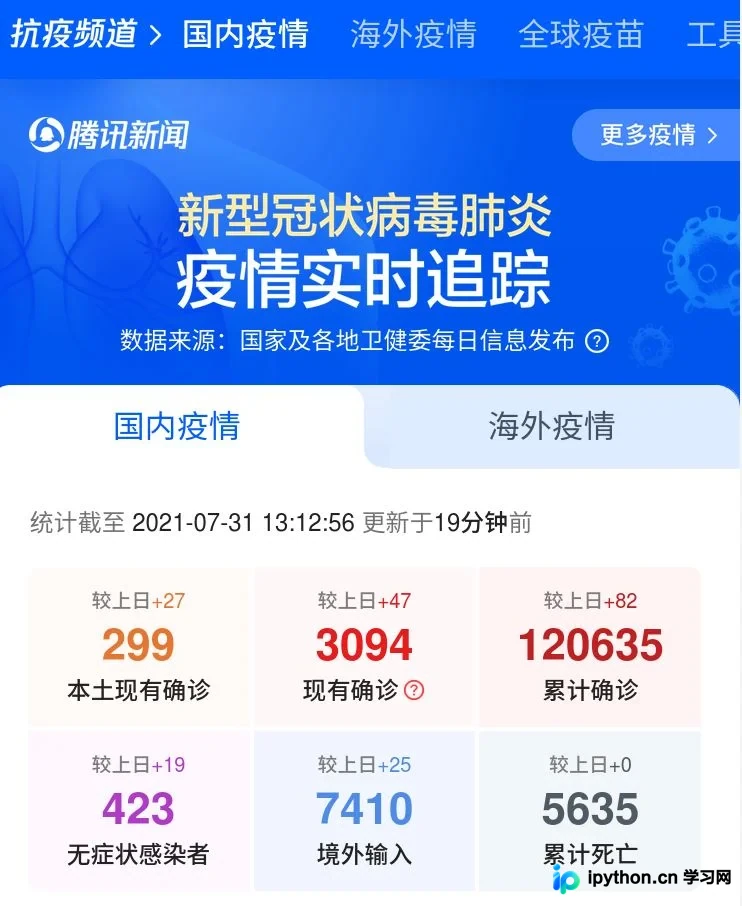
为实现Python对疫情数据的自动化采集,首先需要确定数据来源。国内主流的新闻平台如腾讯新闻、网易新闻等均提供疫情实时追踪服务,内容涵盖国内疫情概况、海外疫情动态、每日新增确诊趋势以及疫苗接种进度等。本文选取腾讯新闻的疫情发布页面作为数据源进行爬取与分析。
网站分析:
- 使用Chrome浏览器访问疫情发布页网址,界面显示如上图所示。
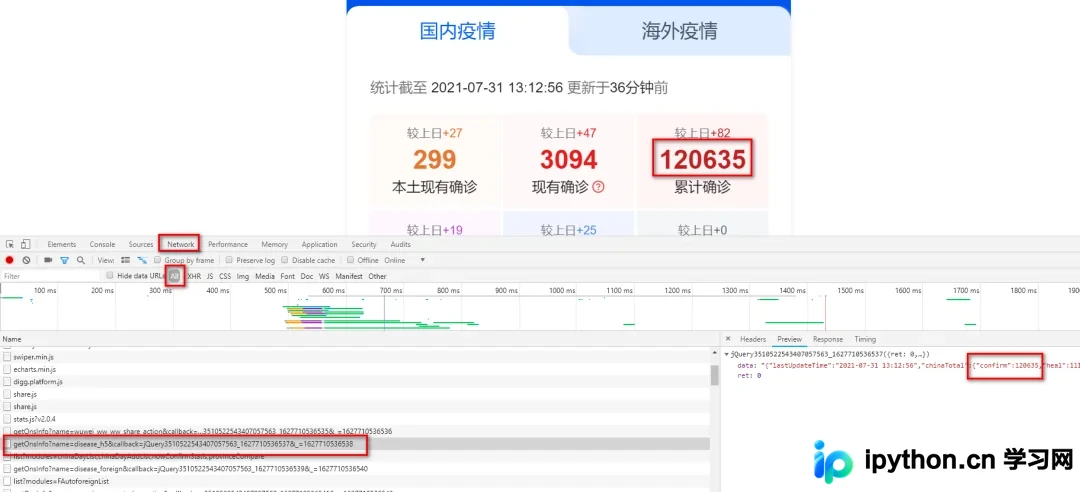
- 按下F12键进入开发者工具模式,随后按Ctrl+R刷新页面以加载网络请求。
- 在Network(网络)面板中查找名为getOnsInfo?name=disease_h5的请求,从而获取用于爬取的目标API网址。
3.爬取目标网站
编写爬虫程序前,需确保已安装Python的requests库,安装命令如下:
pip3 install requests
仅需三行核心代码即可获取该网页返回的数据内容,具体代码如下:
url = 'https://view.inews.qq.com/g2/getOnsInfo?name=disease_h5'
req = requests.get(url=url)
content = json.loads(req.text)
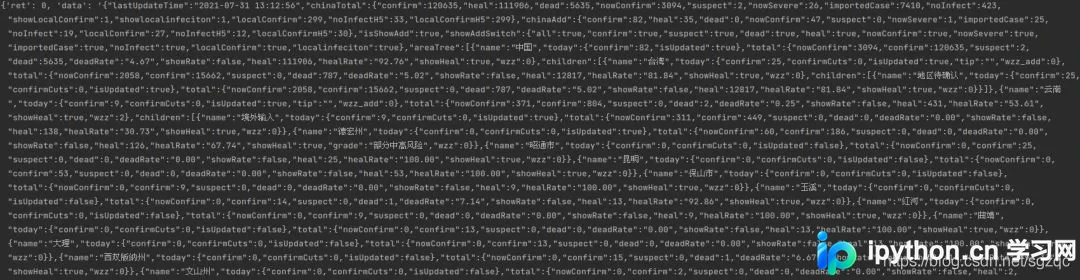
执行代码后打印出的爬取结果如下:
4.解析爬取内容
虽然成功获取了网页数据,但原始数据通常为JSON格式,我们需要对其进行解析,从中提取感兴趣的关键信息。
4.1. 解析全国今日总况

对应的数据解析代码如下:
def get_all_china(content):
    tmp_data = content["data"]
    area_data = json.loads(tmp_data)["areaTree"]
    country = area_data[0]
    country_list = []
    name = country["name"]
    today_confirm = country["today"]["confirm"]
    now_confirm = country["total"]["nowConfirm"]
    total_confirm = country["total"]["confirm"]
    total_heal = country["total"]["heal"]
    country_list.append([name, today_confirm, now_confirm, total_confirm, total_heal])
    return country_list
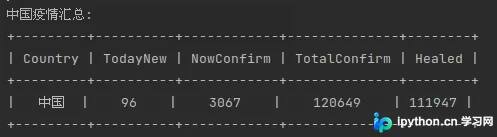
运行代码后的输出结果如下:
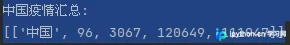
原始输出格式较为杂乱,此处引入PrettyTable库对输出结果进行美化处理,代码如下:
def format_list_prettytable(title,province_list):
    table = PrettyTable(title)
    for province in province_list:
        table.add_row(province)
    table.border = True
    return table
美化后的结果如下:
4.2. 解析全国各省份疫情情况
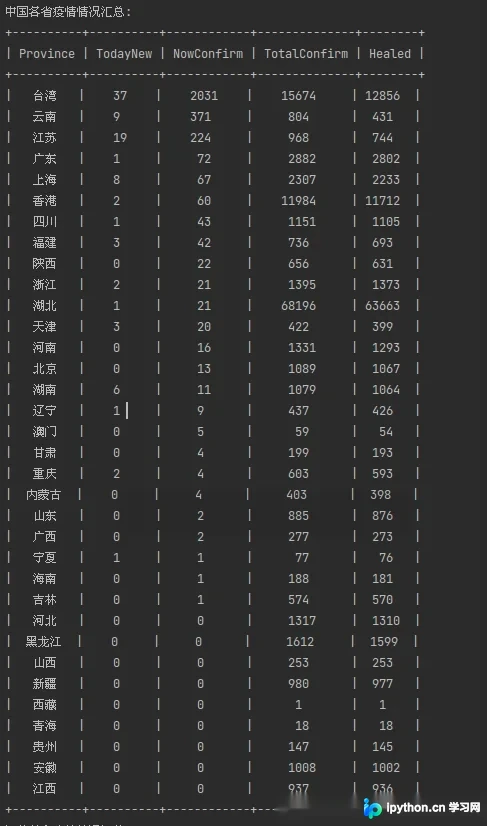
参照上述逻辑,可进一步解析全国各省市的具体疫情数据,代码如下:
def get_all_province(content):
    tmp_data = content["data"]
    area_data = json.loads(tmp_data)["areaTree"]
    data = area_data[0]['children']

    province_list = []
    for province in data:
        name = province["name"]
        today_confirm = province["today"]["confirm"]
        now_confirm = province["total"]["nowConfirm"]
        total_confirm = province["total"]["confirm"]
        total_heal = province["total"]["heal"]
        province_list.append([name, today_confirm, now_confirm, total_confirm, total_heal])
    return province_list
运行结果如下:
4.3. 解析江苏各地级市疫情情况
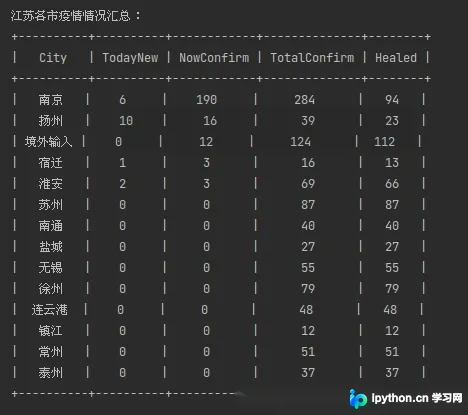
最后,我们重点获取江苏省内各地级市的详细疫情数据,代码如下:
def parse_jiangsu_province(content,key_province):
    tmp_data = content["data"]
    area_data = json.loads(tmp_data)["areaTree"]
    data = area_data[0]['children']

    city_list = []
    for province in data:
        name = province["name"]
        if name == key_province:
            children_list = province["children"]
            for children in children_list:
                city = children["name"]
                today_new = children["today"]["confirm"]
                now_confirm = children["total"]["nowConfirm"]
                total_confirm = children["total"]["confirm"]
                total_heal = children["total"]["heal"]
                city_list.append([city, today_new, now_confirm, total_confirm, total_heal])
    return city_list
运行结果如下:
5.结果可视化
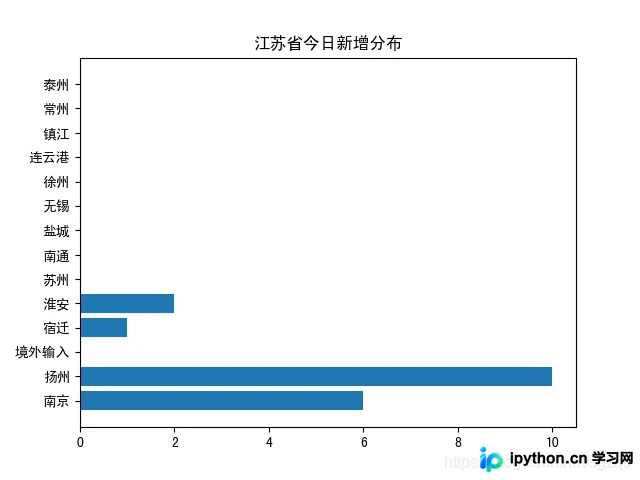
使用matplotlib库对前述爬取的江苏各地级市疫情数据进行可视化展示,得到图表如下:
今日新增确诊病例的可视化结果如下:
现有确诊病例数的可视化结果如下:
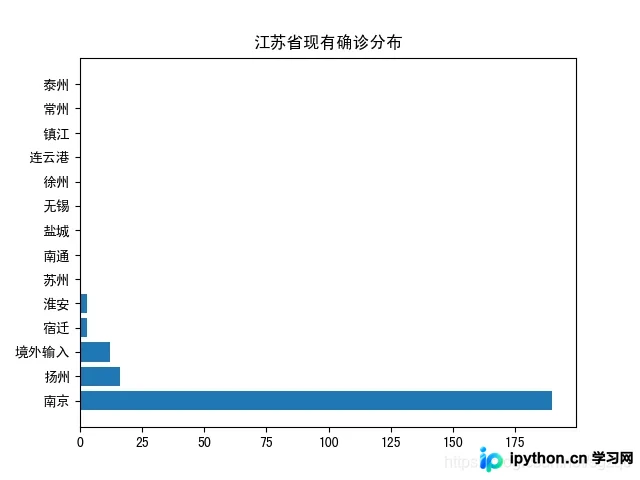
从上述图表分析可见,疫情已扩散至扬州地区,且扬州今日新增感染人数居首,需引起高度重视。
6. 代码
完整代码
https://github.com/sgzqc/wechat/tree/main/20210731
7. 参考
链接一
至此,关于Python获取江苏疫情实时数据及爬虫分析的文章介绍完毕。如需了解更多Python相关江苏疫情内容,欢迎搜索本站往期文章或继续浏览后续内容,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















