


MySQL主要用来做什么?Web应用与数据存储典型场景

MySQL主要用来保存、查询和管理结构化数据。在常见的Web应用中,用户账号、文章内容、商品信息、订单、评论、权限关系等数据,都可以存放在MySQL中。应用程序负责接收用户请求和执行业务逻辑,MySQL则负责把需要长期保存的数据可靠地组织起来,并根据条件快速查询、修改或删除。
理解MySQL的用途,可以先抓住一个核心:它不是用来展示网页的,也不是专门存放图片和视频文件的,而是一套关系型数据库管理系统。它最擅长处理“有明确字段、数据之间存在关系、需要频繁增删改查”的业务数据。
一、MySQL在Web应用中到底处于什么位置
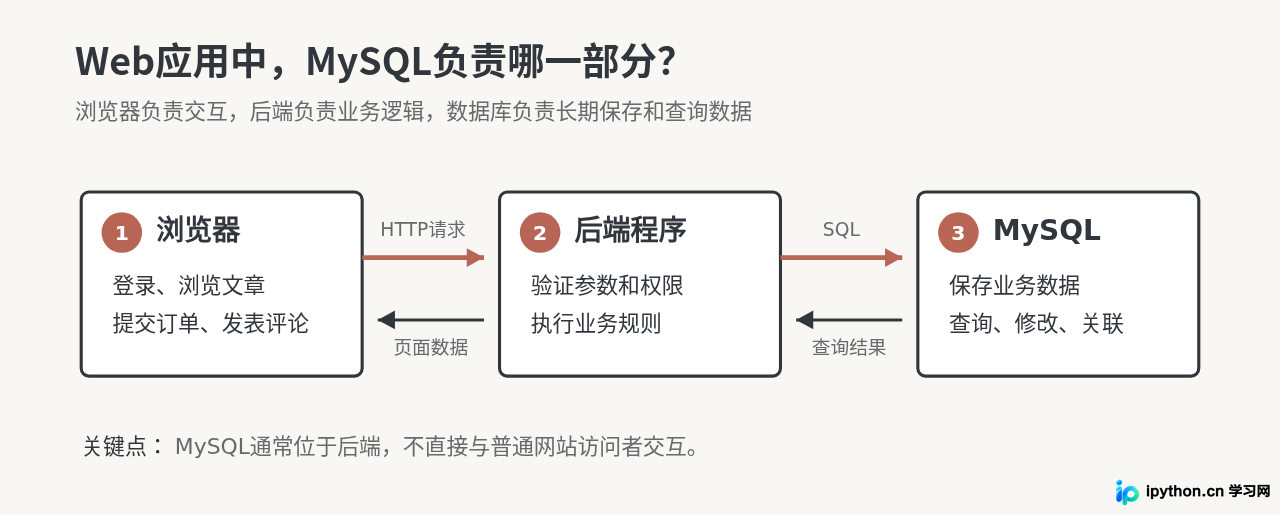
打开一个普通网站时,浏览器看到的是HTML、CSS和JavaScript,但这些页面背后的数据往往来自数据库。例如进入一个文章详情页,程序可能先根据文章ID从MySQL中查询标题、正文、作者、发布时间和分类,再将查询结果组合成HTML返回给浏览器。
因此,一个典型Web系统可以简单理解为三层:浏览器负责发送请求和展示结果,后端程序负责业务处理,MySQL负责数据的持久化存储。
二、MySQL最核心的用途是存储结构化业务数据
所谓结构化数据,就是数据可以按照相对固定的字段组织。例如一个网站用户可能包含用户ID、用户名、邮箱、密码摘要、注册时间和状态;一篇文章可能包含文章ID、标题、正文、作者ID和发布时间。
这些数据很适合使用数据库表保存。例如可以建立一个简单的用户表:
CREATE TABLE users (
    id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,
    username VARCHAR(50) NOT NULL,
    email VARCHAR(120) NOT NULL,
    created_at DATETIME NOT NULL,
    PRIMARY KEY (id),
    UNIQUE KEY uk_email (email)
);
每一行代表一个用户,每一列代表某种属性。相比把所有用户信息写进普通文本文件,这种结构能够更方便地按照ID、邮箱或其他字段查找数据,同时还能通过主键、唯一约束等规则减少重复或不符合要求的数据。
例如新增一名用户可以执行:
INSERT INTO users (username, email, created_at)
VALUES ('xiaoming', 'xiaoming@example.com', NOW());
随后按照邮箱查询:
SELECT id, username, email, created_at
FROM users
WHERE email = 'xiaoming@example.com';
这里体现的就是MySQL最基础也最常见的能力:创建数据、读取数据、更新数据和删除数据,也就是开发中经常提到的CRUD。
三、一次数据写入和查询通常是怎样完成的
以网站注册为例,用户填写用户名和邮箱之后,并不是浏览器自己将内容直接写入MySQL。正常情况下,请求应该先到达后端程序,由后端验证格式、检查业务条件,再执行SQL。
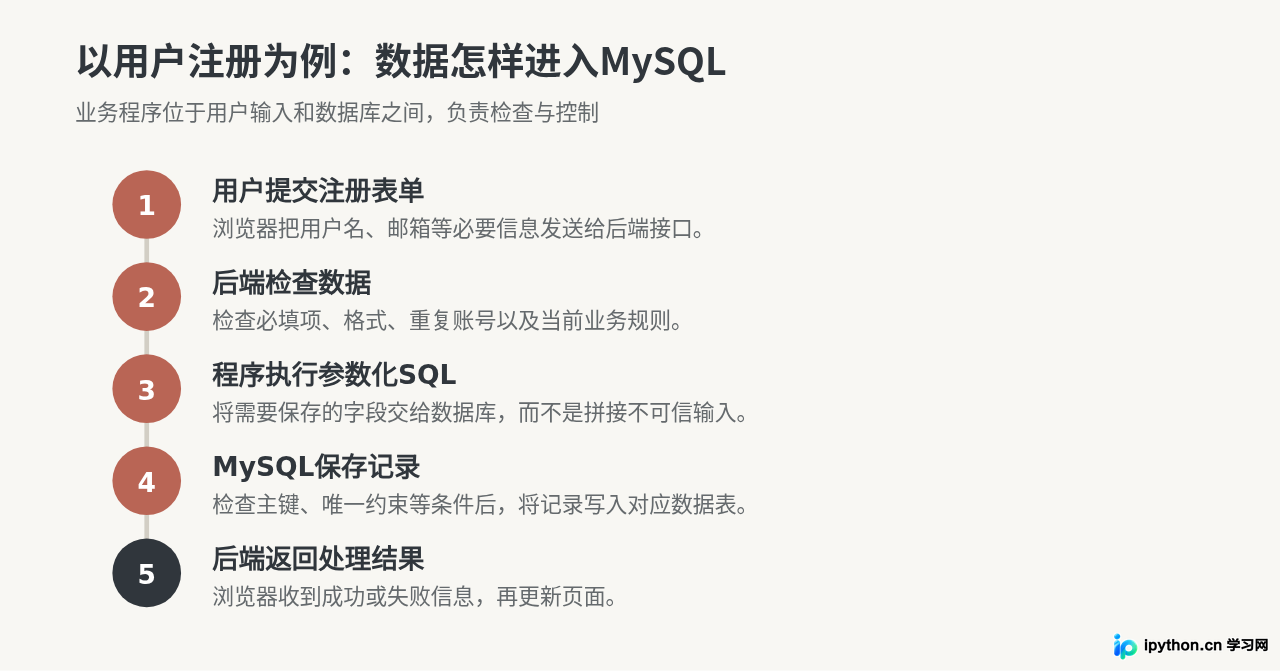
读取数据也是类似的流程。例如用户打开文章页面,后端从URL得到文章ID,然后执行查询:
SELECT id, title, content, author_id, published_at
FROM articles
WHERE id = 10086;
MySQL将符合条件的记录返回给后端,后端再生成最终页面或JSON数据。
四、MySQL不仅能保存数据,还能表达数据之间的关系
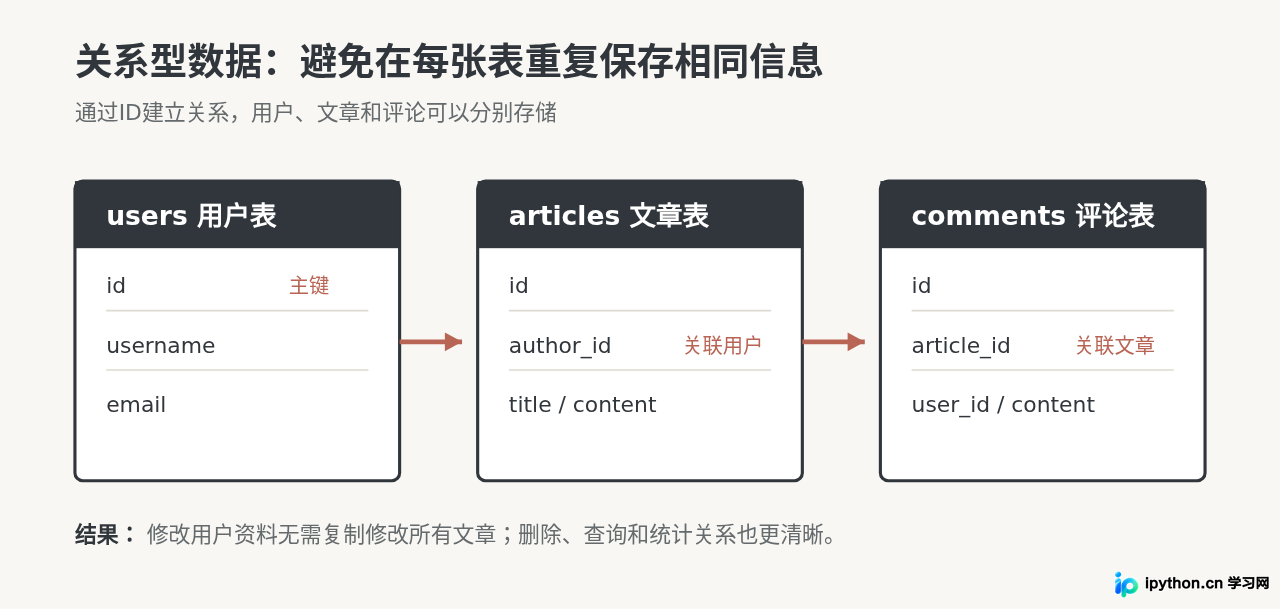
关系型数据库的价值并不只是“做几张表”。真正重要的是不同业务对象能够通过字段建立关联。
以内容网站为例,文章表没有必要重复保存作者的完整资料,只需要保存一个author_id。用户表保存作者信息,文章表保存文章内容。查询时根据两个表之间的关联取出所需内容。
例如:
SELECT
    a.id,
    a.title,
    u.username AS author
FROM articles AS a
JOIN users AS u ON u.id = a.author_id
WHERE a.id = 10086;
这样设计后,如果作者修改昵称,通常只需要更新用户表,而不需要逐篇修改这个作者过去发布的文章。
五、MySQL在Web应用中的几个典型场景
1. 用户账号与权限系统
网站注册、登录和后台管理通常需要保存用户资料,例如用户ID、登录名、密码摘要、状态、注册时间以及角色信息。
这里MySQL的作用不只是“记住账号”,还包括根据唯一字段查找用户、判断账号是否存在、建立用户与角色的关系,以及记录需要长期保存的账户状态。
需要注意,密码通常不应该以明文形式直接保存到数据库。正确做法是在应用层使用适合密码存储的安全哈希方案处理,再保存得到的结果。
2. 内容网站和博客
文章站、教程站、新闻站通常会把标题、正文、作者、分类、发布时间、状态等内容放进MySQL。例如:
- 文章表保存文章主体;
- 分类表保存栏目;
- 文章与分类之间建立关联;
- 评论表保存用户评论;
- 标签表负责文章标签。
当访问“Python教程”分类时,后端可以根据分类条件查询对应文章,而不需要遍历磁盘上的大量普通文件。
3. 电商商品和订单
电商系统是关系型数据库的典型使用场景。商品、用户、订单、订单明细和支付状态之间存在明确关系。
例如一笔订单可以对应多条订单明细,每条明细指向某种商品。创建订单时,程序可能需要同时写入订单主表和订单明细表。这类操作往往要求多个数据库操作保持一致,事务机制就非常重要。
简单理解,一组必须共同成功的操作可以放在同一个事务中:
START TRANSACTION;

INSERT INTO orders (user_id, status)
VALUES (1001, 'pending');

INSERT INTO order_items (order_id, product_id, quantity)
VALUES (LAST_INSERT_ID(), 2001, 2);

COMMIT;
实际业务还需要处理库存、价格快照、支付状态以及失败回滚等问题,上面的SQL只是帮助理解“订单主记录和明细记录需要保持一致”这一关系。
4. 后台管理系统
企业后台、CMS、客户管理系统和内部业务平台,也经常使用MySQL。它们通常包含大量结构比较稳定的表格数据,并且需要按照时间、状态、用户或业务编号进行筛选。
例如后台需要查看“状态为待审核、最近提交的50条文章”,数据库可以直接按照条件查询和排序,而不需要应用程序把全部文章加载进内存后再逐条判断。
SELECT id, title, author_id, created_at
FROM articles
WHERE status = 'pending'
ORDER BY created_at DESC
LIMIT 50;
5. 配置、日志索引和任务记录
一些需要长期保存、结构明确的系统配置和任务状态也可以放进MySQL,例如定时任务执行状态、导入任务记录、消息发送状态等。
但这里要区分“业务记录”和“大规模原始日志”。如果网站每秒产生大量访问日志,并且需要进行全文检索或复杂日志分析,是否全部放进MySQL就要根据数据规模和查询方式重新评估,并不是只要是数据就应该进入MySQL。
六、图片、视频和安装包通常不应该直接塞进MySQL
这是理解MySQL用途时一个很重要的边界。
MySQL能够保存二进制数据,但“能够保存”不等于“所有文件都适合保存”。对于网站中的图片、视频、压缩包、安装包等大文件,更常见的做法是把文件存放在本地文件系统、对象存储或专门的文件服务中,而MySQL只保存文件的路径、URL、大小、类型以及与业务对象之间的关系。
例如一张文章图片可以记录为:
CREATE TABLE article_images (
    id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,
    article_id BIGINT UNSIGNED NOT NULL,
    file_url VARCHAR(500) NOT NULL,
    file_size BIGINT UNSIGNED NOT NULL,
    created_at DATETIME NOT NULL,
    PRIMARY KEY (id)
);
数据库中保存的是类似下面的信息:
article_id: 10086
file_url: https://img.ipython.cn/uploads/2026/mysql-architecture.webp
file_size: 185240真正的mysql-architecture.webp文件则由文件系统或对象存储负责保存和传输。这样通常更方便进行CDN分发、缓存和文件生命周期管理。
七、MySQL适合什么数据,不适合什么数据
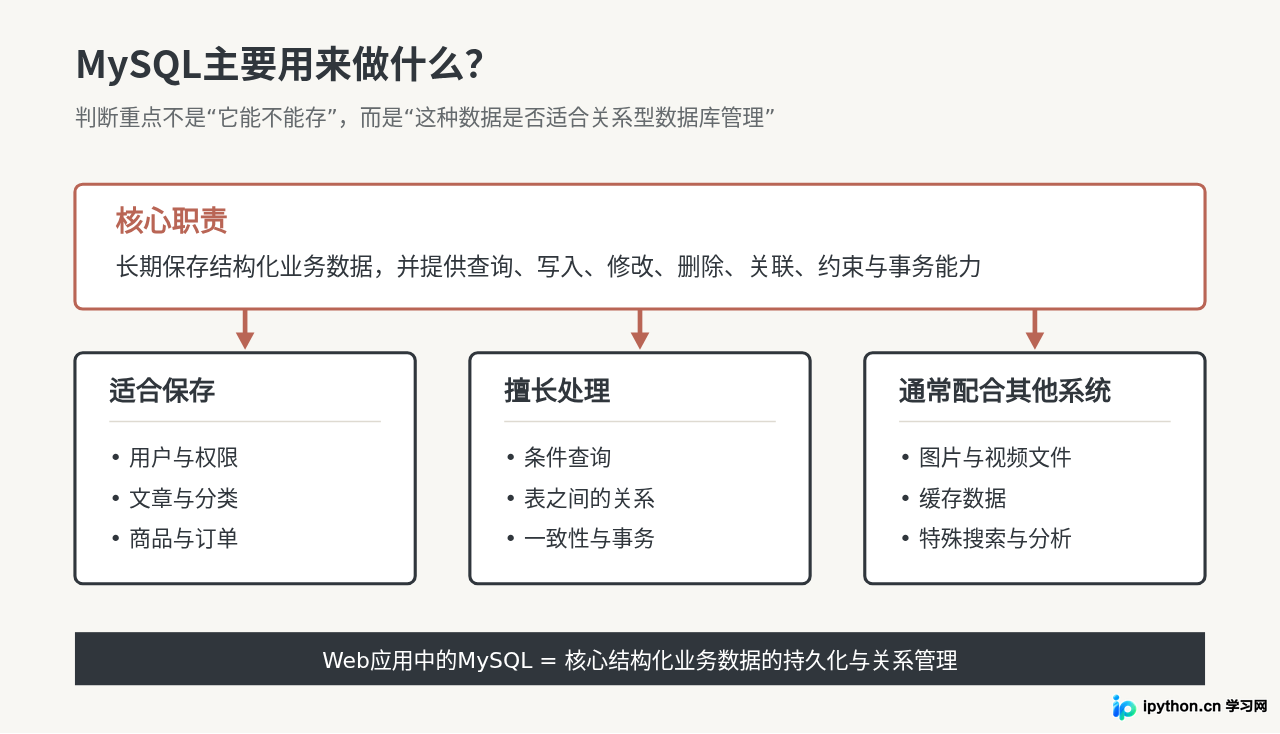
判断一个数据是否适合优先考虑MySQL,可以观察几个特征:结构是否明确、记录之间是否存在关系、是否需要条件查询、是否要求事务一致性。
| 数据类型或场景 | 是否通常适合MySQL | 原因 |
|---|---|---|
| 用户账号 | 适合 | 字段明确,需要唯一约束、查询和更新 |
| 网站文章 | 适合 | 存在作者、分类、状态等结构化关系 |
| 商品和订单 | 适合 | 关系明确,并经常要求事务一致性 |
| 评论和留言 | 适合 | 需要关联用户、文章并按照时间查询 |
| 几MB甚至更大的图片或视频文件 | 通常不直接存文件本体 | 通常由文件系统或对象存储保存,数据库记录元数据和地址 |
| 海量原始访问日志 | 需要具体评估 | 写入规模和分析方式可能更适合专门的日志或分析系统 |
这里不能简单理解成“MySQL只能保存小数据”。真正需要考虑的是数据访问模式。如果某种数据经常通过主键、条件、关系和事务进行读写,MySQL很有优势;如果需求主要是保存和分发大型文件,或者处理某些特别面向全文搜索、时序分析的数据,则往往需要与其他存储系统配合。
八、MySQL并不是网站的全部数据层
实际Web系统经常同时使用多种组件。MySQL可以作为核心业务数据库,但不会承担所有职责。
例如一个内容网站可能采用这样的分工:
- MySQL保存用户、文章、分类、评论以及权限等核心业务数据;
- 文件系统或对象存储保存图片、视频和下载文件;
- 缓存系统保存访问频繁、允许短时间缓存的数据;
- 搜索系统根据需要承担更复杂的全文检索。
这种分工并不意味着MySQL能力不足,而是不同系统针对的数据类型和访问模式不同。把MySQL用于它擅长的结构化业务数据,通常比让一个数据库承担所有任务更合理。
九、从一个文章网站看MySQL到底保存什么
假设现在要开发一个简单教程网站,其中有用户、栏目、文章和评论。MySQL中的数据可以按下面的思路组织:
- users:保存用户账号和基本资料;
- categories:保存“Python”“MySQL”“Linux”等栏目;
- articles:保存文章标题、正文、作者、发布时间和状态;
- comments:保存评论,并关联文章与用户;
- article_images:保存文章图片的文件地址和相关元数据。
当访问文章/article/10086/时,程序可以使用文章ID查询文章,再通过作者ID查询用户信息,通过文章ID查询评论和图片记录,最终组合成读者看到的页面。
如果后台管理员修改文章标题,程序只需要执行类似下面的更新:
UPDATE articles
SET title = '修改后的文章标题'
WHERE id = 10086;
这正是数据库与普通静态文件在管理方式上的重要区别:业务数据可以按照明确条件直接查询和修改,而不需要人工定位某个文件再解析其中的内容。
十、理解MySQL用途时容易出现的几个误区
误区一:网站用了MySQL,所有内容都必须放数据库
并不是。HTML模板、CSS、JavaScript、图片、视频和程序源码都有各自更合适的保存位置。MySQL主要承担结构化业务数据管理。
误区二:MySQL只是一个“数据文件”
MySQL不仅负责把数据写到磁盘,还提供SQL查询、索引、事务、约束、权限控制以及并发访问等数据库能力。应用程序通常通过数据库连接访问这些能力,而不是直接读取MySQL底层数据文件。
误区三:数据量一大就不能用MySQL
数据量本身并不能单独决定是否适合MySQL。表结构、索引、查询模式、并发量、硬件和架构都会影响实际表现。一个设计合理的大表可能运行正常,一个数据量不大的表也可能因为缺少合适索引而出现慢查询。
误区四:有了MySQL就不需要备份
数据库提供持久化存储,并不等于自动解决误删除、磁盘故障、程序错误等问题。正式业务仍然需要根据数据重要程度建立备份和恢复方案,并验证备份确实能够恢复。
十一、用一张图总结MySQL主要负责什么
总结
MySQL主要用于管理结构化、需要长期保存并且经常查询和修改的业务数据。在Web应用中,用户账号、文章、分类、评论、商品、订单、权限以及各种业务状态,都是非常典型的使用对象。
它的价值不只是“把数据存下来”,而是能够通过表、字段、索引、关系、约束和事务,让程序按照明确规则管理这些数据。用户打开页面、登录账号、发布文章或者提交订单时,后端程序通常都会根据业务需要读取或写入MySQL。
同时也要明确它的使用边界。图片、视频和大型下载文件通常更适合交给文件系统或对象存储;缓存、全文搜索、海量日志分析等需求也可能使用专门的系统。对于大多数普通Web项目,可以把MySQL理解为核心业务数据的主要存储层,而不是承包所有类型数据的万能存储工具。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















