


Python实现相关性分析与散点图绘制:自动标注Pearson系数

发布时间:2026-10-14 |
4人浏览过
本文详解如何使用Python进行数据相关性分析并批量绘制散点图。通过结合Pandas、Matplotlib和Seabon库,演示如何读取CSV数据,计算Pearson相关系数,并在生成的散点图中自动标注相关数值。代码示例展示了从数据预处理到图像保存的完整流程,帮助开发者快速实现可视化结果输出。
近期有开发者咨询如何利用Python绘制散点图,虽然绘图本身较为简单,但将相关性数值准确标注在图形上稍显复杂。为此,本文记录完整操作流程,以便清晰展示实现步骤。
所需依赖库
本教程主要涉及pandas、numpy、matplotlib及seaborn等库。注意,使用seaborn库前必须引入matplotlib,因为seaborn是作为matplotlib的扩展库运行的。
#1 load pakeage

import pandas as pd#读写表格以及表格处理
import numpy as np#用于数据计算

import geopandas as gpd
import matplotlib.pyplot as plt
import seaborn as sns
import os
import warnings
warnings.filterwarnings("ignore")
plt.rc('font',family='Times New Roman')
from glob import glob
from osgeo import gdal,gdal_array,gdalnumeric
plt.rcParams['font.sans-serif']=['Simhei']  #显示中文
plt.rcParams['axes.unicode_minus']=False    #显示负号
数据加载
此处以部分测试数据为例,演示如何读取CSV格式的数据文件。
df = pd.read_csv('./JXDY_1.csv',encoding='utf-8')
df.head()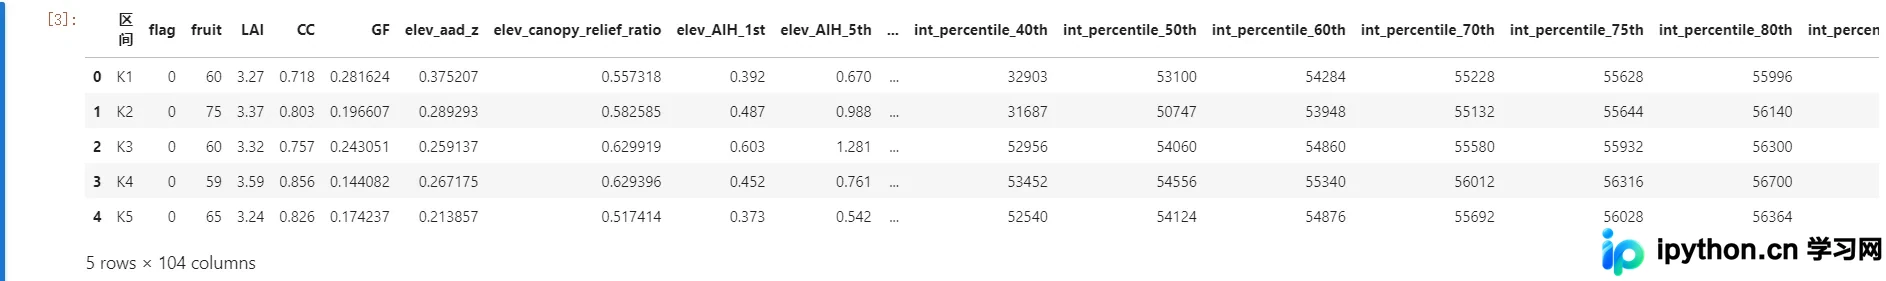
执行相关性分析
df.corr()#默认是pearson相关性分析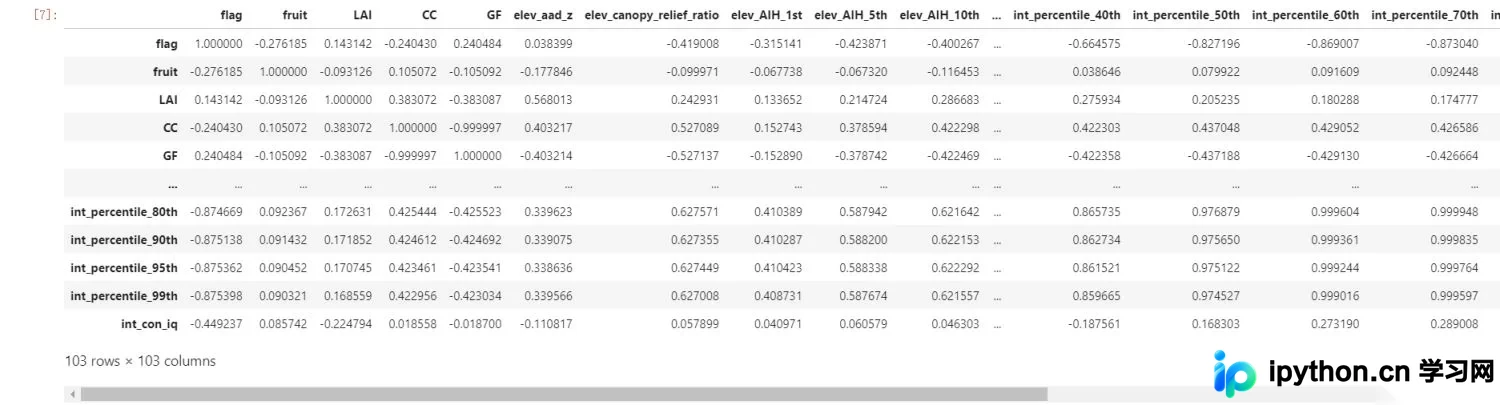
接下来进行批量散点图的生成,并将计算得到的相关性数据直接标注在对应的图形中。
a = 2#这里的相关性是从第二位开始进行计算的,所以我从第二位开始提取
for i in df.columns[3:]:
    a1 = sns.lmplot(y='fruit',x=i,data=df)
    ax = plt.gca()
    ax.text(0.9,1,"Pearson:{:.2f}".format(df.corr().iloc[1,a]),transform=ax.transAxes)#添加相关性
    a = a+1
plt.savefig('./{}.jpg'.format(i),dpi=300,bbox_inches = 'tight') 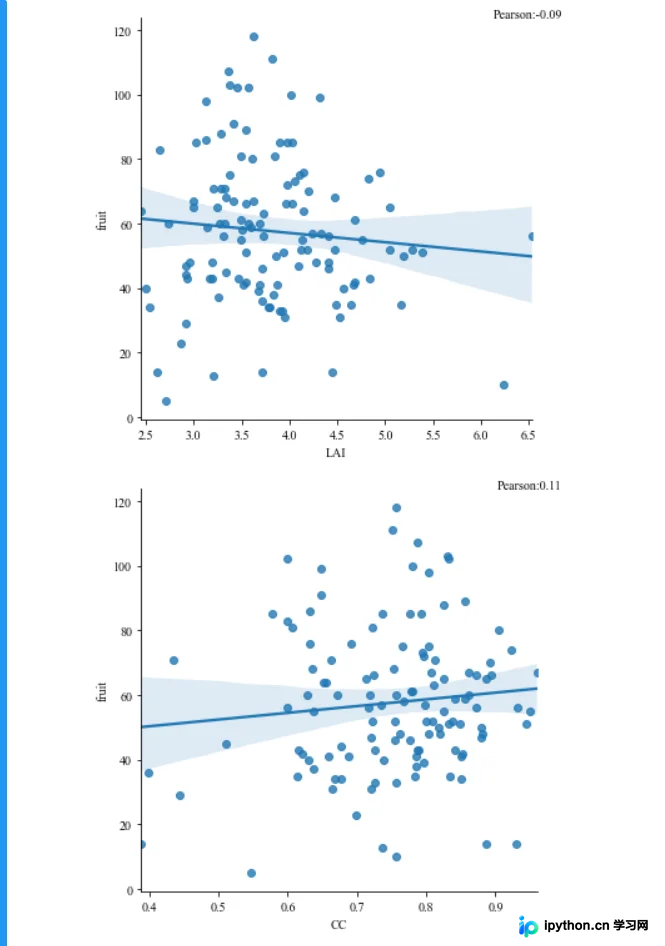
至此主要功能已完成,最后将生成的图像结果保存输出即可。
总结
本文到此结束,希望能为读者提供有益参考,欢迎继续关注本站获取更多技术内容。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















