


pandas初学者容易犯的六个错误总结

本文总结了pandas初学者在处理大规模数据集时常见的六个错误,包括使用read_csv读取大文件、未利用矢量化操作、未优化数据类型、忽略DataFrame样式设置、保存为CSV格式以及不阅读文档。通过对比实验,展示了使用datatable、NumPy矢量化、类型压缩及Parquet/Feather格式带来的显著性能提升,帮助开发者避免常见陷阱,提高数据处理效率。
本文探讨六个新手常犯的错误,这些错误与工具API或语法无关,而是直接关联使用者的知识储备与经验水平。若在实际操作中忽视这些问题,虽不会报错,但会引发严重的性能瓶颈与应用麻烦。
使用pandas自带的函数读取大文件
第一个错误涉及利用Pandas执行特定任务时的常见误区。现实中,我们处理的表格数据集往往规模庞大。此时,使用pandas的read_csv读取大文件是最大的失误。
原因在于速度极慢。参考以下测试:加载包含1M行、约300个特征、占用2.2GB磁盘空间的TPS十月数据集。
import pandas as pd
%%time

tps_october = pd.read_csv("data/train.csv")
Wall time: 21.8 s
read_csv耗时约22秒。或许有人觉得22秒并不长,但在项目中,需在多个阶段执行大量实验,包括创建用于清理、特征工程、模型选择等任务的独立脚本。多次等待数据加载20秒将累积成巨大的时间浪费。若数据集更大,耗时更久。那么,更快的解决方案是什么?
解决方案是在此阶段放弃Pandas,转而使用专为快速IO设计的替代方案。个人首选datatable,也可选择Dask、Vaex或cuDF等。以下是使用datatable加载相同数据集所需的时间:
import datatable as dt  # pip install datatble

%%time

tps_dt_october = dt.fread("data/train.csv").to_pandas()

------------------------------------------------------------

Wall time: 2 s
仅需2秒,差距达10倍。
没有矢量化
函数式编程的一条铁律是永远不要使用循环。在Pandas中,坚持“无循环”规则似乎是加速计算的最佳途径。
函数式编程用递归替代循环(尽管递归也有问题,此处暂不讨论)。对于科学计算,使用矢量化是最佳选择。
矢量化是Pandas和NumPy的核心,它对整个数组而非单个标量执行数学运算。Pandas已提供广泛的矢量化函数,我们无需重新发明轮子,只需关注计算逻辑本身。
在Pandas中,Python的大部分算术运算符(+、-、*、/、**)均以矢量化方式工作。此外,Pandas或NumPy中看到的任何其他数学函数均已矢量化。
为验证速度提升,我们将使用以下big_function,它接收三列输入并执行一些无意义的算术运算作为测试:
def big_function(col1, col2, col3):
    return np.log(col1 ** 10 / col2 ** 9 + np.sqrt(col3 ** 3))
首先,我们将此函数与Pandas最快的迭代器apply一起使用:
%time tps_october['f1000'] = tps_october.apply(
      lambda row: big_function(row['f0'], row['f1'], row['f2']), axis=1
    )

-------------------------------------------------

Wall time: 20.1 s
操作耗时20秒。让我们以矢量化的方式使用核心NumPy数组执行相同操作:
%time tps_october['f1001'] = big_function(tps_october['f0'].values,
                                          tps_october['f1'].values,
                                          tps_october['f2'].values)

------------------------------------------------------------------

Wall time: 82 ms
仅耗时82毫秒,速度提升约250倍。
事实上,我们无法完全抛弃循环,因为并非所有数据操作都是数学运算。但每当发现需要使用循环函数(如apply、applymap或itertuples)时,花时间思考是否可矢量化是一个极好的习惯。
数据类型,dtypes!
我们可以根据内存使用情况指定数据类型。
pandas中最糟糕且最耗内存的数据类型是object,这也限制了Pandas的部分功能。其余数据类型包括浮点数和整数。下表列出了pandas的所有类型:
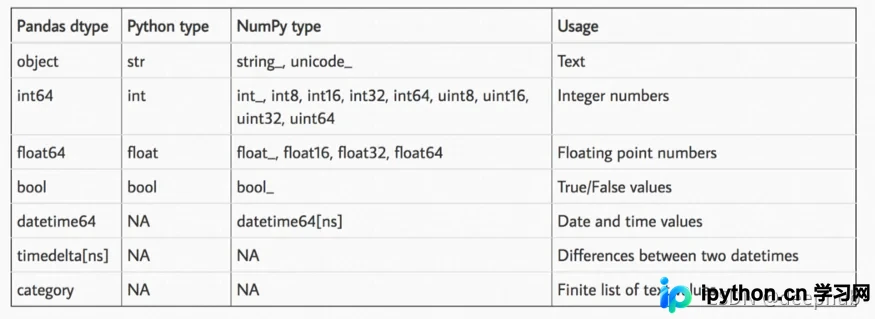
Pandas命名法中,数据类型名称后的数字表示每个数值占用的内存位数。因此,策略是将数据集中的每一列转换为尽可能小的子类型。判断规则如下表:
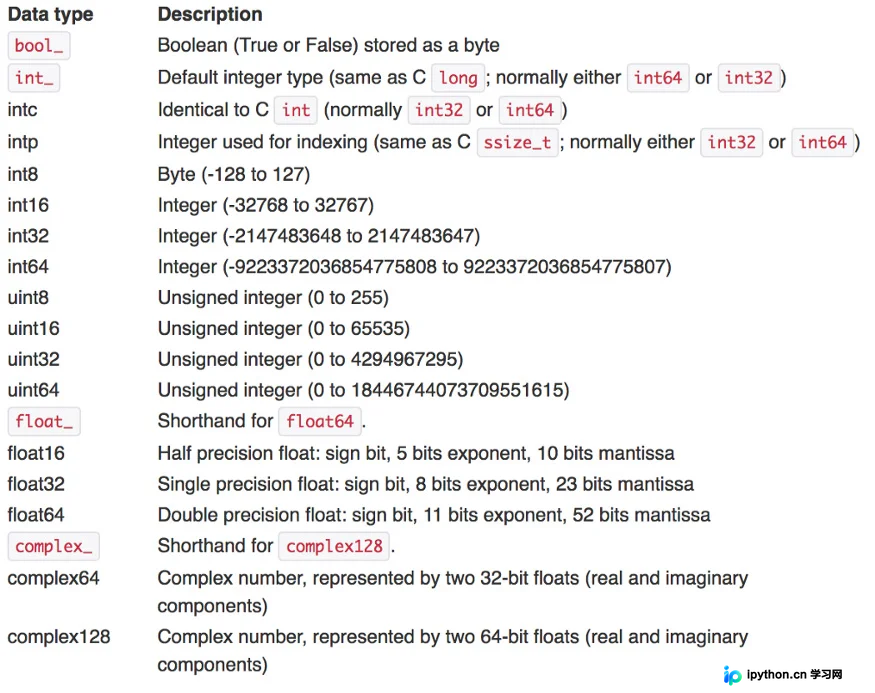
通常,根据上表将浮点数转换为float16或float32,将包含正负整数的列转换为int8、int16或int32。此外,可使用uint8处理布尔值和仅含正整数的列,以进一步减少内存消耗。
这个函数你一定很熟悉,因为它在Kaggle中被广泛使用,它根据上表将浮点数和整数转换为最小子类型:
def reduce_memory_usage(df, verbose=True):
    numerics = ["int8", "int16", "int32", "int64", "float16", "float32", "float64"]
    start_mem = df.memory_usage().sum() / 1024 ** 2
    for col in df.columns:
        col_type = df[col].dtypes
        if col_type in numerics:
            c_min = df[col].min()
            c_max = df[col].max()
            if str(col_type)[:3] == "int":
                if c_min > np.iinfo(np.int8).min and c_max < np.iinfo(np.int8).max:
                    df[col] = df[col].astype(np.int8)
                elif c_min > np.iinfo(np.int16).min and c_max < np.iinfo(np.int16).max:
                    df[col] = df[col].astype(np.int16)
                elif c_min > np.iinfo(np.int32).min and c_max < np.iinfo(np.int32).max:
                    df[col] = df[col].astype(np.int32)
                elif c_min > np.iinfo(np.int64).min and c_max < np.iinfo(np.int64).max:
                    df[col] = df[col].astype(np.int64)
            else:
                if (
                    c_min > np.finfo(np.float16).min
                    and c_max < np.finfo(np.float16).max
                ):
                    df[col] = df[col].astype(np.float16)
                elif (
                    c_min > np.finfo(np.float32).min
                    and c_max < np.finfo(np.float32).max
                ):
                    df[col] = df[col].astype(np.float32)
                else:
                    df[col] = df[col].astype(np.float64)
    end_mem = df.memory_usage().sum() / 1024 ** 2
    if verbose:
        print(
            "Mem. usage decreased to {:.2f} Mb ({:.1f}% reduction)".format(
                end_mem, 100 * (start_mem - end_mem) / start_mem
            )
        )
    return df
让我们在TPS十月份的数据上运行它,看看能减少多少内存:
>>> reduce_memory_usage(tps_october)
Mem. usage decreased to 509.26 Mb (76.9% reduction)
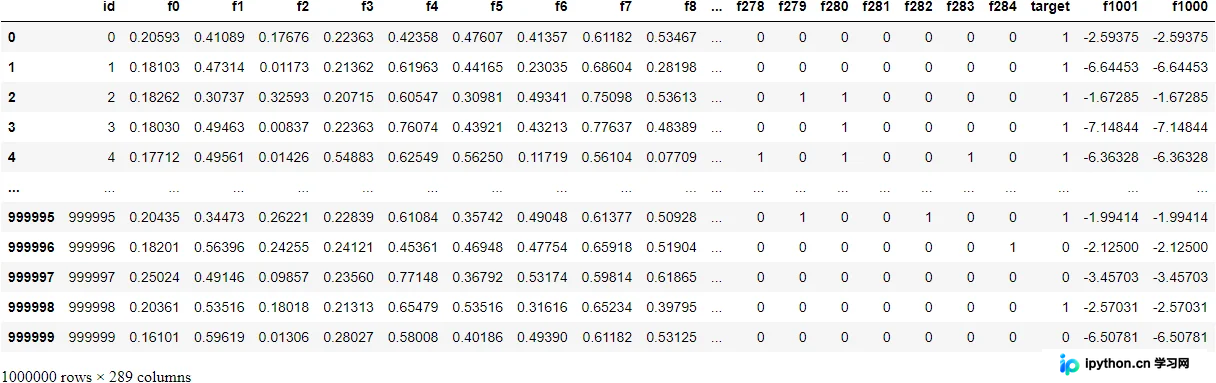
我们将数据集从原来的2.2GB压缩至510MB。当将df保存为csv文件时,这种内存消耗的减少会丢失,因为csv仍以字符串形式保存;但如果使用pickle保存,则没问题。
为什么要减小内存占用?在使用大型机器学习模型处理此类数据集时,内存占用和消耗至关重要。一旦遇到OutOfMemory错误,你就会开始追赶并学习此类技巧,让计算机保持高效工作(毕竟Kaggle只提供16GB内存,这都是逼出来的)。
不设置样式
Pandas最迷人的功能之一是能够在显示DF时设定不同样式,在Jupyter中将原始DF呈现为带有CSS HTML表格的形式。
Pandas允许通过style属性对其DataFrame进行样式设置。
tps_october.sample(20, axis=1).describe().T.style.bar(
    subset=["mean"], color="#205ff2"
).background_gradient(subset=["std"], cmap="Reds").background_gradient(
    subset=["50%"], cmap="coolwarm"
)
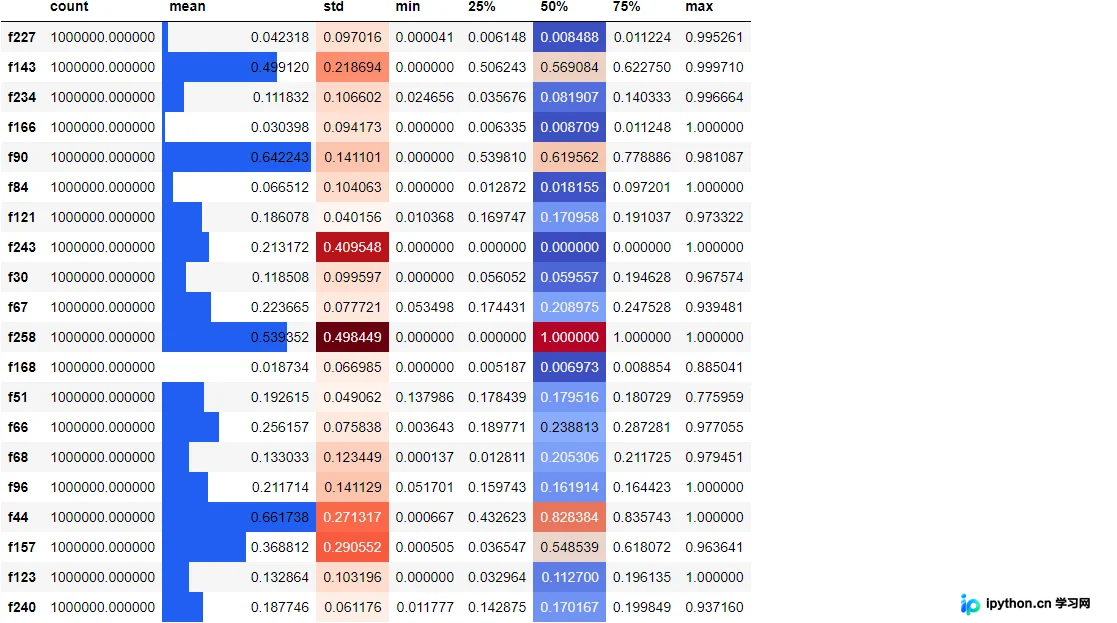
我们随机选择20列,为它们创建5位数的汇总,并转置结果,根据大小对均值、标准差和中值列着色。添加此类样式能让我们更轻松地发现原始数字中的模式,无需使用其他可视化库。
实际上,不对df进行样式设置并无过错。但这确实是一个很棒的功能,不是吗?
使用CSV格式保存文件
就像读取CSV文件非常慢一样,将数据保存回它们也是如此。以下是将TPS十月数据保存到CSV所需的时间:
%%time

tps_october.to_csv("data/copy.csv")

------------------------------------------

Wall time: 2min 43s
耗时近3分钟。为节省时间,可保存为parquet、feather甚至pickle。
%%time

tps_october.to_feather("data/copy.feather")

Wall time: 1.05 s

--------------------------------------------------------------------------------

%%time

tps_october.to_parquet("data/copy.parquet")

Wall time: 7.84 s
不看文档!
实际上,对我而言最严重的错误是没有阅读Pandas的文档。但通常没人会阅读文档,对吧?有时我们宁愿在互联网上搜索数小时也不愿阅读文档。
但当涉及Pandas时,这是一个巨大的错误。因为它像sklearn一样拥有出色的用户指南,涵盖从基础知识到如何贡献代码,甚至如何设置更漂亮的主题(也许正因为内容太多,所以没人看)。
我今天提到的所有错误均可在文档中找到。甚至在文档的“大型数据集”部分会专门建议阅读其他软件包(如Dask)以读取大文件并远离Pandas。其实,如果我有时间从头到尾阅读用户指南,我可能会提出50个新手错误,所以还是看看文档吧。
总结
今天,我们学习了新手在使用Pandas时最常犯的六个错误。
我们这里提到的错误大部分与大数据集有关,仅在使用GB大小的数据集时才可能出现。如果你还在处理泰坦尼克号这种新手数据集,你可能都不会感觉到这些问题。但是当你开始处理真实世界的数据集时,这些概念会让别人觉得你不是一个新手而是真正有过实际经验的人。
到此这篇关于pandas初学者容易犯的六个错误总结的文章就介绍到这了,更多相关pandas初学者易犯错误内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















