


Python Pandas实现两个表格内容模糊匹配:全连接与字典遍历两种方案

发布时间:2026-10-14 |
4人浏览过
本文介绍在Python中使用Pandas库对两个表格进行内容模糊匹配的方法。方法一通过全连接后筛选,逻辑简单但内存消耗大;方法二利用字典遍历,适合大数据集。文章提供了具体的代码实现、步骤解析及结果展示,帮助开发者高效处理文本匹配任务。
一、方法2
该方法的核心思路是构建两个表的共同字段,随后执行全连接操作,并对匹配结果进行筛选。此方案适用于数据量较小的场景,逻辑相对直观,但会占用较多的内存资源。
1. 导入库
import pandas as pd
import numpy as np
import re
2. 构建关键词
#关键词数据
df_keyword = pd.DataFrame({
    "keyid" : np.arange(5),
    "keyword" : ["numpy", "pandas", "matplotlib", "sklearn", "tensorflow"]
})
df_keyword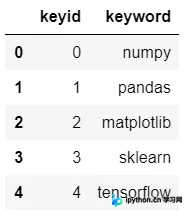
3. 构建句子
df_sentence = pd.DataFrame({
    "senid" : np.arange(10,17),
    "sentence" : [
        "怎样用pandas实现merge?",
        "Python之Numpy详细教程",
        "怎么使用Pandas批量拆分与合并Excel文件?",
        "怎样使用pandas的map和apply函数?",
        "深度学习之tensorflow简介",
        "tensorflow和numpy的关系",
        "基于sklearn的一些机器学习的代码"
    ]
})
df_sentence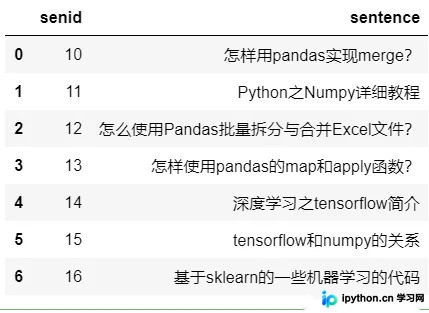
4. 建立统一索引
df_keyword['match'] = 1
df_sentence['match'] = 1
5. 表连接
df_merge = pd.merge(df_keyword, df_sentence)
df_merge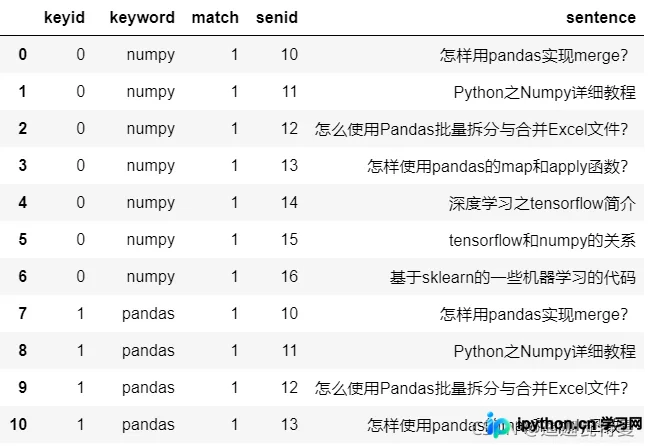
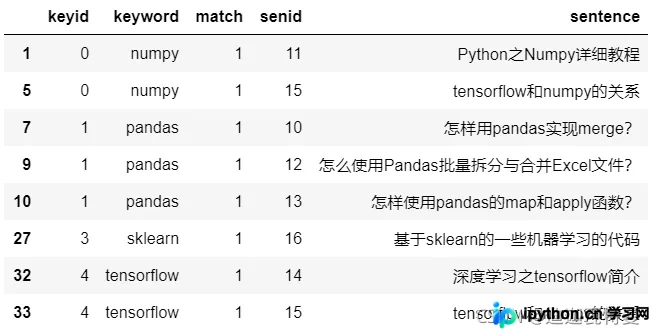
6. 关键词匹配
def match_func(row):
    return re.search(row["keyword"], row["sentence"], re.IGNORECASE) is not None
df_merge[df_merge.apply(match_func, axis = 1)]
匹配结果如下
二、方法2
此方法对编程能力有一定要求,但在处理大数据集时,其计算量相比方法一显著降低。
1. 构建字典
key_word_dict = {
    row.keyword : row.keyid
    for row in df_keyword.itertuples()
}
key_word_dict
{'numpy': 0, 'pandas': 1, 'matplotlib': 2, 'sklearn': 3, 'tensorflow': 4}
2. 关键词匹配
def merge_func(row):
    #新增一列,表示可以匹配的keyid
    row["keyids"] = [
        keyid
        for key_word, keyid in key_word_dict.items()
        if re.search(key_word, row["sentence"], re.IGNORECASE)
    ]
    return row
df_merge = df_sentence.apply(merge_func, axis = 1)
3. 结果展示
df_merge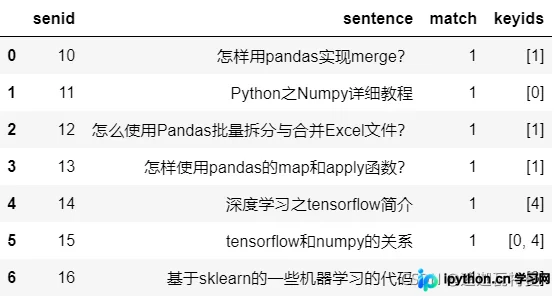
4. 匹配结果展开
df_result = pd.merge(
left = df_merge.explode("keyids"),
right = df_keyword,
left_on = "keyids",
right_on = "keyid")
df_result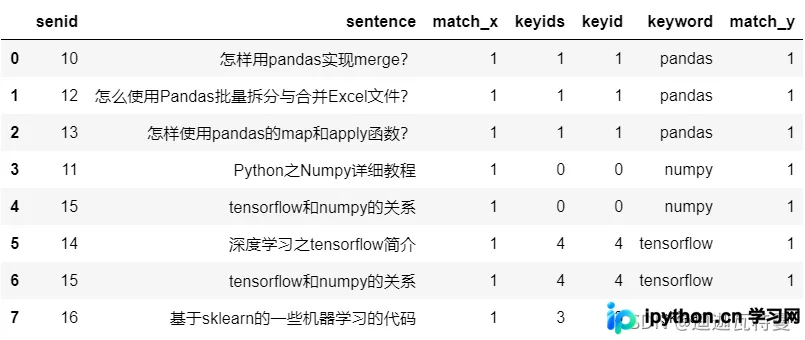
总结
到此这篇关于Python Pandas两个表格内容模糊匹配搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















