


MySQL是什么:开源关系型数据库管理系统详解

MySQL是一种关系型数据库管理系统,也就是常说的RDBMS。它的主要作用不是简单地“保存文件”,而是按照数据库、表、字段和记录这样的结构组织数据,并通过SQL完成查询、新增、修改、删除、统计和事务处理。网站用户信息、商品数据、订单记录、文章内容以及后台配置等,都可以存储在MySQL中。
理解MySQL时,可以抓住三个关键词:关系型、数据库管理系统、SQL。弄清这三个概念,再看一条SQL语句是怎样从应用程序进入MySQL并最终读写磁盘,基本就能理解MySQL在实际项目中的位置。
MySQL到底是什么
MySQL本身不是某一张数据表,也不是一个单独的数据文件,而是一套负责管理数据库的软件。应用程序通常把数据操作请求发送给MySQL,由MySQL负责找到对应的数据、执行规则检查、控制并发访问,并把结果返回给应用。
例如一个电商网站需要保存用户、商品和订单。如果直接把这些信息分别写进普通文本文件,随着数据量和访问人数增加,很快就会遇到查询困难、重复数据、多人同时修改以及数据一致性等问题。使用MySQL后,可以把这些数据拆成结构明确的数据表,再通过SQL建立它们之间的联系。
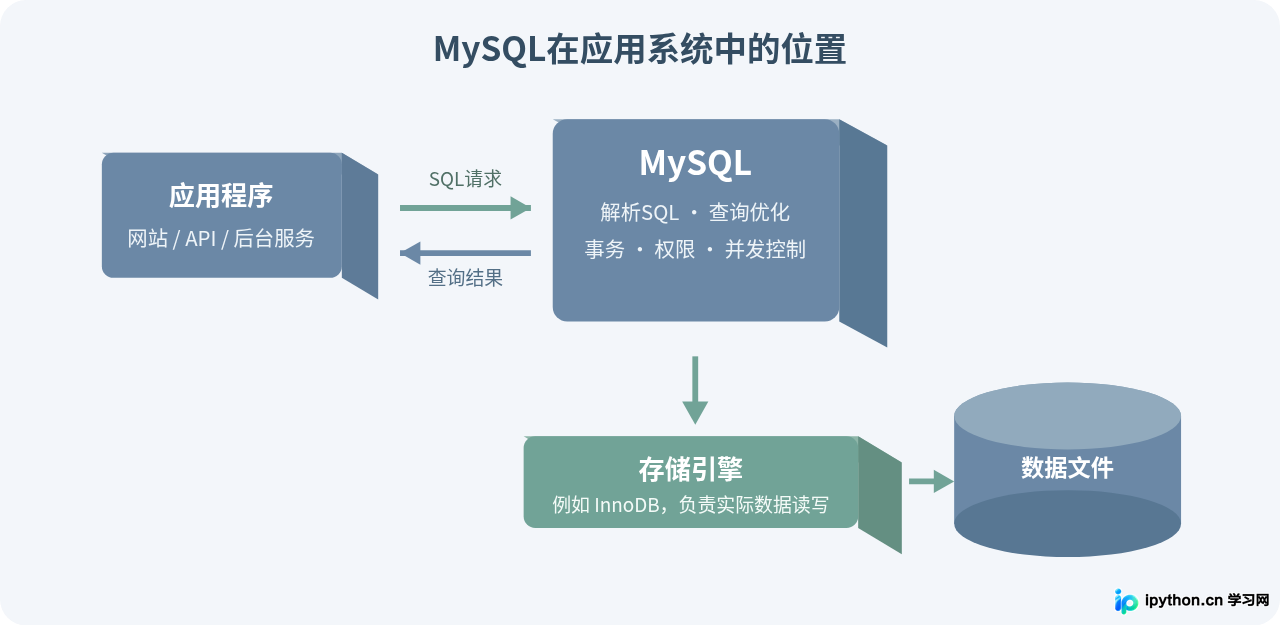
MySQL有开源的社区版本,同时也存在商业版本和相关商业服务。因此,“MySQL是开源数据库”主要是指其社区版本可以在相应开源许可证条件下获取、使用和研究,并不意味着围绕MySQL提供的所有产品和服务都免费。
为什么叫“关系型”数据库
“关系型”最直观的理解,是数据主要按照二维表组织,不同表之间还能通过字段建立联系。
假设一个网站有用户和订单。把用户姓名、手机号、每一笔订单全部塞进同一张表虽然也能保存,但同一个用户下多笔订单时,姓名和手机号会被反复记录。更常见的设计是把用户和订单分开:
users表保存用户本身的信息。orders表保存每一笔订单。orders.user_id指向对应用户的users.id。
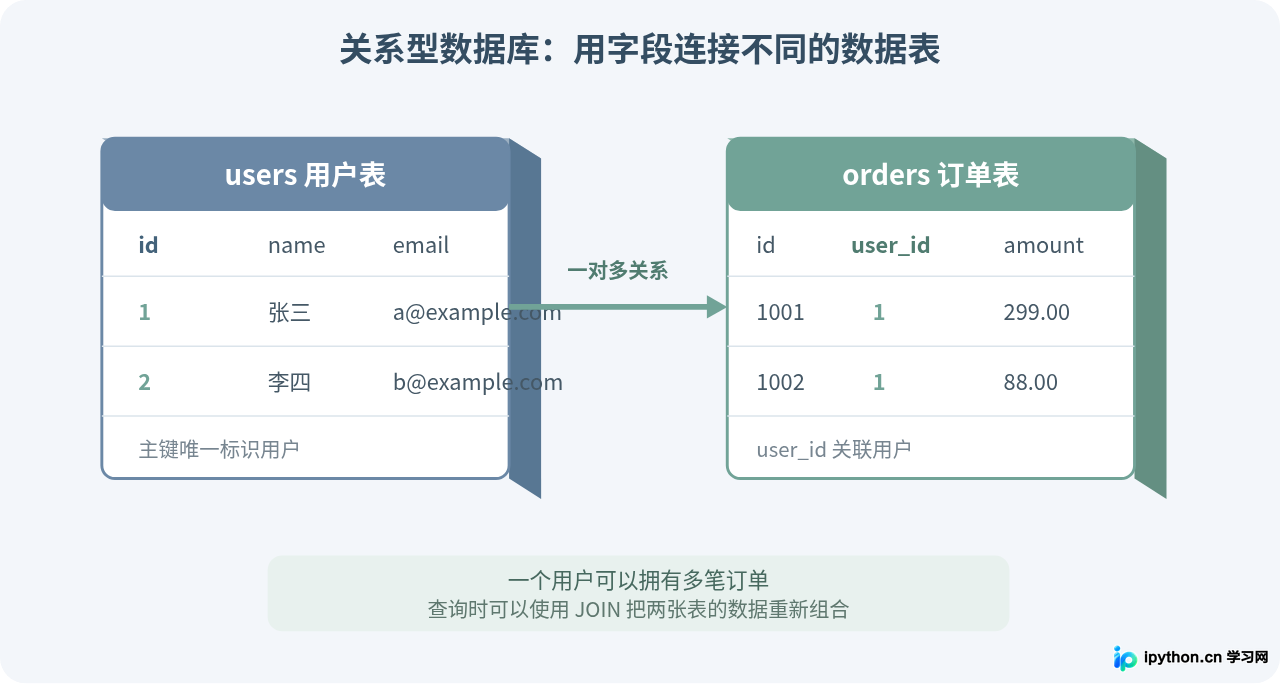
这种结构的好处是数据职责比较清楚。用户邮箱变化时,只需要修改用户表中的对应记录,不必寻找这个用户所有历史订单逐条修改。
在设计上,数据库还可以使用主键、唯一约束、外键等机制限制数据关系。不过是否使用外键,要根据系统架构、数据规模和业务要求决定,并不是所有MySQL项目都会使用数据库级外键。
数据库、表、字段和记录分别是什么
初学MySQL时,这几个词经常同时出现。可以把它们理解为逐层缩小的数据组织结构。
| 概念 | 作用 | 示例 |
|---|---|---|
| 数据库 Database | 用于组织一组相关的数据表 | shop_demo |
| 表 Table | 保存某一类结构相同的数据 | users |
| 字段 Column | 规定一项数据的名称和类型 | id、name、email |
| 记录 Row | 表中的一条完整数据 | 某个具体用户 |
例如 users 表规定了所有用户记录需要有哪些字段,而某一行则表示某一个具体用户。这种“先定义结构,再保存记录”的方式,是理解关系型数据库的基础。
MySQL为什么要使用SQL
SQL是用于操作关系型数据库的一类语言。应用程序不需要自己研究数据文件放在哪个磁盘位置,也不需要自己逐字节寻找记录,而是告诉MySQL“我要什么”。
例如,要查询编号为1的用户,可以发送:
SELECT id, name, email
FROM users
WHERE id = 1;
MySQL接收到语句后,会完成解析、权限检查、查询规划和数据读取等工作,再把结果返回给客户端。对于开发者来说,SQL负责表达操作目标,MySQL负责执行。
常见SQL操作可以归纳为四类:
SELECT:查询数据。INSERT:新增数据。UPDATE:修改已有数据。DELETE:删除数据。
实际项目中还会使用 CREATE TABLE、ALTER TABLE、索引、事务和权限管理等语句。
一条SQL语句进入MySQL后发生了什么
从应用程序的角度看,执行查询可能只是一行代码。但在MySQL内部,请求需要经过多个阶段。理解这个过程,有助于以后分析“为什么某条SQL很慢”“索引为什么有效”等问题。
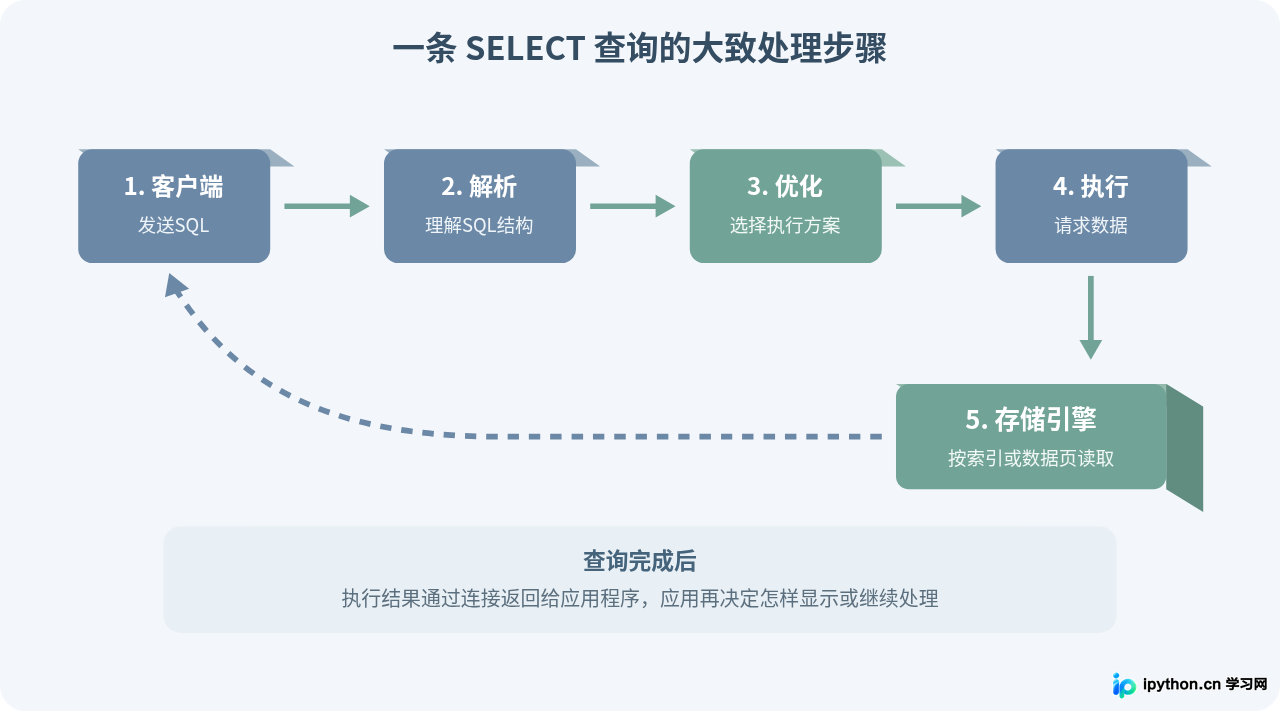
1. 客户端建立连接并发送SQL
PHP、Java、Python、Go等程序通常通过MySQL驱动连接数据库。连接时需要服务器地址、端口、账号、密码以及数据库名称等信息。
2. MySQL解析SQL
MySQL需要先判断SQL的结构和语法,弄清楚程序想访问哪些表、字段以及使用了哪些条件。语法错误通常会在这一阶段直接导致执行失败。
3. 优化器决定怎样查询
同一条查询可能存在不同执行路径。例如一个表有数十万条记录时,MySQL可能考虑使用某个索引,而不是把整张表从头到尾逐条检查。优化器会根据可用索引、查询条件和统计信息等选择执行计划。
4. 执行器和存储引擎读取数据
执行器按照计划工作,并通过存储引擎访问实际数据。MySQL支持存储引擎机制,而现代常见业务系统通常会使用支持事务、行级锁等能力的InnoDB。
这里可以看出,MySQL并不是简单地把SQL翻译成“读取文件”的动作。它还负责权限、事务、并发、索引使用以及数据一致性等许多数据库层面的工作。
用一个完整例子理解MySQL的基本操作
如果只是看概念,数据库、表和SQL容易混在一起。下面使用一个小型用户表示例,把创建数据库、创建表、插入数据和查询数据串起来。
假设已经安装MySQL,并通过命令行客户端进入MySQL服务器。下面的命令都在MySQL客户端中执行。
创建数据库
CREATE DATABASE shop_demo
CHARACTER SET utf8mb4;
然后选择这个数据库:
USE shop_demo;创建用户表
CREATE TABLE users (
    id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,
    name VARCHAR(50) NOT NULL,
    email VARCHAR(255) NOT NULL,
    created_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP,
    PRIMARY KEY (id),
    UNIQUE KEY uk_users_email (email)
) ENGINE=InnoDB;
这段定义中,id 是每个用户的唯一编号,并使用自动递增;name 保存姓名;email 保存邮箱;created_at 保存创建时间。
PRIMARY KEY 将 id 设置为主键,而 UNIQUE KEY 约束邮箱不能出现重复值。
插入两条数据
INSERT INTO users (name, email)
VALUES
('张三', 'zhangsan@example.com'),
('李四', 'lisi@example.com');
查询数据
SELECT id, name, email, created_at
FROM users
ORDER BY id;
示例结果可能类似:
+----+------+----------------------+---------------------+
| id | name | email                | created_at          |
+----+------+----------------------+---------------------+
|  1 | 张三 | zhangsan@example.com | 2026-09-18 20:00:00 |
|  2 | 李四 | lisi@example.com     | 2026-09-18 20:01:00 |
+----+------+----------------------+---------------------+
上面的时间只是为了说明结果格式的示例值,不代表实际执行时间。真正执行时,CURRENT_TIMESTAMP 会根据数据库服务器当时的时间生成值。
按照条件查询
SELECT id, name, email
FROM users
WHERE email = 'zhangsan@example.com';
因为 email 上建立了唯一索引,MySQL可以利用对应索引查找数据,而不必在普通情况下逐条扫描所有用户记录。
MySQL中的索引是什么
索引可以理解为为数据建立额外的查找结构。它的目的不是保存更多业务信息,而是帮助MySQL更高效地定位记录。
例如没有合适索引时:
SELECT *
FROM users
WHERE email = 'zhangsan@example.com';
MySQL在某些情况下可能需要检查大量记录。为 email 建立适合的索引后,可以通过索引快速缩小查找范围。
不过索引并不是越多越好。新增或更新数据时,相关索引也需要维护,而且索引本身会占用存储空间。因此真正的原则是:根据查询方式建立必要的索引,而不是给每个字段都加索引。
EXPLAIN 分析具体查询。
事务为什么是MySQL的重要能力
有些操作不能只完成一半。最典型的例子是账户之间转账:一个账户扣款以后,如果另一个账户因为错误没有增加余额,数据就会产生严重的不一致。
事务允许我们把多条SQL作为一个逻辑整体处理:
START TRANSACTION;

UPDATE accounts
SET balance = balance - 100
WHERE id = 1;

UPDATE accounts
SET balance = balance + 100
WHERE id = 2;

COMMIT;
如果中途发现问题,可以在满足相应条件时执行:
ROLLBACK;这样可以撤销本次事务中尚未提交的修改。实际系统还需要考虑事务隔离级别、异常处理、锁以及业务层重试等问题,但初学时先理解“多条相关操作作为一个整体提交或回滚”就足够了。
MySQL适合用在哪些地方
MySQL适合结构相对清晰、需要可靠查询和事务处理的数据。常见场景包括:
- 网站用户、账号和权限数据。
- 商品、分类、库存和订单数据。
- CMS中的文章、栏目、标签和评论。
- 企业后台中的客户、任务、财务记录等结构化信息。
- 需要使用SQL进行筛选、关联、排序、统计的数据系统。
WordPress就是一个很容易理解的例子。文章、用户、评论、站点配置等数据都需要长期保存,而且这些数据之间存在清晰关系,因此关系型数据库非常适合承担这类存储任务。
什么情况下不能只靠MySQL解决
MySQL用途很广,但数据库系统通常需要根据数据类型和访问方式选择,而不是看到“数据”就全部放进MySQL。
例如图片、视频、大型安装包等二进制文件,实际系统往往更适合保存在文件系统或对象存储中,然后在MySQL保存文件地址、尺寸、所属用户、创建时间等元数据。
搜索需求特别复杂时,也可能在MySQL之外增加专门的搜索系统;需要缓存高频数据时,可能增加缓存组件。这些系统不是简单地“替代MySQL”,而是承担不同类型的工作。
因此,判断MySQL是否合适时,可以先看数据是否具有明确结构、是否需要事务、是否需要SQL关系查询,以及访问规模和延迟要求。
MySQL和“数据库”是不是一回事
严格来说不是。
“数据库”可以指存放数据的逻辑集合,而MySQL是负责创建、管理和访问这些数据库的数据库管理系统。我们平时说“把数据放进MySQL数据库”,是一种比较自然的口语表达,但学习概念时最好区分:
- MySQL:数据库管理系统。
- shop_demo:在MySQL中建立的一个数据库。
- users:数据库中的一张表。
- 某个用户:表中的一条记录。
把这四个层级分清楚后,很多后续概念都会容易理解。
MySQL和SQL也不是同一个东西
SQL是一种用于描述数据库操作的语言,MySQL则是能够理解并执行SQL的关系型数据库管理系统之一。
因此,学习MySQL通常包含两个部分:一部分是学习SQL语法,例如查询、连接、分组和事务;另一部分是学习MySQL自身的实现和管理,例如索引、存储引擎、用户权限、备份恢复以及性能分析。
如果只会写 SELECT,并不等于已经掌握MySQL;反过来,如果只会安装MySQL服务器,却不会设计表和编写SQL,也很难真正使用数据库。
初学MySQL应该按照什么顺序理解
对刚接触数据库的人来说,没有必要一开始就研究复杂的集群、复制和底层存储结构。更合理的路径是先把数据组织和SQL操作学清楚,再逐步进入索引、事务和性能问题。
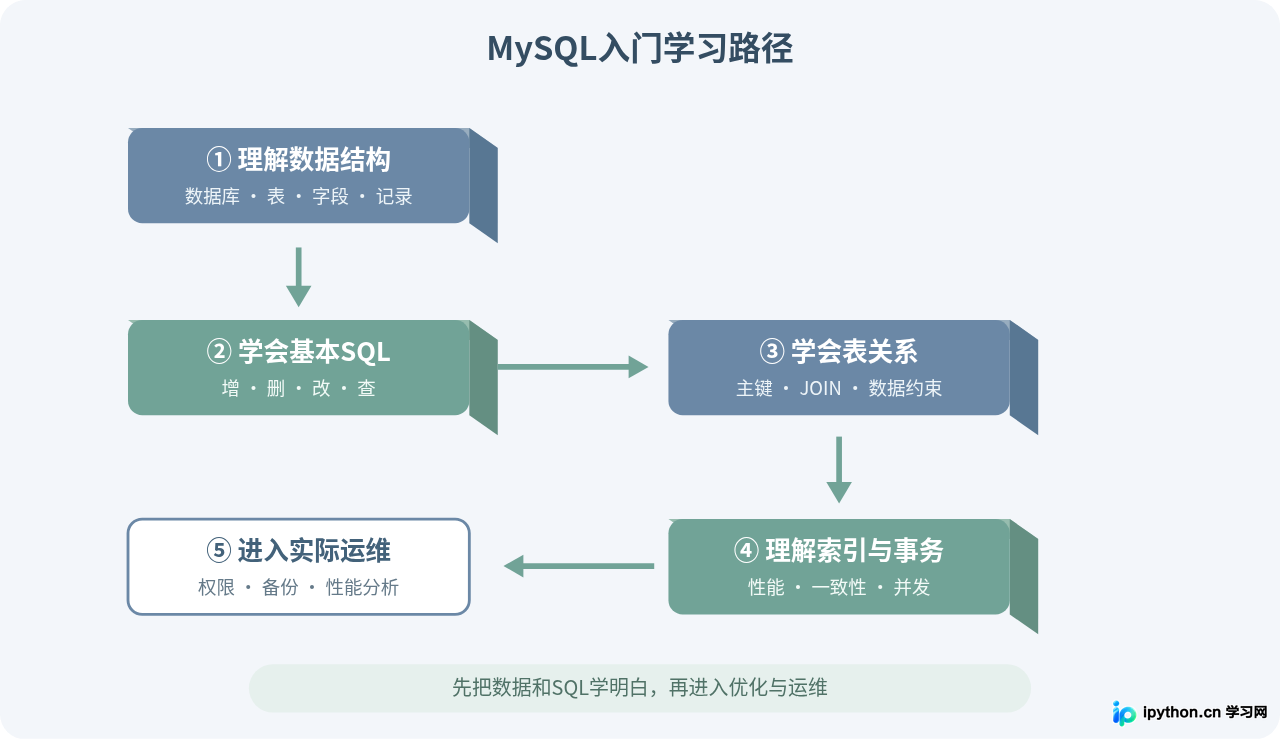
- 先理解数据库、表、字段、记录和数据类型。
- 掌握
SELECT、INSERT、UPDATE、DELETE。 - 学习主键、唯一约束、表关系以及
JOIN。 - 理解索引为什么能加快查询,以及索引会带来什么维护成本。
- 继续学习事务、锁和并发访问。
- 真正用于生产环境后,再系统学习账号权限、备份恢复、慢SQL分析和服务器配置。
理解MySQL时容易混淆的几个问题
MySQL只是网站数据库吗
不是。网站是MySQL很常见的应用场景,但只要系统需要管理结构化数据,就可能使用MySQL。后台管理系统、内部业务平台、API服务等同样可以使用。
装上MySQL以后就能自动保存网站数据吗
不能。MySQL只是提供数据库服务。应用程序还需要主动建立连接、创建所需的数据表,并在业务代码中执行SQL或通过ORM等工具进行数据操作。
会SQL就等于会MySQL吗
不完全等同。SQL解决的是如何表达数据库操作,而真正使用MySQL还需要了解表设计、索引、事务、字符集、权限、备份和性能分析等内容。
MySQL能不能保存中文
可以。实际创建数据库和数据表时需要正确选择字符集。现代应用通常会考虑使用 utf8mb4 来保存完整的Unicode字符。数据库、连接和应用程序之间的字符编码也应保持合理配置,避免出现乱码。
数据量大了以后是不是必须放弃MySQL
不能只根据“数据量大”这一点判断。MySQL能处理到什么规模,与表结构、索引、查询方式、硬件、并发量、数据增长方式以及整体架构有关。
当系统遇到性能瓶颈时,更合理的做法通常是先确定瓶颈究竟来自慢SQL、缺少索引、磁盘、内存、锁竞争还是架构问题,再决定是否需要缓存、读写分离、分库分表或引入其他类型的数据系统。
总结:应该怎样理解MySQL
MySQL可以理解为一套使用SQL管理结构化关系数据的数据库管理系统。它把数据组织成数据库和表,通过字段规定结构,通过记录保存实际内容,再利用主键、索引、事务以及表之间的关系解决数据查询和一致性问题。
从实际使用角度看,开发者通常不是直接处理磁盘中的数据文件,而是让应用程序把SQL发送给MySQL。MySQL解析和优化SQL,通过存储引擎完成数据访问,再把结果返回给应用程序。
对初学者而言,真正需要先掌握的并不是复杂的数据库架构,而是四件事:表是怎样组织数据的、SQL怎样读写数据、不同表怎样建立关系、索引和事务分别解决什么问题。把这几项理解清楚后,再继续学习性能优化、备份恢复和高可用架构,会顺畅很多。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















