


怎么通过合理选择MySQL数据类型节省存储空间并提升索引效率

在设计数据库表结构时,选定字段的数据类型往往是开发人员面对的第一道选择题。类型选型直接决定了单行数据的物理字节数,而存储体积的减小会产生显著的连锁反应:物理存储开销降低,单数据页能承载的索引键增多,B+树高度得以压低,InnoDB缓冲池(Buffer Pool)在命中相同内存空间时能常驻更多活跃节点,进而减少大量磁盘随机I/O。本文将从底层机制出发,系统解析核心数据类型的精简原则、选型方法及索引效率的优化路径。
一、底层原理:体积缩小如何转化为检索加速
许多开发者容易将“选择紧凑数据类型”简单视作节省磁盘容量的手段。事实上,在当今存储硬件成本相对低廉的背景下,选型带来的核心收益在内存利用率与索引检索路径上。
InnoDB存储引擎以“数据页(Page)”为基本I/O单元,默认页大小为16KB。无论是叶子节点存储完整行记录,还是非叶子节点存储索引键值与指针,其本质都是在固定容量的内存页内排列记录。当某个索引列从 BIGINT(8字节)缩减为 INT(4字节)时,包含指针在内的单条索引项尺寸大幅缩减,一个16KB的分支节点页能够容纳的分支数(即扇出系数 Fan-out)成倍上升。
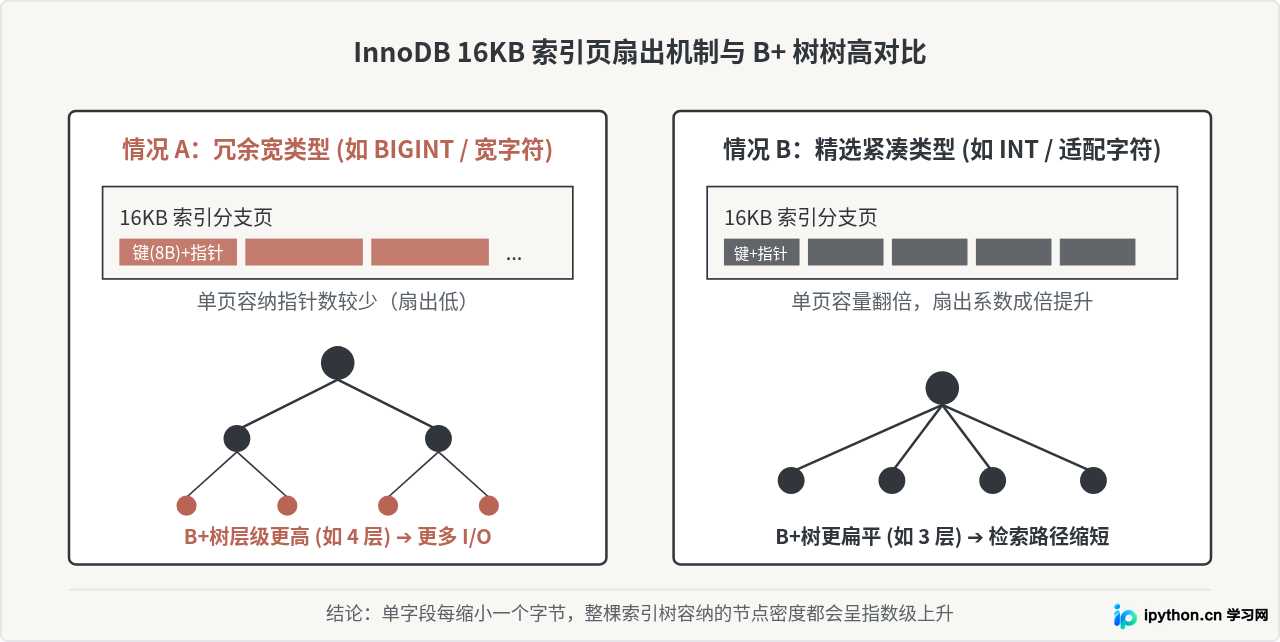
高扇出意味着相同的千万级数据量,B+树高度可以保持在3层以内甚至更低。索引每减少一层树高,就意味着在极端冷数据查询时减少一次磁盘寻道;而在日常读写中,紧凑的数据结构使得缓冲池能够驻留更全的索引与热点数据,大幅降低页面置换与缓冲区失效的概率。
二、数值类型的精确选型:放弃习惯性 BIGINT
在数值列的设计中,最常见的反模式是对所有整数毫无节制地分配 BIGINT。这不仅浪费了四倍的存储空间,也让联合索引快速膨胀。
| 数据类型 | 物理字节 | 有符号取值范围 | 无符号(UNSIGNED)范围 | 典型匹配业务 |
|---|---|---|---|---|
TINYINT |
1 Byte | -128 ~ 127 | 0 ~ 255 | 业务状态、逻辑删除标识、性别 |
SMALLINT |
2 Bytes | -32,768 ~ 32,767 | 0 ~ 65,535 | 省份/城市编号、短生命周期计数 |
MEDIUMINT |
3 Bytes | -8,388,608 ~ 8,388,607 | 0 ~ 16,777,215 | 中型平台用户ID、系统字典ID |
INT |
4 Bytes | 约 -21.47 亿 ~ 21.47 亿 | 0 ~ 42.94 亿 | 常规核心主键、外键关联、自增序号 |
BIGINT |
8 Bytes | -2^63 ~ 2^63 - 1 | 0 ~ 2^64 - 1 | 超大型流水订单号、毫秒级雪花ID |
选型判断法则
- 必须确定业务天花板: 若系统属于企业内部管理系统或业务体量明确不会突破千万级,
INT UNSIGNED(上限近43亿)足以应对主键需求,盲目采用BIGINT会造成主键索引体积直接翻倍,进而连带影响所有二级索引(因为InnoDB二级索引叶子节点均挂载主键)。 - 善用 UNSIGNED 扩展范围: 绝大多数流水号、计数器、状态值不会出现负数。添加
UNSIGNED属性可以在完全不增加存储字节的前提下,使正数上限提升一倍。 - 金额存储选择
DECIMAL还是BIGINT: 高频计算场景下,如果以“分”或“毫厘”为单位存储,推荐使用BIGINT存储整型分值(例如 100.50 元存为 10050),这样既能利用CPU的原生整型运算单元大幅提升排序与索引检索速度,又规避了浮点数精度丢失问题。如果业务需要严格的定点数展示,应使用DECIMAL(M, D),明确指定最小精度,避免超出实际需求的空置空间。
INT(11),括号内的数字仅代表客户端显示宽度(Display Width),对底层存储空间和数值上限完全没有影响。无论写 INT(1) 还是 INT(11),底层占用始终是固定的 4 字节。从 MySQL 8.0.17 开始,官方已废弃数值类型的显示宽度语法。
三、字符类型的优化:CHAR 与 VARCHAR 的权衡
字符串字段是索引开销最大的来源之一。字符类型如果选型不当,会导致索引节点容量迅速被字符串前缀耗尽。
CHAR 与 VARCHAR 的核心差异
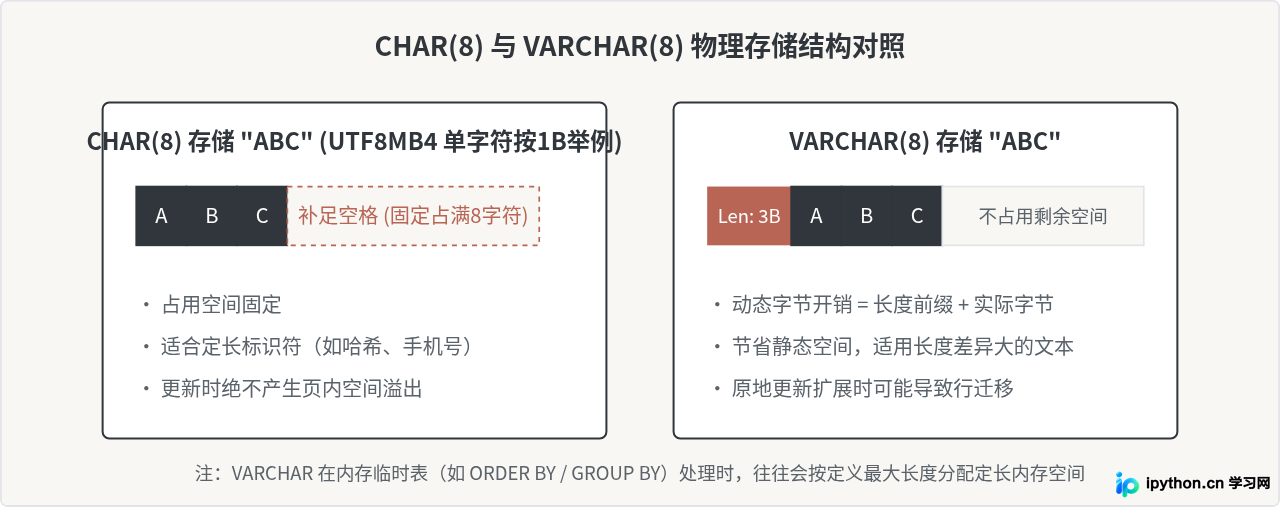
CHAR(N) 是定长存储。分配多长就占用多长,不足的部分在末尾补空格,读取时再去除。由于其偏移量完全固定,更新时不会产生由于长度变化而导致的数据页内碎片或行迁移。适合定长编码,如 MD5(32位)、UUID 去中划线版(32位)、手机号(11位)或国家地区双字代码(2位)。
VARCHAR(N) 是变长存储。除实际内容外,需要额外占用 1 或 2 个字节的长度前缀(当声明长度大于 255 字节时需 2 字节保存长度)。它只存储实际字符数,能显著节省行记录空间,但在频繁修改且字段长度大幅增长时,可能会引发 InnoDB 产生页分裂(Page Split)。
为什么不能滥用“VARCHAR(255)”
很多数据库设计者不管业务字段实际长短,统一指定 VARCHAR(255)。尽管在磁盘存储时按实际长度存,但在执行 ORDER BY、GROUP BY 或使用内部内存临时表进行复杂关联查询时,MySQL 会按照字段定义的最大长度去分配内存缓冲槽。过大的定义宽度会迅速撑满内存临时表,迫使 MySQL 将其转化为磁盘临时表(基于 MyISAM 或 InnoDB),引发严重的磁盘 I/O 阻塞。
利用前缀索引降低长字符索引用量
如果业务确实需要对较长的 VARCHAR(128) 或邮箱字段建立索引,无须对全列加索引。可以通过评估前缀区分度,只对前 N 个字符建立前缀索引:
-- 评估前缀字符的选择性(基数 Cardinality 比率)
SELECT
  COUNT(DISTINCT LEFT(email, 10)) / COUNT(*) AS pref_10,
  COUNT(DISTINCT LEFT(email, 15)) / COUNT(*) AS pref_15,
  COUNT(DISTINCT email) / COUNT(*) AS full_ratio
FROM user_account;

-- 当 pref_15 的区分度接近 full_ratio(如大于 0.95)时,创建 15 字符前缀索引
ALTER TABLE user_account ADD INDEX idx_email_prefix (email(15));ORDER BY、GROUP BY 排序,也无法满足覆盖索引(Covering Index)条件,因此依然需要结合具体查询链路做取舍。
四、时间与枚举类型:压缩存储的捷径
除了整数与文本,时间字段与离散选项也是空间被大量浪费的重灾区。
DATETIME 与 TIMESTAMP
DATETIME(MySQL 5.6.4 之后):占用 5 个字节(微秒根据精度 0~3 字节额外附加),存储格式与时区无关(原始字符串对应的数值表示)。支持时间跨度从1000-01-01到9999-12-31。TIMESTAMP:占用 4 个字节,底层存储为 UTC 时间戳整数。支持跨度从1970-01-01到2038-01-19。
对于系统操作日志、订单创建时间、审计追踪等在近几十年内生效的字段,无微秒精度要求的 TIMESTAMP 相比 DATETIME 节省 1 字节(20% 空间),且基于整型数值做区间查询和范围比对时,底层硬件比较指令更直接。
ENUM 与状态字替代 VARCHAR
对于取值完全可枚举的离散集合(如订单状态 'PENDING', 'PAID', 'SHIPPED', 'CANCELLED'),若直接使用 VARCHAR(16),哪怕字符集是 Latin1 也需 7~10 字节。改用 ENUM 或直接用 TINYINT 字典映射,底层只需 1 字节。在建立联合索引时,1 字节的整数比对开销与多字节字符串相比,执行分支流水线性能差异非常明显。
五、NOT NULL 与紧凑字段的综合优化工作流
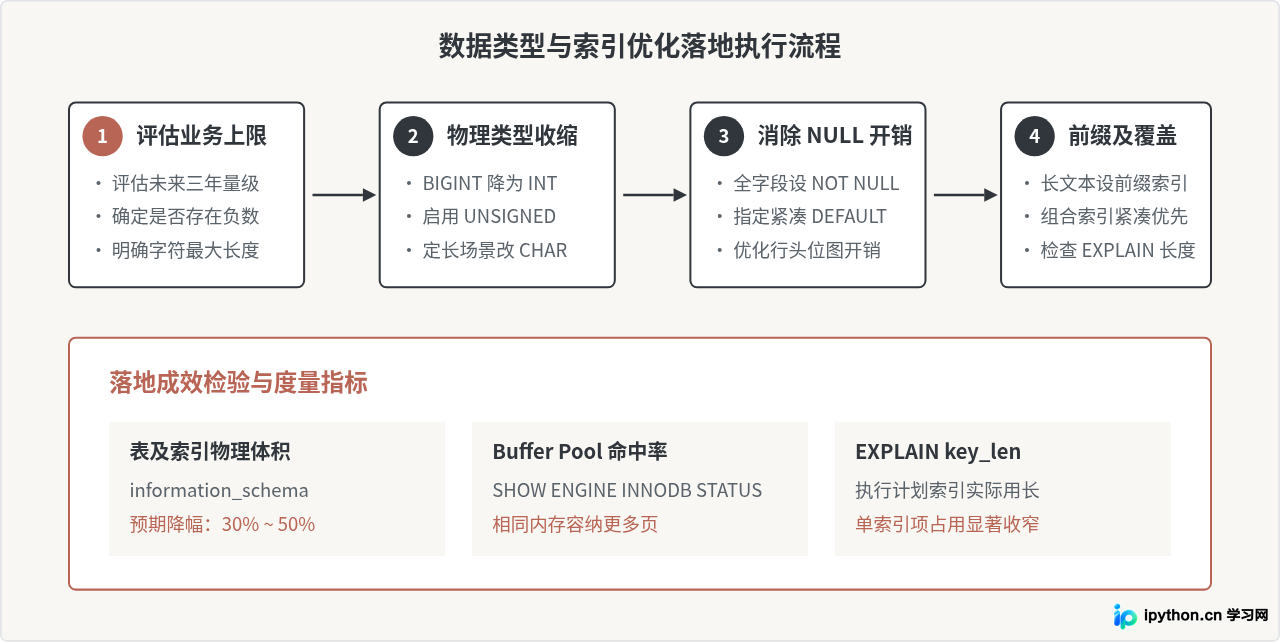
尽可能将字段声明为 NOT NULL。当列允许为 NULL 时,InnoDB 每一行记录的行头必须维护一个 NULL 值列表(Null Bitmask),用以标记该列是否为空。在索引树中,NULL 值的存在会导致索引统计信息失真,破坏复合索引的部分覆盖特性,并且比对操作需要额外的 IS NULL 特殊处理分支。
完整重构对比示例
下面是一个典型的重构示例。修改前是一个完全不考虑物理开销的宽泛表结构,修改后针对字段类型、默认值以及字符进行了精准收紧。
-- 优化前的反模式表设计(存储臃肿、索引宽大)
CREATE TABLE user_orders_bad (
    order_id BIGINT PRIMARY KEY,
    user_id BIGINT,
    status VARCHAR(255) DEFAULT NULL,
    phone VARCHAR(50) DEFAULT NULL,
    amount DECIMAL(18, 2) DEFAULT NULL,
    create_time DATETIME DEFAULT NULL,
    KEY idx_user_status (user_id, status)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

-- 优化后的紧凑表设计(存储精简、索引检索扇出高)
CREATE TABLE user_orders_good (
    order_id BIGINT UNSIGNED NOT NULL,              -- 明确流水号必须无符号且非空
    user_id INT UNSIGNED NOT NULL,                  -- 用户量在40亿内,INT 4字节足以替代 BIGINT 8字节
    status TINYINT UNSIGNED NOT NULL DEFAULT 0,     -- 状态字典 0~255,占 1 字节
    phone CHAR(11) NOT NULL DEFAULT '',             -- 手机号固定11位,定长 CHAR 规避变长开销
    amount_cents INT UNSIGNED NOT NULL DEFAULT 0,   -- 存分值(可支持4000多万元),计算高效
    create_time TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP, -- 仅占 4 字节
    PRIMARY KEY (order_id),
    KEY idx_user_status (user_id, status)           -- 复合索引 key_len 大幅缩减
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
通过 EXPLAIN 检查复合索引 idx_user_status 的 key_len 指标:
- 优化前:
user_id(8B) + NULL标记(1B) +status(255 × 4B + 2B长度 + 1B NULL标记) = 1032 字节。 - 优化后:
user_id(4B) +status(1B) = 5 字节。
索引条目尺寸从 1032 字节压缩到 5 字节,意味着一个 16KB 的非叶子节点页能容纳的索引项数量实现了数百倍的增长,联合索引从原本臃肿庞大的多层树简化为了极高扇出的极扁平结构。
六、总结与选型清单
通过合理选择 MySQL 数据类型来节省存储空间并提升索引效率,不是单一字段的微调,而是一套系统的设计工程。在创建或优化数据表时,建议遵循以下总结清单:
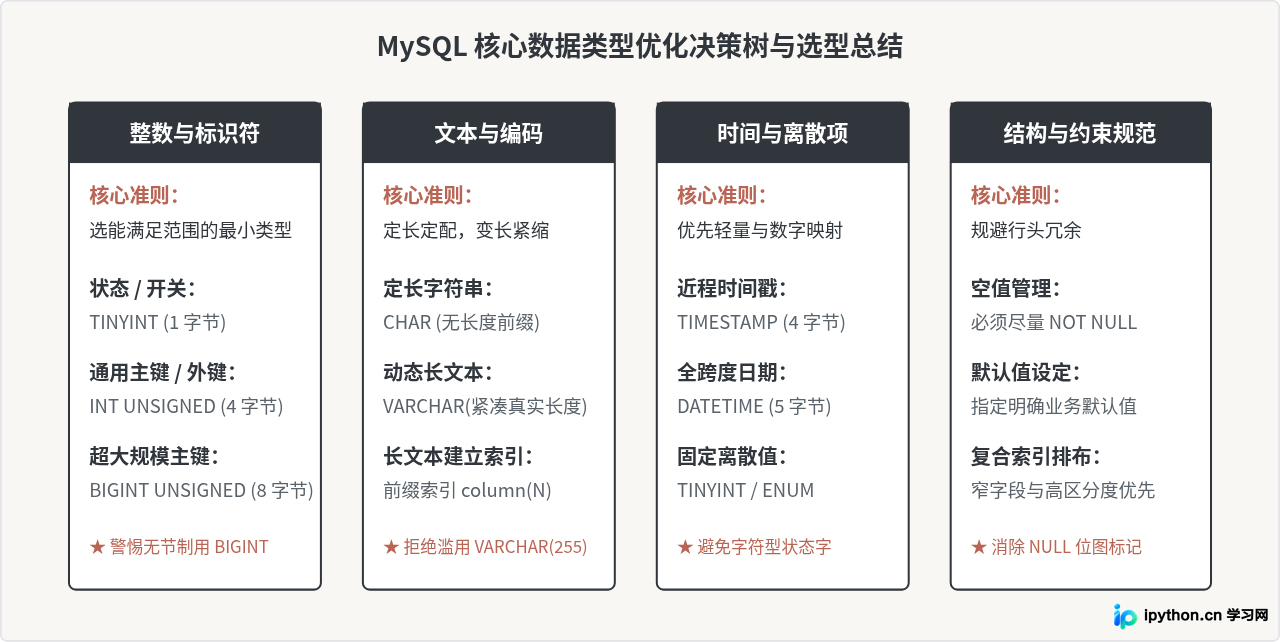
- 能小就别大: 选择刚好能包容业务生命周期上限的最小数据类型,利用
UNSIGNED把正整数容量翻倍。 - 严控变长定义的上限: 拒绝在每个文本列无脑使用
VARCHAR(255)。为字段按需分配长度,防止内存排序时占用过大临时内存块。 - 优先定长和整型运算: 对于状态值、布尔位和固定格式标识,优先使用
TINYINT、ENUM或CHAR,让 CPU 在比对索引键值时能够利用更直接的流水线指令。 - 坚决设置 NOT NULL: 为每列补齐明确的默认值,消除行头 NULL 掩码,保障复合索引的统计信息准确和覆盖检索纯粹。
只要在建表之初严格落实这几项标准,就能将物理存储开销压低 30% 到 50%,并在相同内存预算下让缓冲池容纳数倍的有效数据,最终实现查询性能与系统并发能力的大幅提升。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















