


Python写入CSV文件出现中文乱码怎么解决

发布时间:2026-10-11 |
3人浏览过
在使用 Python 写入 CSV 文件时,常会遇到中文字符显示为乱码的情况。本文将从根本原因入手,提供完整、可靠的解决方案,帮助你在不同平台和环境下都能正确保存中文。
一、乱码的根本原因
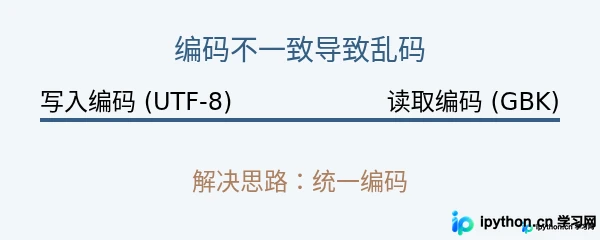
CSV 文件本质上是纯文本文件,字符的实际存储方式取决于所使用的编码。若写入时使用的编码与读取时的默认编码不一致,就会出现乱码。
二、常用解决方案
下面给出两种最常用的方式:
方式一:显式指定 UTF-8 编码
import csv

with open('data.csv', 'w', newline='', encoding='utf-8') as f:
    writer = csv.writer(f)
    writer.writerow(['姓名', '年龄', '城市'])
    writer.writerow(['张三', '28', '北京'])
方式二:使用 pandas 并设置 encoding 参数
import pandas as pd

df = pd.DataFrame({
    '姓名': ['张三', '李四'],
    '年龄': [28, 35],
    '城市': ['北京', '上海']
})
df.to_csv('data.csv', index=False, encoding='utf-8')
三、验证保存结果
完成写入后,可使用以下命令快速检查文件是否为 UTF-8 编码:
file -i data.csv输出类似于:
data.csv: text/csv; charset=utf-8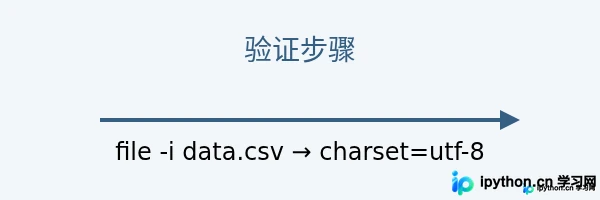
四、常见问题排查
- Windows 默认使用 GBK 编码,打开 CSV 时请选择 UTF-8 编码或使用记事本等编辑器。
- Excel 在导入时需要手动指定文件编码,否则会出现乱码。
- 若仍有乱码,可尝试在写入前对字符串进行
.encode('utf-8').decode('utf-8')预处理。
通过统一使用 UTF-8 编码,上述方法即可彻底解决 Python 写入 CSV 时的中文乱码问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















