


Python数据分析实战:异常值检测与处理指南

本文详解Python中异常值的定义及两种主流检测方法:基于正态分布的3σ原则和基于四分位距的箱型图法。通过Pandas库对啤酒数据集进行实战演练,展示如何定位并处理如abv字段中的极端离群值,提供完整的代码实现与索引定位技巧,帮助开发者掌握数据清洗核心技能。
异常值
异常值指的是样本中个别数值明显偏离其他观测值的点,也被称为离群点。对异常值的分析即是对离群点的分析过程。
常见的异常值检测方法包括3σ原则、箱型图分析以及机器学习算法。通常情况下,处理异常值的策略是删除或修正填补,这基于一个假设:异常值对整体项目影响较小。只有当分析目标明确指向找出并深入研究离群点时,才需使用机器学习算法,否则无需在此类分析上耗费过多精力。
1、异常值定义
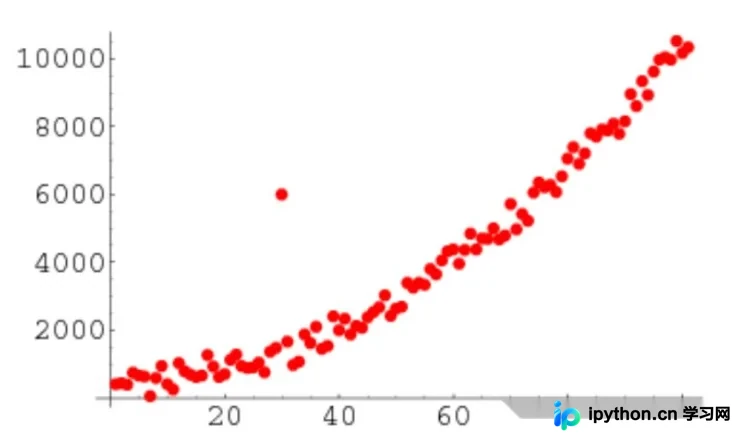
在统计学语境下,离群点是指不属于特定数据族群的数据点,其数值与其他观测值相距甚远。它是一种与结构良好的常规数据截然不同的观测值。
例如,在列表[20,24,22,19,29,18,4300,30,18]中,可以清晰地识别出离群点。
当观测值为一维数字时,辨别离群点相对容易;但若面对数以千计的观测值或多维数据,则需要采用更智能的方法来检测这些离群点。
2、异常值处理方式
2.1 均方差
3σ原则:若数据服从正态分布,根据3σ原则,异常值被定义为一组测定值中与平均值偏差超过三倍标准差的值。在正态分布下,距离平均值3σ之外的值出现的概率为 P(|x-μ|>3σ)<=0.003,属于极个别的小概率事件。若数据不服从正态分布,也可通过偏离平均值多少倍标准差来描述异常。
该原则有一个前提条件:数据需服从正态分布。
在3σ原则下,若观测值与平均值的差值超过3倍标准差,可将其视为异常值。正负3σ覆盖的概率为99.7%,距离平均值3σ之外的值出现概率为P(|x-μ| > 3σ) <= 0.003,属于极个别的小概率事件。
import numpy as np
import pandas as pd

def detect_outliers(data,threshold=3):
    mean_d = np.mean(data)
    std_d = np.std(data)
    outliers = []

    for y in data_d:
        z_score= (y - mean_d)/std_d
        if np.abs(z_score) > threshold:
            outliers.append(y)
    return outliers
2.2 箱形图
箱形图的构建利用了四分位间距(IQR)的概念。IQR是统计学中衡量统计分散度和数据可变性的概念,通过将数据集分成四分位来实现。
简单来说,任何数据集或一组观测值均可根据数值及其与整个数据集的比较情况,被划分为四个确定的间隔。四分位数将数据分为三个点和四个区间。
四分位间距对定义离群点至关重要,它是第三个四分位数与第一个四分位数的差(IQR = Q3 - Q1)。在此定义下,低于箱形图下触须(Q1 − 1.5 × IQR)或高于上触须(Q3 + 1.5 × IQR)的观测值被视为离群点。
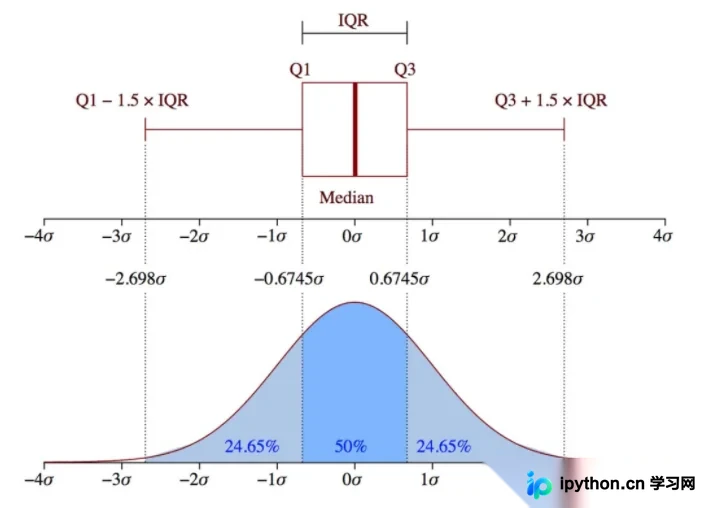
IQR是统计分散程度的度量,需借助箱线图观察。通常将小于 Q1 - 1.5 * IQR 或大于 Q3 + 1.5 * IQR的数据点视作离群点,探测公式为:
outliers = value < ( Q1 - 1.5 * IQR ) or value > ( Q3 + 1.5 * IQR )
这种探测方法是箱线图的默认方法,箱线图提供了识别异常值/离群点的标准:
异常值通常定义为小于 QL - 1.5 IQR 或大于 Qu + 1.5 IQR的值,其中QL为下四分位数,Qu为上四分位数,IQR为四分位数间距(即Qu与QL之差),其间包含了全部观察值的一半。
def detect_outliers(sr):
    q1 = sr.quantile(0.25)
    q3 = sr.quantile(0.75)
    iqr = q3-q1 #Interquartile range
    fence_low  = q1-1.5*iqr
    fence_high = q3+1.5*iqr
    outliers = sr.loc[(sr < fence_low) | (sr > fence_high)]
    return outliers
3、实战
介绍了上述数据基础知识后,接下来进入正题:利用Python与Pandas进行数据分析,主要目标是找出数据中的异常值(此处采用前述第一种方法)。
3.1 加载数据
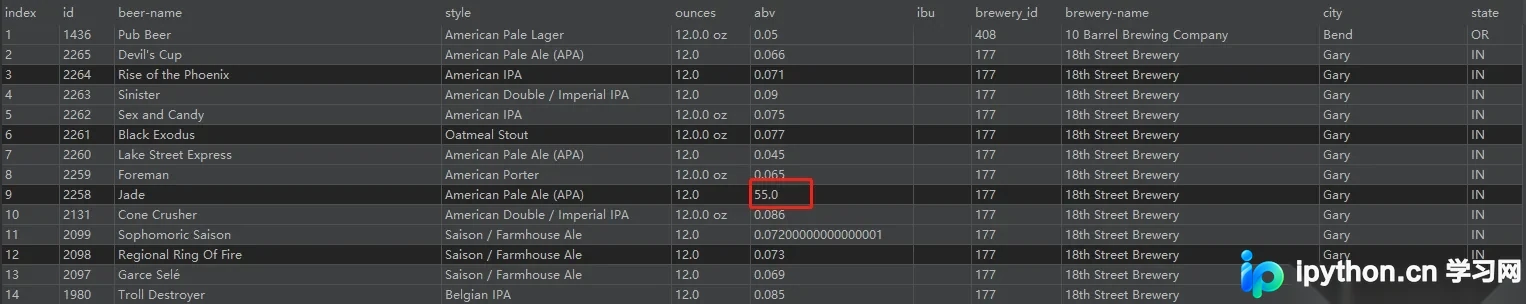
首先加载待分析数据,此处使用经过处理的beer数据集。可以看到abv属性列的值中大部分为0.0*,基本不超过1,但存在数值为55的数据,这些远大于其他数据的值即为我们需要处理的异常值。
class Repair_Dirty(object):
    __init_data = 0

    def __init__(self, filename):
        self.filename = filename

    def get_data(self):
        if self.filename == " ":
            # print("您输入的文件路径为空")
            return
        else:
            self.__init_data = pd.read_csv(self.filename)

        return self.__init_data

#主函数定义一个对象,并实现对方法的调用
if __name__ == "__main__":
    file_path = 'dirty_beer_last.csv'
    data_cla = Repair_Dirty(file_path)
    data = data_cla.get_data()#得到数据
数据图显示,红色框内数值为55的数据即为异常值,我们的目标是通过第一种方法将这些数据找出。
3.2 检测异常值数据
使用第一种检测方式,主要定义一个函数find_outlier(),该函数在类的内部实现。
    # 找到异常值,abv列
    def find_outlier(self, attribute):
        data_att = self.__init_data[attribute]
        # 找到异常值
        outlier = data_att[np.abs(data_att - data_att.mean()) > 3 * data_att.std()]
        print(data.loc[data[attribute] == 55])#对abv属性的异常值进行输出
        #print(np.where(self.__init_data[attribute] == 55))  # 返回指定位置的索引
        return outlier
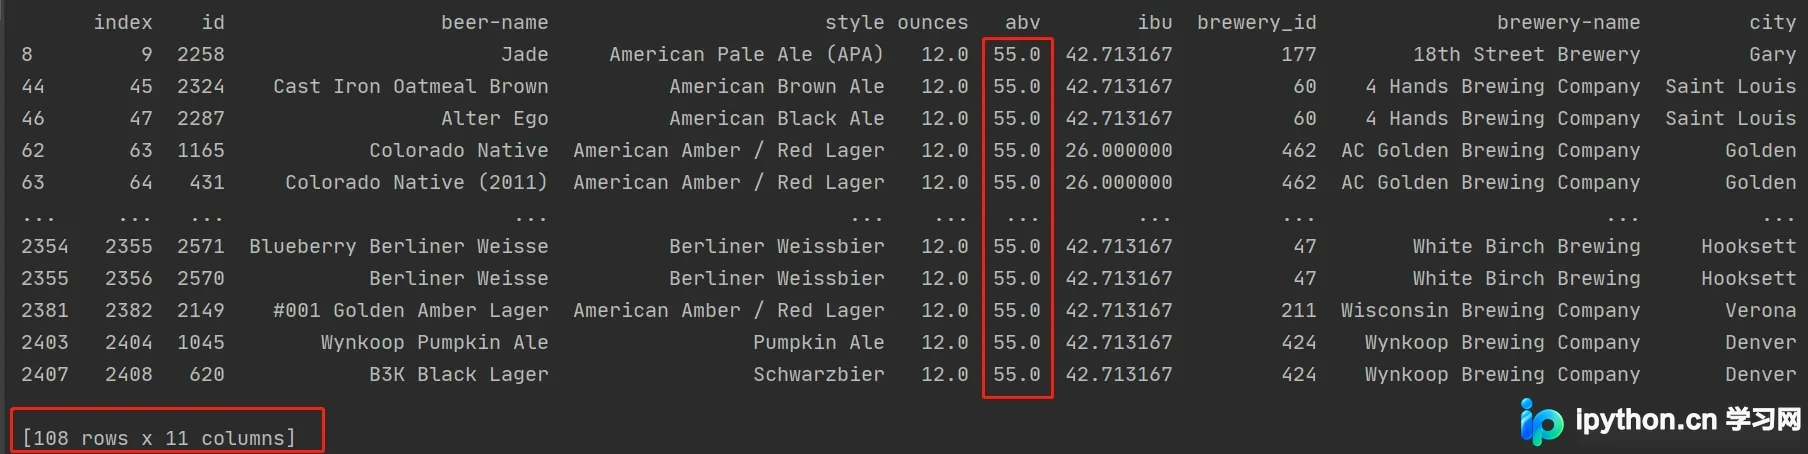
从图片可见,整个数据表108行数据中abv值为55的已被识别,基本达到预期目标。根据索引或ID,即可进行值替换操作,对异常值进行修复。
3.3 显示异常值的索引位置
既然已找到异常值,再对其进行索引显示便较为简单,仅需一行代码。虽然上述代码中已包含此逻辑(被注释掉),现将其单独提取显示。
print(np.where(self.__init_data[attribute] == 55)) # 返回指定位置的索引
这行代码用于显示异常值的索引位置。
至此,关于Python数据分析中异常值处理的博文内容结束。小张同学仍在持续学习中,希望本文能帮助正在学习数据分析的读者。 奥利给
最后附上源代码,有需要的读者可自行获取。
import pandas as pd
import numpy as np
import re

class Repair_Dirty(object):
    __init_data = 0

    def __init__(self, filename):
        self.filename = filename

    def get_data(self):
        if self.filename == " ":
            # print("您输入的文件路径为空")
            return
        else:
            self.__init_data = pd.read_csv(self.filename)

        return self.__init_data

	# 找到异常值,abv列
    def find_outlier(self, attribute):
        data_att = self.__init_data[attribute]
        # 找到异常值
        outlier = data_att[np.abs(data_att - data_att.mean()) > 3 * data_att.std()]
        print(data.loc[data[attribute] == 55])#对abv属性的异常值进行输出
        print(np.where(self.__init_data[attribute] == 55))  # 返回指定位置的索引
        return outlier

if __name__ == "__main__":
    file_path = 'dirty_beer_last.csv'
    data_cla = Repair_Dirty(file_path)
    data = data_cla.get_data()
    print((data))
    if data is None:
        print("路径为空,程序退出!!!")
    else:
        data = data_cla.fill_na()
        outlier = data_cla.find_outlier()
        print(outlier)
总结
到此这篇关于Python数据分析实战指南之异常值处理的文章介绍完毕,更多相关Python异常值处理内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















