


新手怎么编写第一个Python爬虫:环境配置与代码实现

编写第一个 Python 爬虫的核心目标是实现自动化网络数据获取与结构化提取。完成这项任务分为明确的两个阶段:首先搭建纯净的 Python 开发环境,安装负责网络通信的 requests 库与负责 HTML 标签解析的 BeautifulSoup4 库;随后编写简洁的脚本,向结构规范的公开测试网页发起 HTTP 请求,将返回的网页源码转化为 DOM 树并提取出目标文本。本文按实际操作顺序,详细讲解从环境检查、依赖配置、代码编写到运行验证与错误排查的完整流程。
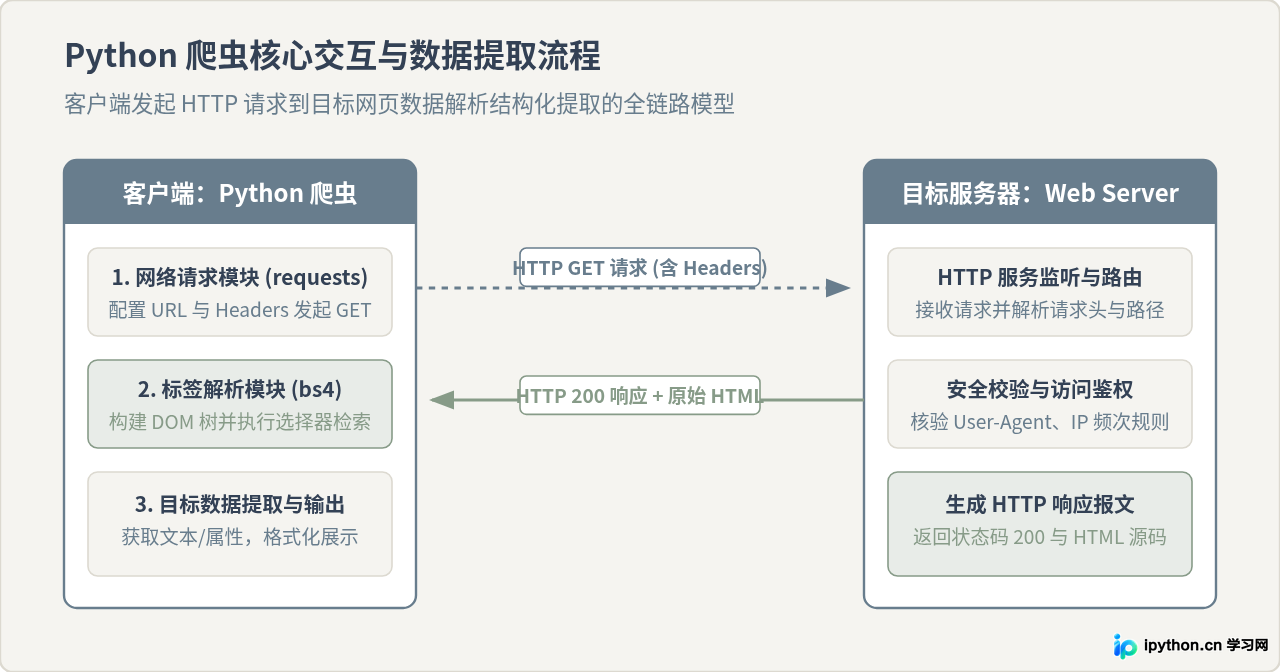
一、网络爬虫的工作机制与核心交互流程
网络爬虫在本质上是一个自动化的 HTTP 客户端。当我们在浏览器中输入网址并按下回车时,浏览器会向目标服务器发送网络请求,服务器返回 HTML 网页源码,最后浏览器将这些代码渲染为可视化的图形界面。Python 爬虫做的事情与之类似,但省去了渲染步骤:程序通过代码直接向服务器请求指定的 URL 地址,获取包含页面数据的原始 HTML 字符串,再利用解析工具从中精准提取所需的字段内容。
在这个交互过程中,爬虫主要处理两个环节:一是网络传输层面的“请求与响应”,二是数据处理层面的“解析与提取”。理解这两个环节的分工,是编写和调试爬虫代码的基础。
二、开发环境准备与核心依赖库安装
在编写爬虫代码前,需要确保本地计算机已经安装了 Python 解释器,并为项目配置独立的虚拟环境,以避免不同项目间的第三方库版本相互干扰。
1. 检查 Python 运行环境
打开操作系统自带的终端(macOS/Linux 下为 Terminal,Windows 下为 PowerShell 或命令提示符),执行以下命令检查 Python 版本:
python3 --versionPython 3.11.5若输出的版本号高于或等于 3.8,说明解释器环境已就绪。若提示命令不存在,需前往 Python 官方网站下载并安装对应系统的安装包,并确保勾选了将 Python 添加至系统环境变量的选项。
2. 创建并激活项目虚拟环境
建议为当前爬虫建立独立的工作目录与虚拟环境。在终端中依次执行以下命令:
mkdir my_spider
cd my_spider
python3 -m venv venv
虚拟环境创建完成后,需要将其激活。在 macOS 或 Linux 系统下执行:
source venv/bin/activate在 Windows PowerShell 中执行:
.\venv\Scripts\Activate.ps1激活成功后,命令行提示符最前端会出现 (venv) 标识,表示后续安装的依赖库均归属于当前项目沙箱。
3. 安装第三方核心库
编写基础爬虫需要安装两个核心库:用于发起网络请求的 requests,以及用于解析网页文档结构的 beautifulsoup4。在已激活的终端中执行:
pip install requests beautifulsoup4Successfully installed beautifulsoup4-4.12.3 requests-2.31.0 urllib3-2.2.14. 验证模块导入
安装完成后,通过单行代码验证两个库是否能被正常导入:
python3 -c "import requests, bs4; print('环境安装正常')"环境安装正常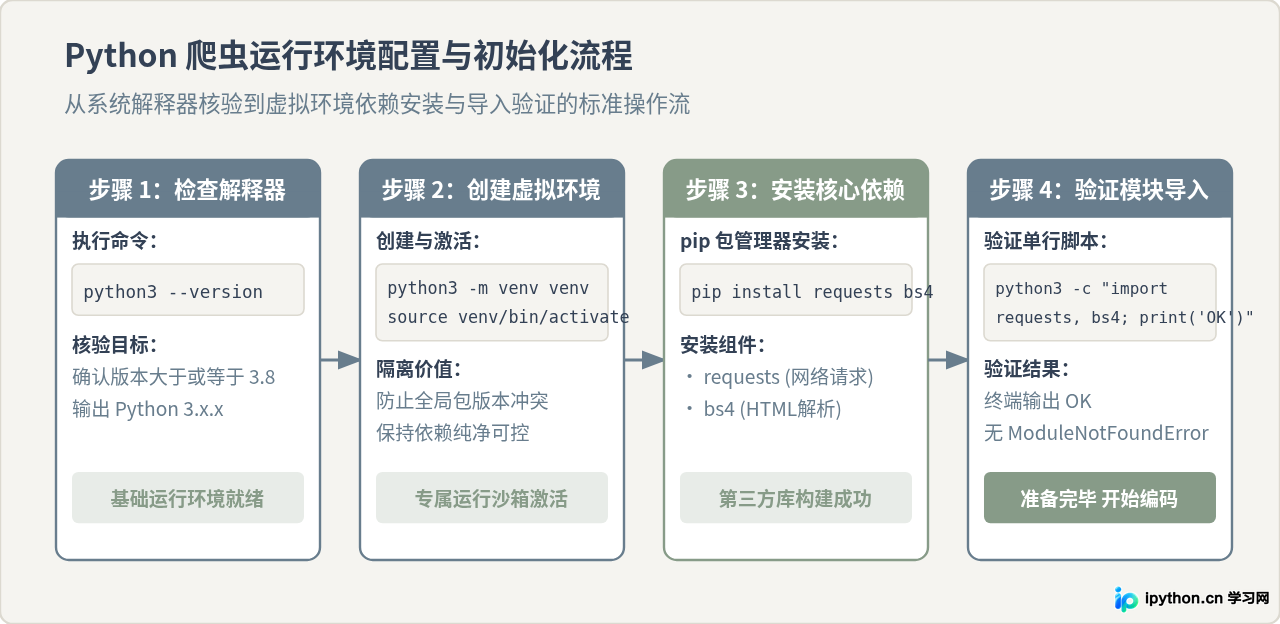
三、关键机制对比:直接正则表达式匹配与 DOM 树解析
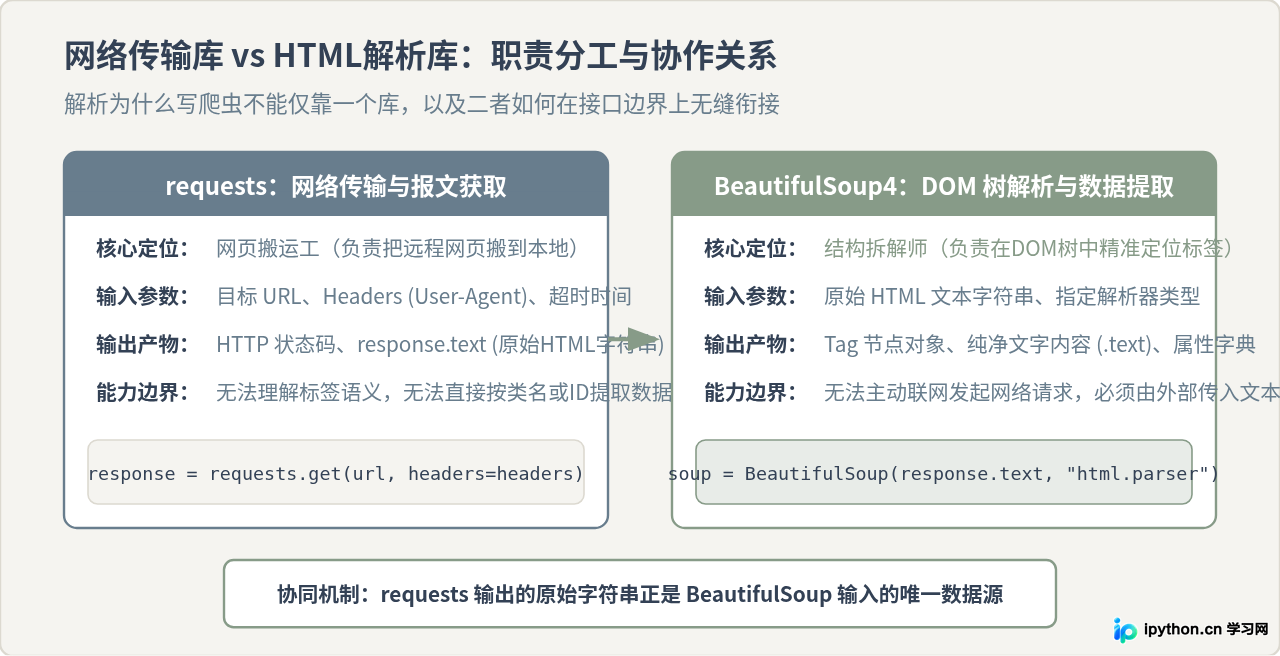
许多初学者在初次接触网页数据提取时,容易产生疑问:既然 requests.get() 拿回来的网页源码本质上是一串纯文本,为什么不直接用 Python 自带的 re 模块写正则表达式抓取,而一定要引入体积更大的 BeautifulSoup4 呢?在处理 HTML 数据时,这两种方式在一致的提取目标下存在本质差异。
在相同的数据提取需求下,两者的核心差异体现在对文档结构的容错能力与维护成本上:
- 属性排版与空白容错:正则表达式依赖严格的字符连续序列。如果目标网页将
<span class="text">调整为<span id="first" class="text">或在属性间增加了换行与多余空格,原先编写的正则模式就会立即匹配失败。而 DOM 树解析器将 HTML 解析为节点对象,按节点属性检索,无论属性顺序或排版如何改变,都能稳定准确定位。 - 嵌套层级与闭合容错:真实网站的 HTML 往往存在大量多层嵌套(例如
<div><div>...</div></div>)或者不严谨的未闭合标签。正则表达式无法在任意嵌套层级下可靠区分内层与外层闭合;而BeautifulSoup4内置的解析引擎会自动根据 HTML 规范纠正缺失标签并构建完整的父子、兄弟层级树,支持直接向上追溯父容器或向下遍历子元素。 - 职责边界清晰度:
requests负责纯粹的网络传输,将远程数据完整拉取到本地内存;BeautifulSoup4则专门负责解析结构并提取信息。分工明确的流水线结构让代码逻辑更加清晰,便于后续独立排查网络故障或解析规则变更。
四、编写第一个爬虫代码:分步拆解与完整实现
本节以公开且合法的爬虫练习站点 quotes.toscrape.com 为抓取对象,目标是抓取首页展示的名言内容以及对应的作者名称。在项目目录下新建名为 spider.py 的文件,编写完整爬虫程序。
1. 关键代码分步解析
第一步是配置目标地址与请求头。很多网站会检查客户端发送的 User-Agent 标识,如果检测到默认的 Python 请求头,可能会直接拒绝访问。因此,显式声明常见的浏览器标识是爬虫开发的良好规范:
target_url = "https://quotes.toscrape.com/"
headers = {
    "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}
第二步是发起请求并解析页面。使用 requests.get() 发送 GET 请求,设置 10 秒超时避免程序无限挂起。当返回的状态码为 200 时,将 response.text 传入 BeautifulSoup 构建解析树:
response = requests.get(target_url, headers=headers, timeout=10)
if response.status_code == 200:
    soup = BeautifulSoup(response.text, "html.parser")
第三步是定位与提取节点。通过浏览器的“检查元素”工具查看网页结构,可以发现每条名言都被包裹在一个 <div class="quote"> 容器中。名言文字位于其内部的 <span class="text">,作者名称位于 <small class="author">。在 Python 中使用 find_all() 批量获取卡片后逐个读取文本:
quote_elements = soup.find_all("div", class_="quote")
for elem in quote_elements:
    text = elem.find("span", class_="text").text.strip()
    author = elem.find("small", class_="author").text.strip()
    print(f"{text} —— {author}")
2. 完整的 spider.py 代码实现
以下是整合了异常状态判断与数据清晰打印的完整脚本:
import requests
from bs4 import BeautifulSoup


def fetch_quotes():
    # 1. 目标地址与请求头配置
    url = "https://quotes.toscrape.com/"
    headers = {
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }

    print(f"正在向目标地址发起请求: {url}")
    try:
        # 2. 发起网络请求
        response = requests.get(url, headers=headers, timeout=10)
        response.raise_for_status()
    except requests.exceptions.RequestException as error:
        print(f"网络请求发生异常: {error}")
        return

    # 3. 构造 BeautifulSoup 解析树
    soup = BeautifulSoup(response.text, "html.parser")

    # 4. 定位所有名言卡片节点
    quote_blocks = soup.find_all("div", class_="quote")
    print(f"成功获取页面,解析到 {len(quote_blocks)} 条名言:\n")

    # 5. 循环遍历并提取结构化字段
    for index, block in enumerate(quote_blocks, start=1):
        text_tag = block.find("span", class_="text")
        author_tag = block.find("small", class_="author")

        content = text_tag.text.strip() if text_tag else "无内容"
        author = author_tag.text.strip() if author_tag else "未知作者"

        print(f"[{index}] {content}")
        print(f"    作者:{author}\n")


if __name__ == "__main__":
    fetch_quotes()
3. 运行程序与输出验证
在终端中执行该脚本:
python3 spider.py正在向目标地址发起请求: https://quotes.toscrape.com/
成功获取页面,解析到 10 条名言:
[1] “The world as we have created it is a process of our thinking. It cannot be changed without changing our thinking.”
作者:Albert Einstein
[2] “It is our choices, Harry, that show what we truly are, far more than our abilities.”
作者:J.K. Rowling
[3] “There are only two ways to live your life. One is as though nothing is a miracle. The other is as though everything is a miracle.”
作者:Albert Einstein若终端中按序号输出了名言与作者,即表明爬虫程序已成功走通了“请求—解析—提取—输出”的完整链路。
五、新手常见问题与排障指南
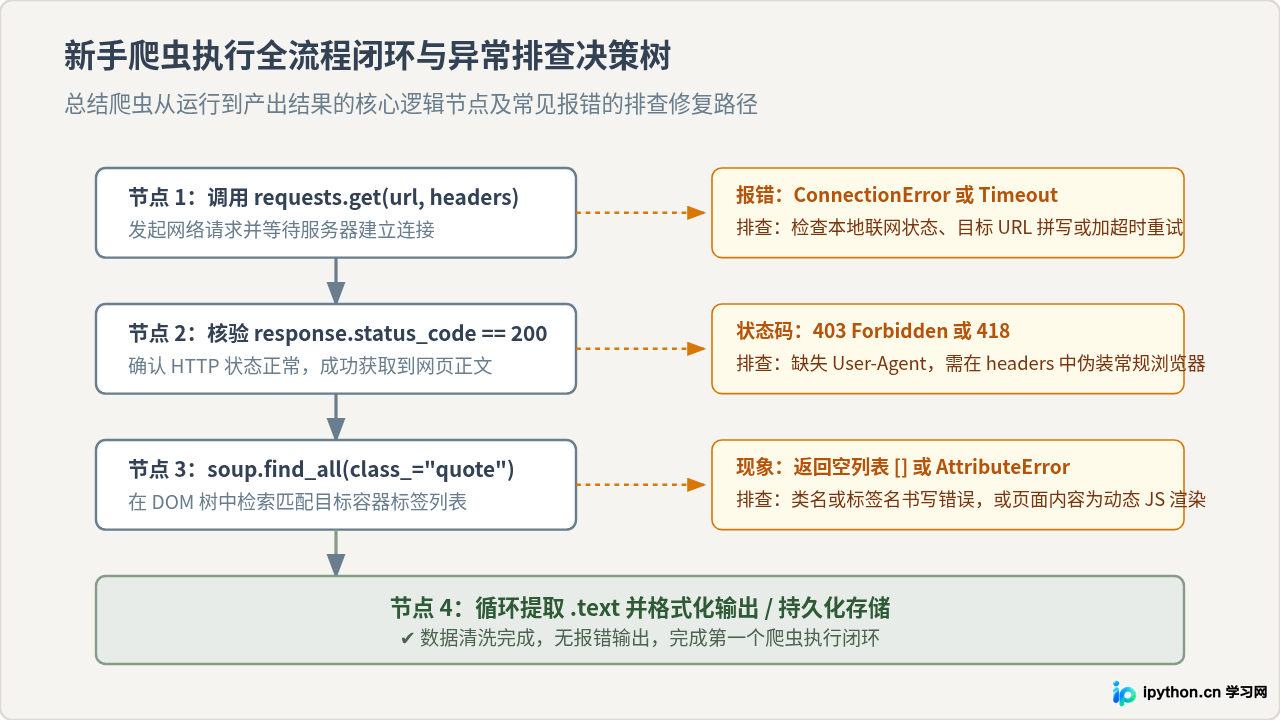
初学者在编写和运行第一个爬虫时,经常会遇到以下几类典型报错与异常状态:
- ModuleNotFoundError: No module named 'requests' 或 'bs4':通常是因为当前终端尚未激活之前配置的虚拟环境,导致 Python 解释器在全局环境中找不到对应包。排查方法:检查终端提示符是否带有
(venv),重新执行source venv/bin/activate激活环境后再运行脚本。 - HTTP 403 Forbidden 或 418 I'm a teapot:目标站点检测到了非浏览器的请求访问并予以阻断。排查方法:检查
headers字典中是否正确配置了标准的User-Agent字符串,必要时在浏览器开发者工具的网络(Network)标签页中复制当前真实请求的请求头字段。 - AttributeError: 'NoneType' object has no attribute 'text':说明
block.find(...)没有在当前 DOM 树中找到对应标签,返回了None,此时直接调用.text会触发空指针异常。排查方法:先核对页面源代码中的类名是否拼写正确(注意 BeautifulSoup 的关键字参数为class_="name",带有下划线避免与 Python 的class关键字冲突);对于可能为空的字段,加入空值条件判断进行防御性提取。 - 提取到的列表为空(len 为 0):如果 HTTP 状态码为 200 但没有抓取到任何数据,通常是因为目标网页的内容是通过 JavaScript 动态异步加载渲染的,单纯使用 requests 获取的静态 HTML 中并未包含所需数据。对于静态测试网站,需重新确认标签名是否选择正确。
六、编写爬虫的规范与边界
编写爬虫在获取公开数据的同时,需要遵守网络访问的基本礼仪与边界约束:
- 遵守 robots.txt 协议:在抓取网站数据前,应主动查看目标域名下的 robots.txt 文件,明确了解站方允许与禁止抓取的路径范围。
- 控制请求频率与并发:不要在循环中无间隔发起密集请求。在需要抓取多个页面时,应使用
time.sleep()加入适当的延时间隔,降低对目标服务器造成的负载压力。 - 仅抓取合法公开数据:不要尝试绕过登录鉴权或防爬策略抓取未公开数据,不得利用爬虫窃取个人隐私或商业机密数据。
通过掌握虚拟环境搭建、requests 请求伪装、BeautifulSoup DOM 标签定位以及防御性异常处理,新手便建立起了编写自动化网络爬虫的扎实基础,为后续处理更复杂的数据清洗与多页面分页抓取打下坚实根基。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















