


Python struct模块详解:格式字符串、字节序与打包解包实战

本文深入解析Python中struct模块的核心用法,涵盖format格式字符串的构建规则、字节序(大端/小端)控制、内存对齐与填充机制,以及pack、unpack等关键方法的实际代码示例,帮助开发者高效处理二进制数据交互。
简介
文件数据存储通常分为二进制和文本两种形式。若采用文本格式存储,读取时需解决文本到Python数据类型的转换问题。即便以文本形式存储,数据底层仍具有特定结构,这种结构概念源于Python底层由C语言编写的特性,因此常被称为C结构。
Lib/struct.py 模块专门负责执行此类结构数据的转换操作。
struct中的方法
首先查看struct模块的定义:
__all__ = [
    # Functions
    'calcsize', 'pack', 'pack_into', 'unpack', 'unpack_from',
    'iter_unpack',

    # Classes
    'Struct',

    # Exceptions
    'error'
    ]
该模块包含6个主要方法和1个异常类。
接下来重点介绍这6个方法的具体使用方式:
| 方法名 | 作用 |
|---|---|
| struct.pack(format, v1, v2, ...) | 返回一个 bytes 对象,其中包含根据格式字符串 format 打包的值 v1, v2, ... 参数个数必须与格式字符串所要求的值完全匹配。 |
| struct.pack_into(format, buffer, offset, v1, v2, ...) | 根据格式字符串 format 打包 v1, v2, ... 并将打包的字节串从 offset 开始的位置写入可写缓冲区 buffer 。 请注意 offset 是必需的参数。 |
| struct.unpack(format, buffer) | 根据格式字符串 format 从缓冲区 buffer 解包(假定是由 pack(format, ...) 打包)。 返回的结果为一个元组,即使其只包含一个条目。 缓冲区的字节大小必须匹配格式所要求的大小。 |
| struct.unpack_from(format, /, buffer, offset=0) | 从位置 offset 开始对 buffer 根据格式字符串 format 进行解包。 结果为一个元组,即使其中只包含一个条目。 |
| struct.iter_unpack(format, buffer) | 根据格式字符串 format 以迭代方式从缓冲区 buffer 解包。 此函数返回一个迭代器,它将从缓冲区读取相同大小的块直至其内容全部耗尽。 |
| struct.calcsize(format) | 返回与格式字符串 format 相对应的结构的大小(亦即 pack(format, ...) 所产生的字节串对象的大小)。 |
这些方法的核心功能在于数据的打包(pack)与解包(unpack)。其中,format参数(即格式字符串)至关重要,它决定了每个数据项被打包的具体格式。
格式字符串
格式字符串是打包和解包数据时指定数据类型的机制,由特定的格式字符构成。此外,还包含特殊字符用于控制字节顺序、数据大小以及对齐方式。
字节顺序,大小和对齐方式
默认情况下,C类型数据以机器本地的格式和字节顺序表示,并根据C编译器的规则通过填充字节进行正确对齐。
用户也可以手动指定格式字符串中的字节顺序、大小和对齐方式:
| 字符 | 字节顺序 | 大小 | 对齐方式 |
|---|---|---|---|
| @ | 按原字节 | 按原字节 | 按原字节 |
| = | 按原字节 | 标准 | 无 |
| < | 小端 | 标准 | 无 |
| > | 大端 | 标准 | 无 |
| ! | 网络(=大端) | 标准 | 无 |
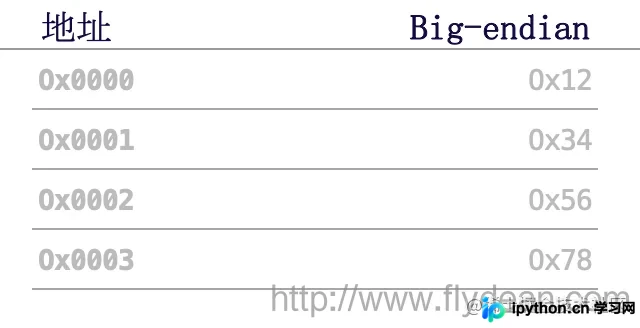
大端(Big Endian)和小端(Little Endian)是两种常见的数据存储模式。
第一种Big Endian模式将高位字节存储在起始地址。
第二种Little Endian模式将低位字节存储在起始地址。
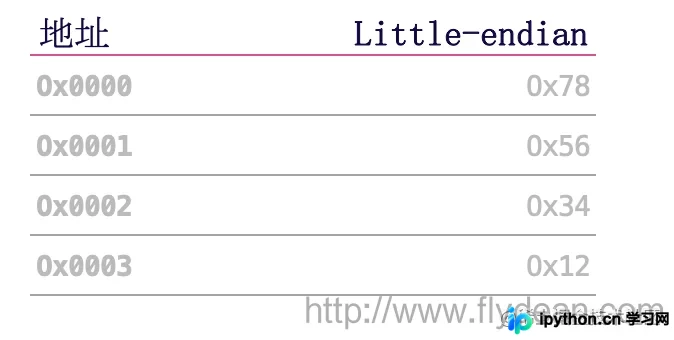
Big Endian更符合人类的阅读习惯,而Little Endian更契合机器的处理逻辑。
在主流CPU架构中,PowerPC系列采用Big Endian方式存储数据,而x86系列则采用Little Endian方式。
若不同CPU架构之间直接通信,可能因读取顺序差异导致数据解析错误。
填充字节仅在连续结构成员之间自动添加,不会出现在已编码结构的开头或末尾。
当使用非原字节大小和对齐方式(即 '<', '>', '=', and '!')时,系统不会添加任何填充字节。
格式字符
以下是可用的格式字符列表:
| 格式 | C 类型 | Python 类型 | 标准大小(字节) |
|---|---|---|---|
| x | 填充字节 | 无 | |
| c | char | 长度为 1 的字节串 | 1 |
| b | signed char | 整数 | 1 |
| B | unsigned char | 整数 | 1 |
| ? | _Bool | bool | 1 |
| h | short | 整数 | 2 |
| H | unsigned short | 整数 | 2 |
| i | int | 整数 | 4 |
| I | unsigned int | 整数 | 4 |
| l | long | 整数 | 4 |
| L | unsigned long | 整数 | 4 |
| q | long long | 整数 | 8 |
| Q | unsigned long long | 整数 | 8 |
| n | ssize_t | 整数 | |
| N | size_t | 整数 | |
| e | (6) | 浮点数 | 2 |
| f | float | 浮点数 | 4 |
| d | double | 浮点数 | 8 |
| s | char[] | 字节串 | |
| p | char[] | 字节串 | |
| P | void * | 整数 |
格式数字
例如,打包一个int对象可编写如下代码:
In [101]: from struct import *

In [102]: pack('i',10)
Out[102]: b'\n\x00\x00\x00'

In [103]: unpack('i',b'\n\x00\x00\x00')
Out[103]: (10,)

In [105]: calcsize('i')
Out[105]: 4
上述示例中,我们打包了int对象10并随后解包,同时计算得出格式 'i' 的长度为4字节。
输出结果为 b'\n\x00\x00\x00',此处不深入探讨其具体含义,但需注意开头的 'b' 表示字节(byte),后续为字节编码内容。
格式字符前可附加整数重复计数,例如格式字符串 '4h' 的含义与 'hhhh' 完全一致。
以下是打包4个short类型数据的示例:
In [106]: pack('4h',2,3,4,5)
Out[106]: b'\x02\x00\x03\x00\x04\x00\x05\x00'

In [107]: unpack('4h',b'\x02\x00\x03\x00\x04\x00\x05\x00')
Out[107]: (2, 3, 4, 5)
格式字符串中的空白字符通常会被忽略,但在调用 struct.calcsize 方法时,格式字符串中不可包含空白字符。
当使用整数格式('b', 'B', 'h', 'H', 'i', 'I', 'l', 'L', 'q', 'Q')打包值 x 时,若 x 超出该格式的有效范围,将引发 struct.error 异常。
格式字符
除数字外,字符和字符串也是常用的数据类型。
首先介绍格式字符的使用,由于字符长度为1个字节,操作方式如下:
In [109]: pack('4c',b'a',b'b',b'c',b'd')
Out[109]: b'abcd'

In [110]: unpack('4c',b'abcd')
Out[110]: (b'a', b'b', b'c', b'd')

In [111]: calcsize('4c')
Out[111]: 4
字符前的 'b' 表示这是一个字节字符,否则将被视为字符串处理。
格式字符串
接下来查看字符串的格式处理:
In [114]: pack('4s',b'abcd')
Out[114]: b'abcd'

In [115]: unpack('4s',b'abcd')
Out[115]: (b'abcd',)

In [116]: calcsize('4s')
Out[116]: 4

In [117]: calcsize('s')
Out[117]: 1
可以看出,对于字符串而言,calcsize 返回的是字节长度。
填充的影响
格式字符的顺序会影响最终大小,因为满足对齐要求所需的填充量可能不同:
>>> pack('ci', b'*', 0x12131415)
b'*\x00\x00\x00\x12\x13\x14\x15'
>>> pack('ic', 0x12131415, b'*')
b'\x12\x13\x14\x15*'
>>> calcsize('ci')
8
>>> calcsize('ic')
5
以下示例展示如何手动控制填充效果:
In [120]: pack('llh',1, 2, 3)
Out[120]: b'\x01\x00\x00\x00\x00\x00\x00\x00\x02\x00\x00\x00\x00\x00\x00\x00\x03\x00'
上述例子中,我们打包了1、2、3这三个数字,但使用的格式不同,分别为long、long和short。
由于long占4个字节,short占2个字节,导致数据本质上未对齐。
若需对齐,可在末尾追加 '0l' 表示0个long,从而实现手动填充:
In [118]: pack('llh0l', 1, 2, 3)
Out[118]: b'\x01\x00\x00\x00\x00\x00\x00\x00\x02\x00\x00\x00\x00\x00\x00\x00\x03\x00\x00\x00\x00\x00\x00\x00'

In [122]: unpack('llh0l',b'\x01\x00\x00\x00\x00\x00\x00\x00\x02\x00\x00\x00\x00\x00\x00\x00\x03\x00\x00\x00\x00\x00\x00\x00')
Out[122]: (1, 2, 3)
复杂应用
最后展示一个较为复杂的应用场景,直接从 unpack 返回的数据中读取到元组:
>>> record = b'raymond   \x32\x12\x08\x01\x08'
>>> name, serialnum, school, gradelevel = unpack('<10sHHb', record)

>>> from collections import namedtuple
>>> Student = namedtuple('Student', 'name serialnum school gradelevel')
>>> Student._make(unpack('<10sHHb', record))
Student(name=b'raymond   ', serialnum=4658, school=264, gradelevel=8)
总结
至此,关于Python基础笔记之struct和格式化字符的介绍结束,更多相关Python struct和格式化字符内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















