


Python实现基于文件内容查找文件:glob模块递归搜索实战

本文详解如何利用Python的glob模块实现基于文件内容的文件查找功能。通过递归遍历目录,结合文件读取与关键字匹配,程序可自动定位包含特定内容的文件路径。文章提供了从基础glob用法到完整递归搜索代码的示例,适用于需要批量处理或定位特定文本内容的场景。
本章介绍如何利用Python实现基于文件内容的查找功能。尽管Linux和Windows系统原生支持按文件名进行过滤和查找,但直接通过文件内容进行搜索的功能并不直观或默认存在。借助Python脚本,我们可以轻松实现这一需求。通过本章学习,您将掌握使用Python完成文件内容查找的具体方法。
文件查找操作
glob 的介绍
glob 模块是一个用于快速查找文件夹内容的工具,支持通过模糊匹配模式来定位目标文件。
glob 的基本使用
导入包与模块
from glob import glob使用方法
glob(任意目录)
返回内容:
该函数返回指定路径下的内容列表;若路径不存在,则返回空列表。
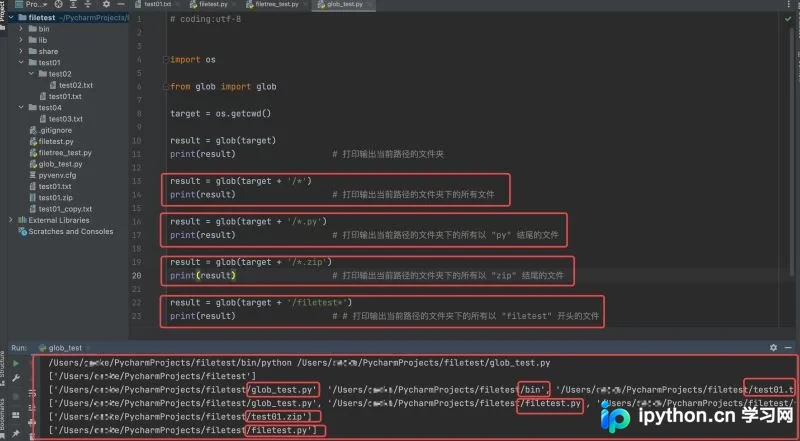
代码示例如下:
# coding:utf-8

import os
from glob import glob

target = os.getcwd()

result = glob(target)
print(result)                   # 打印输出当前路径的文件夹

result = glob(target + '/*')
print(result)                   # 打印输出当前路径的文件夹下的所有文件

result = glob(target + '/*.py')
print(result)                   # 打印输出当前路径的文件夹下的所有以 "py" 结尾的文件

result = glob(target + '/*.zip')
print(result)                   # 打印输出当前路径的文件夹下的所有以 "zip" 结尾的文件

result = glob(target + '/filetest*')
print(result)                   # # 打印输出当前路径的文件夹下的所有以 "filetest" 开头的文件
运行结果如下:
查找指定的文件
已知条件:
文件名已知,但文件所在目录未知。
实现方法:
利用 glob 模块从根目录开始递归查找,持续搜索直至找到目标文件。
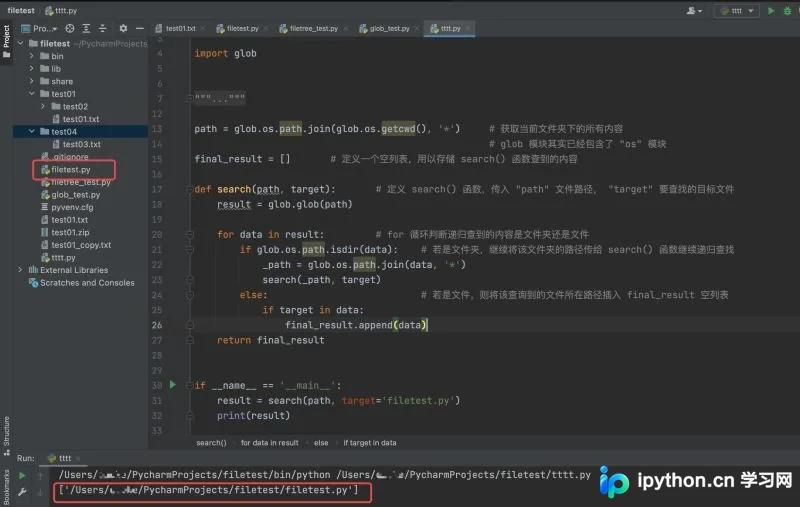
代码示例如下:
# coding:utf-8

import glob

"""
获取当前路径下所有内容
判断每个内容的类型(文件夹还是文件)
若是文件夹则继续递归查找
"""

path = glob.os.path.join(glob.os.getcwd(), '*')     # 获取当前文件夹下的所有内容
                                                    # glob 模块其实已经包含了 "os" 模块
final_result = []       # 定义一个空列表,用以存储 search() 函数查到的内容

def search(path, target):       # 定义 search() 函数,传入 "path" 文件路径, "target" 要查找的目标文件
    result = glob.glob(path)

    for data in result:         # for 循环判断递归查到的内容是文件夹还是文件
        if glob.os.path.isdir(data):    # 若是文件夹,继续将该文件夹的路径传给 search() 函数继续递归查找
            _path = glob.os.path.join(data, '*')
            search(_path, target)
        else:                           # 若是文件,则将该查询到的文件所在路径插入 final_result 空列表
            if target in data:
                final_result.append(data)
    return final_result


if __name__ == '__main__':
    result = search(path, target='filetest.py')
    print(result)
运行结果如下:
基于文件内容查找文件
接下来演示如何查找包含特定内容的文件:
已知条件:
文件内容中包含特定关键字,但文件名及所在路径均未知。
实现方法:
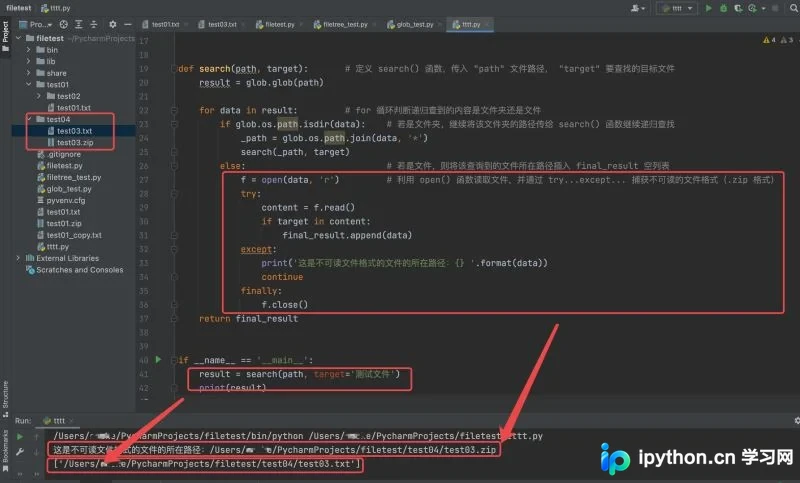
利用 glob 模块从顶层目录开始递归遍历。若遇到文件夹则进入继续查找;若遇到文件则读取其内容,判断是否包含指定关键字,若包含则记录该文件名及所在路径。
实际上,基于文件内容查找文件的方法与前述查找指定文件名的方法大体相似,主要区别在于增加了读取文件并判断内容是否匹配的环节。
代码示例如下:
# coding:utf-8

import glob

"""
获取当前路径下所有内容
判断每个内容的类型(文件夹还是文件)
若是文件夹则继续递归查找
"""

path = glob.os.path.join(glob.os.getcwd(), '*test04')     # 因为下文捕获不可读文件格式太多,所以这里直接指定了 "test04" 路径
final_result = []       # 定义一个空列表,用以存储 search() 函数查到的内容


def search(path, target):       # 定义 search() 函数,传入 "path" 文件路径, "target" 要查找的目标文件
    result = glob.glob(path)

    for data in result:         # for 循环判断递归查到的内容是文件夹还是文件
        if glob.os.path.isdir(data):    # 若是文件夹,继续将该文件夹的路径传给 search() 函数继续递归查找
            _path = glob.os.path.join(data, '*')
            search(_path, target)
        else:                           # 若是文件,则将该查询到的文件所在路径插入 final_result 空列表
            f = open(data, 'r')         # 利用 open() 函数读取文件,并通过 try...except... 捕获不可读的文件格式(.zip 格式)
            try:
                content = f.read()
                if target in content:
                    final_result.append(data)
            except:
                print('这是不可读文件格式的文件的所在路径:{} '.format(data))
                continue
            finally:
                f.close()
    return final_result


if __name__ == '__main__':
    result = search(path, target='测试文件')
    print(result)
运行结果如下:
至此,关于Python基于文件内容实现查找文件功能的文章介绍完毕。如需了解更多Python文件查找相关内容,请搜索本站历史文章或继续浏览后续文章,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















