


Python新手常见陷阱:自增运算符、对象比较与字符串处理

本文总结了Python新手常犯的四个典型错误:误用++i导致无限循环、混淆is与==的比较逻辑、忽视字符串拼接的性能损耗,以及误解for-else与try-else的执行机制。通过具体代码示例解析底层原理,帮助开发者写出更规范高效的Python代码。
误用自增运算符导致无限循环
许多从C或Java转来的开发者习惯使用 ++i 或 --i 进行变量自增或自减。在Python中,这并非自增操作,而是被解释为 +(+i) 或 -(-i),即对变量执行两次一元正号或负号运算。由于Python没有自增运算符,这种写法不会改变变量值,极易在 while 循环中导致死循环。
i=0
mylist=[1,2,3,4,5,6]
while i <len(mylist):
 print(mylist[i])
++i上述代码中,i 始终为 0,程序会不断打印列表第一个元素。验证方法如下:
print(+1)
>>>1
print(++1)
>>>1
print(+++1)
>>>1
正确做法是使用 i += 1 或 i = i + 1。
混淆 is 与 == 的比较逻辑
== 用于比较两个对象的内容是否相等,而 is 用于比较两个对象的内存地址是否相同(可通过 id() 函数查看)。Python字符串是不可变对象,解释器会对短字符串进行驻留(interning),导致不同变量指向同一内存地址,从而产生 is 为 True 的假象。
a='Hi'
b='Hi'
print(a is b)
>>>True
print(a==b)
>>>True #看起来is和==好像是一样的
但当字符串较长或包含特殊字符时,驻留机制可能失效,此时 is 返回 False,而 == 仍返回 True:
str1='Wo shi yi ge chi huo'
str2='Wo shi yi ge chi huo'
print(str1 is str2)
>>>False#is的结果是False
print(str1==str2)
>>>True #==的结果为True,看二者不一样了吧
此外,通过 join 生成的字符串即使内容相同,内存地址也不同:
str3='string'
str4=''.join(['s','t','r','i','n','g'])
print(str3)
>>>string
print(str3 is str4)
>>>False #is的结果是False
print(str3==str4)
>>>True #==的结果为True,看二者不一样了吧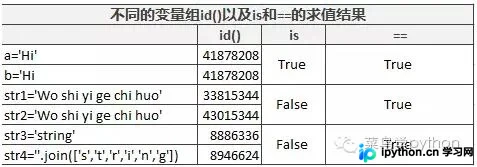
忽视字符串拼接的性能损耗
使用 + 连接多个字符串时,Python会创建N-1个中间结果,每次申请内存都会严重影响效率。对于大规模字符串连接,应使用 join 方法,它一次性申请总内存并复制元素。
str1,str2,str3='test','string','connection'
print(str1+str2+str3)
>>>test string connection
str1,str2,str3='test ','string ','connection'
print(''.join([str1,str2,str3]))
>>>test string connection在生成大量字符串列表时,join 的效率远高于 +:
long_str_list=['This is a long string' for n in range(1,100000)]误解 for-else 与 try-else 的执行机制
for...else 中的 else 块仅在循环正常结束(未执行 break)时运行。若循环中使用 break,将跳过 else 块。同理,try...except...else 中的 else 在 try 未发生异常时执行,而 finally 无论是否发生异常都会执行。
for i in range(3):
 print('Loop %d'%i)
else:
 print('Else block')
>>>Loop 0
>>>Loop 1
>>>Loop 2
>>>Else block
以上就是Python新手常见陷阱:自增运算符、对象比较与字符串处理的详细内容,更多关于Python基础语法与性能优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















