


Pandas数据连接pd.concat的实现

本文详细介绍Pandas中pd.concat函数的用法,涵盖纵向与横向数据连接、关键参数如axis和join的配置,以及处理Series与DataFrame混合连接的示例。通过具体代码演示如何高效合并数据集,适用于数据清洗与分析场景。
Pandas支持对数据进行纵向和横向连接操作,连接后会生成一个新的Series或DataFrame对象。
数据连接是处理多个数据集合并时最常用的操作之一。
pd.concat()函数专门用于执行数据连接与合并,它支持沿行或列方向操作,并可指定非合并轴的合并策略(例如取合集或交集)。
该函数执行后将返回一个合并后的DataFrame对象。
语法格式如下。
pd.concat(objs, axis=0, join='outer', ignore_index=False,
          keys=None, levels=None, names=None, sort=False,
          verify_integrity=False, copy=True)
主要参数说明如下。
- objs:指定需要连接的数据源,可以是多个DataFrame或Series实例,此为必传参数。
- axis:定义连接的轴向,默认值为0,表示按行连接,将数据追加在现有行之后;当设置为1时,表示按列连接,将数据追加在列之后(即axis=1)。
- join:定义其他轴上数据的合并方式,可选择按交集(inner)或并集(outer)进行合并。
- ignore_index:布尔值,指示是否忽略原有索引而使用新的整数索引。
- keys:用于构建层次化索引,通过传入的键作为最外层级别来标识每个数据表,即为每个表指定一级索引。
- names:用于指定索引的名称,包括多层索引的情况。
- verify_integrity:布尔值,若设为True,则在合并过程中检测索引重复;如果合并后的数据与原数据包含相同索引的行,系统将抛出错误。
- copy:布尔值,若设为False,则不进行深拷贝操作。
1.按行连接方法
pd.concat()的基本操作可以实现与df.append()相同的功能。
在此操作中,ignore_index和sort参数的作用相似;axis默认取值为0,即默认按行连接。
import pandas as pd
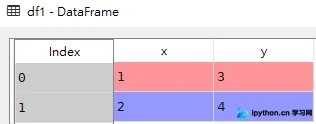
df1 = pd.DataFrame({'x':[1,2],'y':[3,4]})
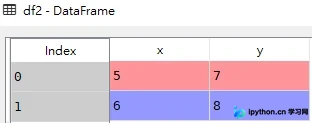
df2 = pd.DataFrame({'x':[5,6],'y':[7,8]})
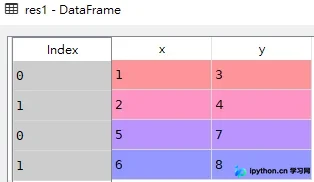
res1 = pd.concat([df1,df2])
# 效果同上
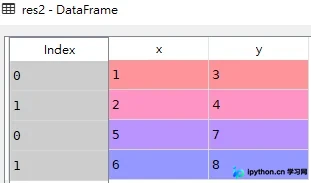
res2 = df1.append(df2)
定义数据框df1。
定义数据框df2。
执行按行连接的结果res1。
执行等效操作的结果res2。
2.按列连接方法
若需将多个DataFrame按列拼接,可传入axis=1参数。这会将不同数据追加到列后方,对于索引无法对应的位置,系统将值填充为NaN。
import pandas as pd
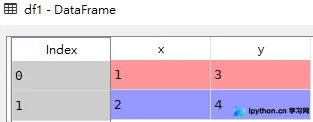
df1 = pd.DataFrame({'x':[1,2],'y':[3,4]})
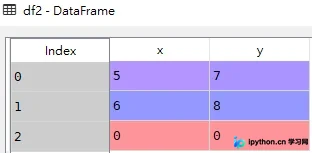
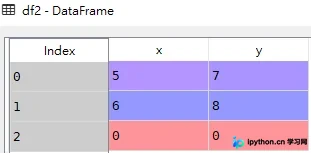
df2 = pd.DataFrame({'x':[5,6,0],'y':[7,8,0]})
res = pd.concat([df1,df2], axis=1)
定义数据框df1。
定义数据框df2。
执行按列连接的结果res。
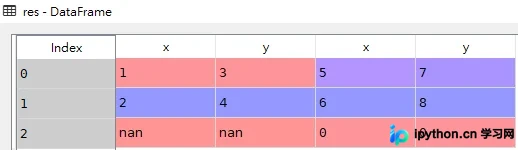
本例中,df2比df1多出一行,合并后df1部分缺失的数据将显示为NaN。
3.合并交集处理
前述两个示例中的连接操作默认返回两个表内容的并集(即join='outer')。
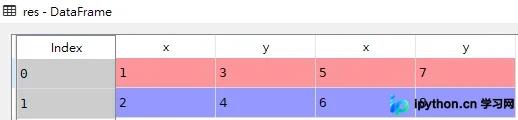
若需合并交集,需调整join参数,设置为join='inner'。
import pandas as pd
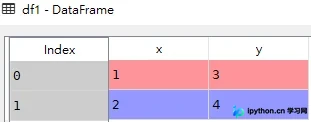
df1 = pd.DataFrame({'x':[1,2],'y':[3,4]})
df2 = pd.DataFrame({'x':[5,6,0],'y':[7,8,0]})
# 按列合并交集
# 传入join='inner'取得两个DataFrame的共有部分,去除了df1没有的第三行内容
res = pd.concat([df1,df2], axis=1, join='inner')
定义数据框df1。
定义数据框df2。
执行按列合并交集的结果res。
扩展技巧
利用reindex()方法也可实现取交集的功能。
# 两种方法
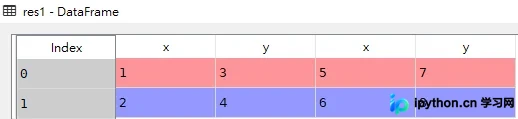
res1 = pd.concat([df1,df2],axis=1).reindex(df1.index)
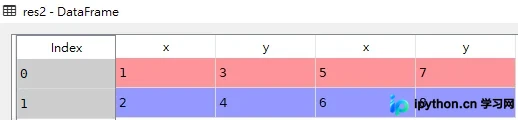
res2 = pd.concat([df1,df2.reindex(df1.index)],axis=1)
结果res1。
结果res2。
4.与序列合并
import pandas as pd
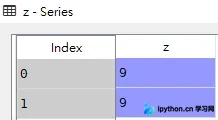
z = pd.Series([9,9],name='z')
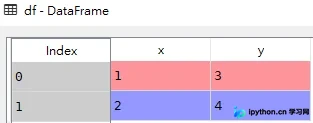
df = pd.DataFrame({'x':[1,2],'y':[3,4]})
# 将序列加到新列
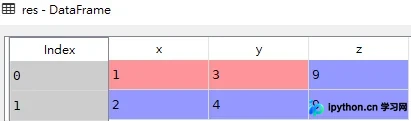
res = pd.concat([df,z],axis=1)
定义序列z。
定义数据框df。
执行合并的结果res。
5.指定索引方法
import pandas as pd
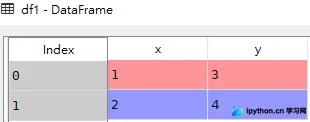
df1 = pd.DataFrame({'x':[1,2],'y':[3,4]})
df2 = pd.DataFrame({'x':[5,6],'y':[7,8]})
# 指定索引名
res1 = pd.concat([df1,df2], keys=['a','b'])
# 以字典形式传入
dict = {'a':df1, 'b':df2}
res2 = pd.concat(dict)
# 横向合并,指定索引
res3 = pd.concat([df1,df2], axis=1, keys=['a','b'])
定义数据框df1。
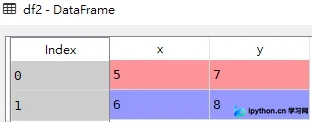
定义数据框df2。
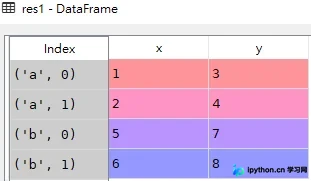
指定索引名后的结果res1。
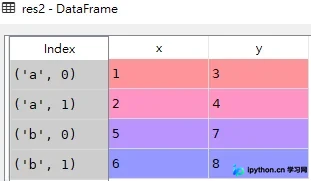
字典形式传入的结果res2。
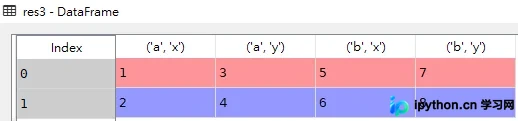
横向合并且指定索引的结果res3。
至此,关于Pandas数据连接pd.concat的实现介绍完毕。如需了解更多相关Pandas数据连接pdconcat内容,请搜索本站历史文章或继续浏览后续文章。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















