


Python遍历读取文件或文件夹的两种方法及实现

本文详解Python中遍历读取目录的两种常用方法:os.listdir与os.walk。os.listdir仅获取当前层级文件列表,而os.walk可递归遍历所有子目录。文章通过具体代码示例对比两者返回值差异,并提供了支持多后缀过滤、递归/非递归选项的完整封装函数,帮助开发者高效处理机器学习或深度学习中的文件读取需求。
在进行机器学习或深度学习算法开发时,经常需要遍历特定目录以读取文件,尤其是针对具有特定后缀的文件,例如图像文件可能需要读取jpg、png或bmp格式。由于Python标准库函数缺乏这种高度定制化的功能,因此需要对现有功能进行封装和扩展。
示例说明
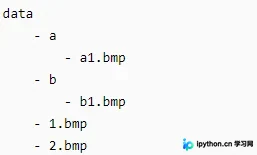
假设存在如下目录结构,其中以.bmp结尾的为文件,其余为文件夹。后续所有程序示例均基于该目录结构进行演示。
os.listdir方法
os.listdir函数仅读取当前指定路径下的文件和文件夹,并返回一个列表。以下是读取demo目录结构的代码及运行结果:
path = r'D:\data'
items = os.listdir(path)  # ==> ['1.bmp', '2.bmp', 'a', 'b']
os.walk方法
os.walk函数本身已具备遍历读取功能,能够包含所有子文件(夹),但其返回结果并非像os.listdir那样直接返回list,而是一个较为复杂的数据结构,难以直接使用,因此通常需要进行额外处理。我们可以通过for语句将其打印出来观察:
path = r'D:\data'
# part 1
for items in os.walk(path):
    print(items)
# part 2
for main_dir, sub_dir_list, sub_file_list in os.walk(path):
    print(main_dir, sub_dir_list, sub_file_list)
运行结果如下:
# part 1 ('D:\\data', ['a', 'b'], ['1.bmp', '2.bmp']) ('D:\\data\\a', [], ['a1.bmp']) ('D:\\data\\b', [], ['b1.bmp']) # part 2 D:\data ['a', 'b'] ['1.bmp', '2.bmp'] D:\data\a [] ['a1.bmp'] D:\data\b [] ['b1.bmp']
通过迭代器输出os.walk()的结果,可以发现每一条记录包含三个部分(part 1)。在part 2中,我们将这三个部分分别命名为main_dir、sub_dir_list和sub_file_list,下面对其进行简要解释:
- main_dir:遍历过程中得到的当前路径下所有文件夹的根目录
- sub_dir_list:main_dir直接包含的子文件夹列表
- sub_file_list:main_dir直接包含的文件列表
将main_dir与sub_file_list中的文件名拼接,即可得到该路径下的所有完整文件路径。
在此场景下,sub_dir_list并无额外用途,因为子文件夹的内容已经包含在main_dir的遍历结果中,无需再单独遍历sub_dir_list。
遍历读取代码实现
代码逻辑设计如下:
需具备后缀识别功能,且支持同时识别多种后缀
需支持递归和非递归两种遍历模式
返回的路径以入参path为前缀,因此如果path是完整路径,则返回完整路径;否则返回相对路径
# -*- coding: utf-8 -*-
import os


def file_ext(filename, level=1):
    """
    return extension of filename

    Parameters:
    -----------
    filename: str
        name of file, path can be included
    level: int
        level of extension.
        for example, if filename is 'sky.png.bak', the 1st level extension
        is 'bak', and the 2nd level extension is 'png'

    Returns:
    --------
    extension of filename
    """
    return filename.split('.')[-level]


def _contain_file(path, extensions):
    """
    check whether path contains any file whose extension is in extensions list

    Parameters:
    -----------
    path: str
        path to be checked
    extensions: str or list/tuple of str
        extension or extensions list

    Returns:
    --------
    return True if contains, else return False
    """
    assert os.path.exists(path), 'path must exist'
    assert os.path.isdir(path), 'path must be dir'

    if isinstance(extensions, str):
        extensions = [extensions]

    for file in os.listdir(path):
        if os.path.isfile(os.path.join(path, file)):
            if (extensions is None) or (file_ext(file) in extensions):
                return True
    return False


def _process_extensions(extensions=None):
    """
    preprocess and check extensions, if extensions is str, convert it to list.

    Parameters:
    -----------
    extensions: str or list/tuple of str
        file extensions

    Returns:
    --------
    extensions: list/tuple of str
        file extensions
    """
    if extensions is not None:
        if isinstance(extensions, str):
            extensions = [extensions]
        assert isinstance(extensions, (list, tuple)), \
            'extensions must be str or list/tuple of str'
        for ext in extensions:
            assert isinstance(ext, str), 'extension must be str'
    return extensions


def get_files(path, extensions=None, is_recursive=True):
    """
    read files in path. if extensions is None, read all files, if extensions
    are specified, only read the files who have one of the extensions. if
    is_recursive is True, recursively read all files, if is_recursive is False,
    only read files in current path.

    Parameters:
    -----------
    path: str
        path to be read
    extensions: str or list/tuple of str
        file extensions
    is_recursive: bool
        whether read files recursively. read recursively is True, while just
        read files in current path if False

    Returns:
    --------
    files: the obtained files in path
    """
    extensions = _process_extensions(extensions)
    files = []
    # get files in current path
    if not is_recursive:
        for name in os.listdir(path):
            fullname = os.path.join(path, name)
            if os.path.isfile(fullname):
                if (extensions is None) or (file_ext(fullname) in extensions):
                    files.append(fullname)
        return files
    # get files recursively
    for main_dir, _, sub_file_list in os.walk(path):
        for filename in sub_file_list:
            fullname = os.path.join(main_dir, filename)
            if (extensions is None) or (file_ext(fullname) in extensions):
                files.append(fullname)
    return files


def get_folders(path, extensions=None, is_recursive=True):
    """
    read folders in path. if extensions is None, read all folders, if
    extensions are specified, only read the folders who contain any files that
    have one of the extensions. if is_recursive is True, recursively read all
    folders, if is_recursive is False, only read folders in current path.

    Parameters:
    -----------
    path: str
        path to be read
    extensions: str or list/tuple of str
        file extensions
    is_recursive: bool
        whether read folders recursively. read recursively is True, while just
        read folders in current path if False

    Returns:
    --------
    folders: the obtained folders in path
    """
    extensions = _process_extensions(extensions)
    folders = []
    # get folders in current path
    if not is_recursive:
        for name in os.listdir(path):
            fullname = os.path.join(path, name)
            if os.path.isdir(fullname):
                if (extensions is None) or \
                        (_contain_file(fullname, extensions)):
                    folders.append(fullname)
        return folders
    # get folders recursively
    for main_dir, _, _ in os.walk(path):
        if (extensions is None) or (_contain_file(main_dir, extensions)):
            folders.append(main_dir)
    return folders


if __name__ == '__main__':
    path = r'.\data'

    files = get_files(path)
    print(files)  # ==> ['D:\\data\\1.bmp', 'D:\\data\\2.bmp', 'D:\\data\\a\\a1.bmp', 'D:\\data\\b\\b1.bmp']

    folders = get_folders(path)
    print(folders)  # ==> ['D:\\data', 'D:\\data\\a', 'D:\\data\\b']
以上为Python实现遍历读取文件或文件夹的详细内容,更多关于Python遍历读取文件的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















