


想转行数据分析或Web开发,Python入门侧重点有何不同

同样是零基础学习 Python,想转行做数据分析的人如果花大量精力去死磕面向对象设计模式、网络协议和多线程,往往会卡在无反馈的抽象语法里;而想做 Web 开发的人如果成天琢磨矩阵切片、缺失值填充和箱线图绘制,写后端接口时依然连个 HTTP 请求参数都解析不明白。Python 本身是一门语法极其宽泛的胶水语言,目标岗位不同,语法基石的使用深度、底层数据结构的侧重,以及第一行业务代码该怎么写,有着本质的区别。
方向差异全景:同一个语法底座,两套完全不同的应用心智
无论选哪条路,变量、常见基础类型(数字、字符串)、简单条件分支和函数定义都是绕不开的共有底座。但在打完这层薄弱的地基之后,两个方向的代码关注点就会迅速分流:数据分析关注的是静态、离散批量数据的清洗、计算与业务推断;Web 开发关心的则是在线服务的高并发、持续请求生命周期、安全鉴权与状态持久化。
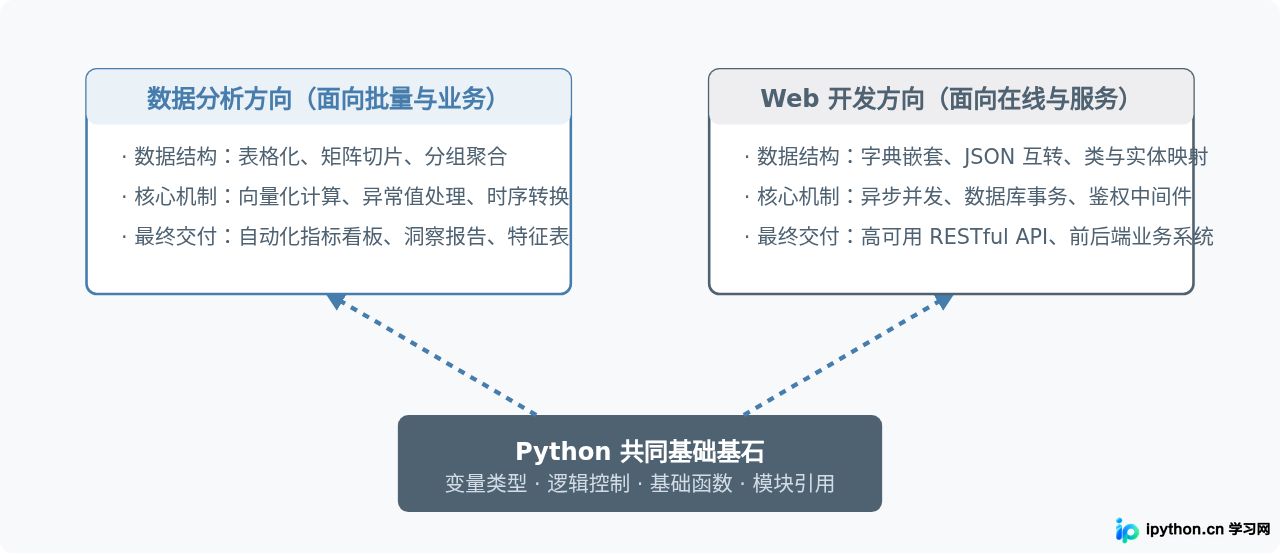
基础语法阶段的“学与不学”
很多零基础自学者会买一本厚达六七百页的“Python 从入门到精通”,从第一页顺序读到最后一页。这种学习方法最容易让人半途而废。必须根据目标岗位,决定哪些语法要深挖,哪些可以先跳过。
1. 函数与面向对象(OOP)
数据分析方向:优先熟练使用平铺直叙的脚本式编程与函数式思维。写分析脚本时,你更常使用的是接收一个数据集、返回处理后新结果的无副作用函数,或者直接利用 apply 与 lambda 表达式。面向对象中的“类继承”、“多重继承”、“元类(Metaclass)”在日常分析工作中几乎极少手写,只需知道如何实例化三方库提供的对象即可,完全不需要花几周去反复设计类结构。
Web 开发方向:面向对象是核心骨架。现代主流 Web 框架(无论是 Django 还是基于 SQLAlchemy 的 FastAPI 系统)中,数据库模型(ORM)、序列化器、全局异常拦截器全部基于类来实现。你需要透彻理解类的实例化、实例变量与类变量区别、魔术方法(如 __init__、__repr__、__call__)以及装饰器原理。装饰器在 Web 开发中遍地开花,路由声明如 @app.get("/items")、权限验证如 @login_required,不理解装饰器闭包逻辑就很难看懂源码。
2. 内置容器与数据结构的处理偏好
数据分析方向:Python 自带的列表(list)与字典(dict)在数据分析中仅用作原始数据加载的过渡中转站。一旦数据量达到几万甚至几百万行,纯 Python 原生列表循环嵌套会慢得无法忍受。数据分析的精力必须快速转移到 numpy.ndarray 与 pandas.DataFrame 的内存排布和向量化批量处理上。
Web 开发方向:原生字典和嵌套结构才是真正的基石。前后端通过网络协议交互传递的都是标准的 JSON 字符串。在后端代码中,处理一个前端提交的复杂表单本质上就是在解构一个深层嵌套字典。你需要熟练掌握字典推导式、键值解构以及强类型验证库(如 Pydantic)如何将嵌套字典转化为强校验的数据模型。
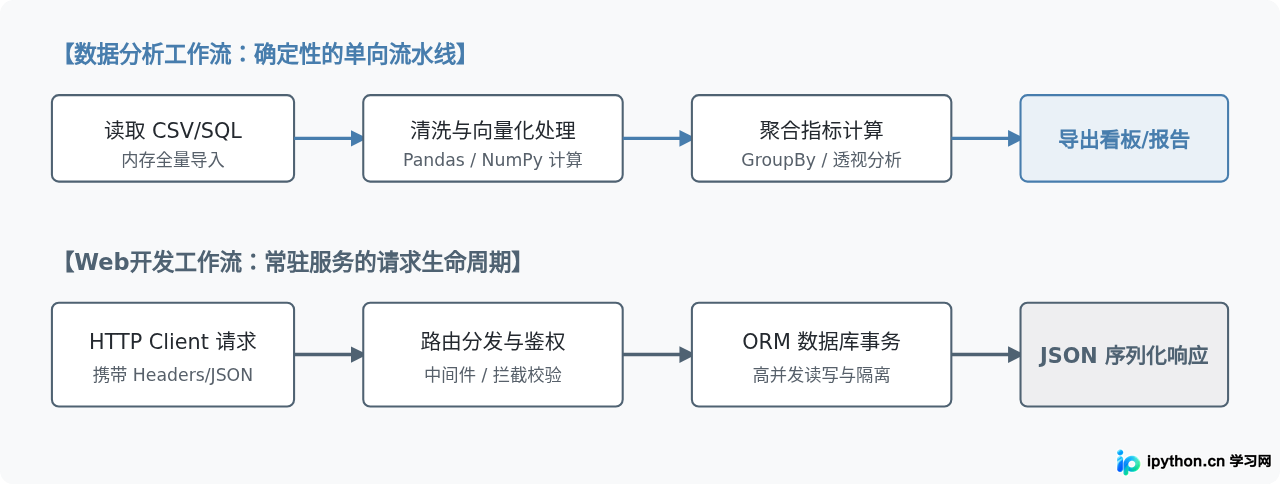
数据流转机制对比:批处理脚本 vs 实时请求生命周期
理解这两种工程师在工作流中如何看待“数据流动”,能帮你直接避开学习误区。
在数据分析中,代码是单次线性执行的:从外部文件读取整个表,过滤脏数据,做分组聚合,然后将统计结果落盘或生成可视化图表。执行完毕后,脚本结束退出。
而在 Web 开发中,代码是常驻后台的被动响应引擎:服务启动后会一直占用端口监听网络连接。一次用户访问触发一次完整的 HTTP 生命周期。多个用户同时请求时,程序必须依赖多进程、多线程或基于事件循环的异步 I/O 机制同时处理,且必须确保不同用户之间的数据状态隔离安全。
真实业务场景代码对比:处理一组用户订单
假设业务有一批用户订单数据,需要统计每个用户的有效消费总金额。我们来看两个方向在实际写代码时的完全不同思考方式。
场景 A:数据分析师在 Jupyter 中的写法
分析师的核心任务是快速出结论,绝对避免手动 for 循环,而是直接依靠成熟的向量化算子。
import pandas as pd

# 1. 模拟加载数据集(实际场景通常为读取 50 万行的日志 CSV 或从数仓导出的表)
df = pd.DataFrame([
    {"order_id": 101, "user_id": "U1", "amount": 250.0, "status": "paid"},
    {"order_id": 102, "user_id": "U2", "amount": 99.0,  "status": "pending"},
    {"order_id": 103, "user_id": "U1", "amount": 150.0, "status": "paid"},
    {"order_id": 104, "user_id": "U3", "amount": 420.0, "status": "refunded"},
])

# 2. 向量化布尔过滤与单次聚合统计
valid_orders = df[df["status"] == "paid"]
user_spending = (
    valid_orders.groupby("user_id")["amount"]
    .sum()
    .reset_index(name="total_spent")
)

# 示例输出查看
print(user_spending)
# 终端输出:
#   user_id  total_spent
# 0 U1 400.0重点说明:这段代码的核心在于整表过滤与基于列的向量分组,分析师不需要为每一个订单创建自定义类,只关心数据分布、计算是否精准、缺失数据是否有填充。
场景 B:Web 后端开发在接口框架中的写法
后端工程师需要应对网络访问、处理身份鉴权、校验入参格式并确保数据库操作具有原子性。
from fastapi import FastAPI, HTTPException, Depends
from pydantic import BaseModel
from typing import List

app = FastAPI()

# 1. 强类型模型:数据进出都必须通过校验
class OrderItem(BaseModel):
    order_id: int
    amount: float
    status: str

class UserTotalResponse(BaseModel):
    user_id: str
    total_spent: float

# 2. 路由监听与异常处理(模拟接收请求并返回标准的 JSON 结构)
@app.get("/api/v1/users/{user_id}/spent", response_model=UserTotalResponse)
async def get_user_spent(user_id: str):
    # 模拟从关系型数据库按条件只查询当前用户数据
    # 真实生产环境中这里会写带有连接池的 SQL 或 ORM 查询
    db_records = [
        {"order_id": 101, "user_id": "U1", "amount": 250.0, "status": "paid"},
        {"order_id": 103, "user_id": "U1", "amount": 150.0, "status": "paid"},
    ]

    if not db_records:
        raise HTTPException(status_code=404, detail="未查询到该用户的有效支付记录")

    total = sum(item["amount"] for item in db_records if item["status"] == "paid")
return {"user_id": user_id, "total_spent": total}重点说明:后端关心的绝不是把所有用户几十万条数据一次性读进 Python 内存,而是只筛选当前发出请求的用户记录。核心精力在入参校验(Pydantic)、状态码规范(HTTP 404/500)、路由装饰器与高并发异步处理(async def)。
转行落地路线:分步执行与能力验证
明确了侧重点之后,两个方向的落地练习步骤完全不同。以下是两条已经被验证可操作的入门闭环路径。
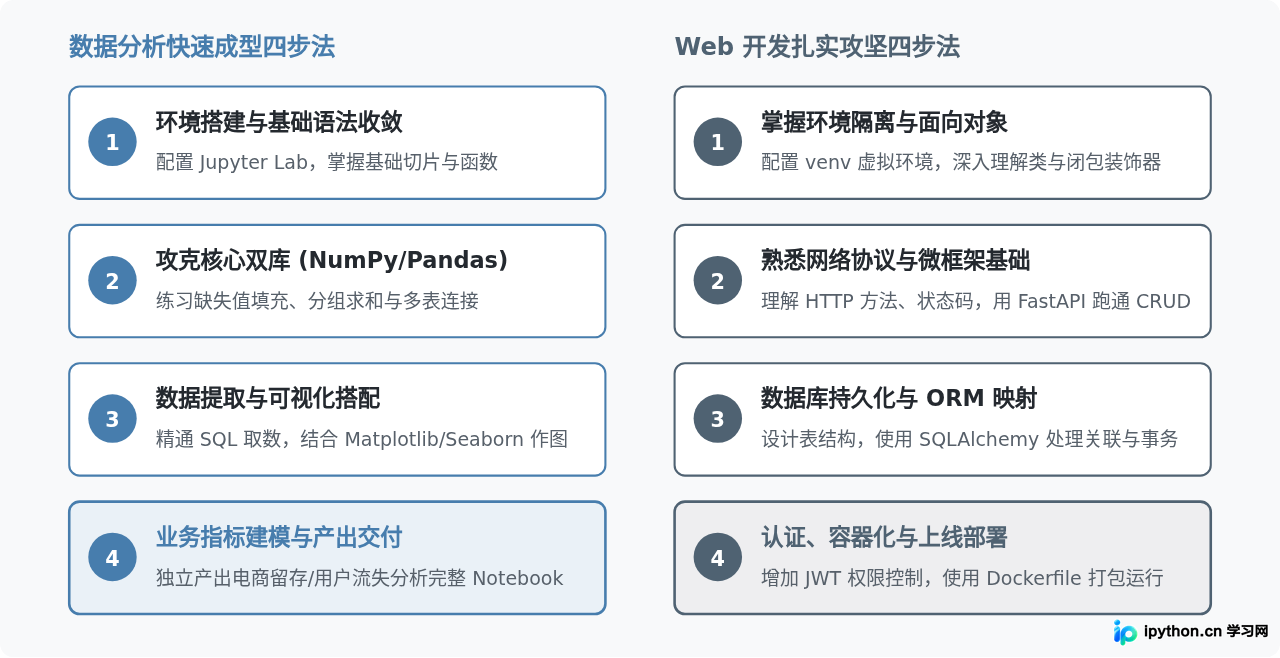
核心技能与工具栈速查
| 对比维度 | 数据分析 (Data Analyst) | Web 开发 (Web Developer) |
|---|---|---|
| 代码运行环境 | Jupyter Notebook / JupyterLab(分段执行、即时看数) | VS Code / PyCharm + 虚拟环境(标准工程目录) |
| 语法重点 | 向量化切片、函数式处理、缺失值处理、时序转换 | 面向对象(类/继承)、闭包与装饰器、类型注解、异步语法 |
| 必修第三方库 | numpy, pandas, matplotlib, seaborn |
fastapi / django, pydantic, sqlalchemy |
| 数据库重点 | 单次聚合分析:大跨度 SELECT, GROUP BY, WINDOW FUNCTION |
实时事务读写:单行精确 INSERT/UPDATE、索引优化、外键约束 |
| 首个实战项目 | 公开电商/房产数据集清洗探索,产出数据洞察报告与复盘 | 带 JWT 登录认证和 CRUD 接口的博客/待办事项系统并部署 |
决策依据:你适合选哪一个?
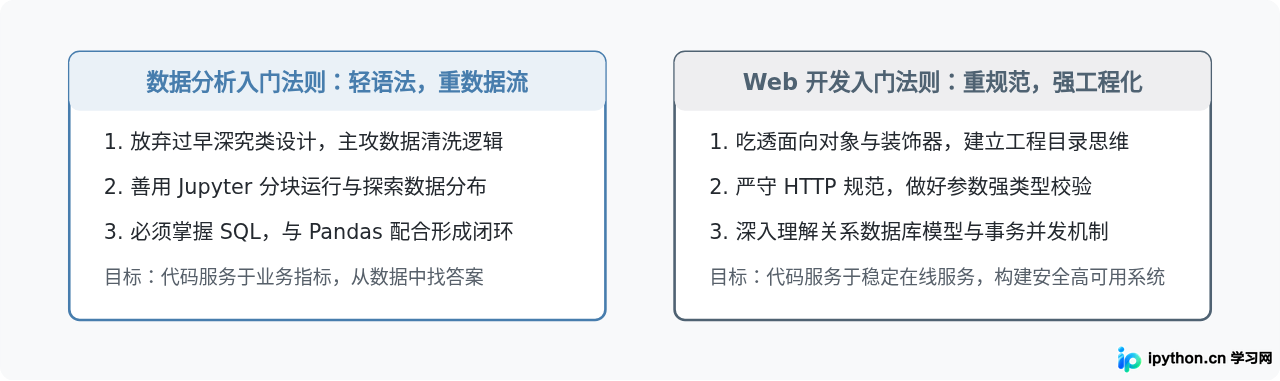
除了技术侧重点不同,转行选择更应该匹配你原本的思维偏好和对结果反馈的期待:
选择数据分析的判断依据:如果你对商业逻辑、业务增长、图表展示天然敏感,喜欢“顺藤摸瓜”找原因,并且原本在 Excel 里就经常研究各种函数和数据透视,那么数据分析的上手阻力会小很多。在这条路上,Python 只是一个效率倍增器,核心竞争力始终是对业务指标的拆解能力。
选择 Web 开发的判断依据:如果你热衷于“从无到有创造一个软件系统”,对底层架构、权限控制、自动化工具、服务器交互充满好奇,那么 Web 开发能带给你更持久的正反馈。在这条路上,核心竞争力是对软件工程规范、网络协议、接口安全性与系统稳定性的掌控度。
明确目标后,把有限的精力全部收敛到对应的学习主线上,删掉那些不属于你方向的教程章节,尽早完成第一个有反馈的完整实战,才是转行过程中最节省时间的方法。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















