


Python在金融科技与量化交易中的应用现状与技术栈

Python在当今金融科技(FinTech)与量化投资机构中处于核心生产力地位。它凭借活跃的数据科学社区、完善的标准接口以及极高的研发迭代效率,主导了从金融数据清洗、因子挖掘、策略建模到风险评估的完整研究链路;而在生产交易执行阶段,行业普遍采用“Python策略与风控胶水层 + C++/Rust极低延迟执行内核”的混合工程范式。本文将拆解Python在量化交易系统中的工程定位、整体系统架构、各层级的主流工具选型,以及从离线研究到实盘交易的标准落地路径。
一、Python的应用现状:核心主导场景与工程边界
评估Python在量化领域的角色,需要清晰界定其能力边界与计算场景的差异:
- 研究与探索分析的主导工具:金融时间序列分析、复杂衍生品定价、Alpha因子的提取与合成、机器学习模型调优等场景,对开发灵活性和交互式探索需求极高。Python凭借NumPy、Pandas、Polars与Scikit-Learn等生态构建了几乎无法被替代的研发工作台。
- 全链路自动化与胶水系统:量化系统需要串联行情数据源、研报数据库、风控引擎、柜台网关与报表通知服务。Python凭借丰富的网络与操作系统接口,担当着交易中台核心业务逻辑与流程调度的控制中心。
- 执行端的工程边界与技术互补:在亚毫秒级(Sub-millisecond)甚至纳秒级的高频高吞吐做市(HFT)和订单流套利中,Python由于全局解释器锁(GIL)、垃圾回收(GC)开销以及动态类型检查,无法直接承担超低延迟的行情解析与委托撮合。业界的成熟做法是利用Cython、Pybind11或PyO3(Rust)进行底层模块绑定,由C++或Rust实现底层网络协议解析(如FIX/FAST、二进制CTP)与撮合核心,再通过Python暴露高层策略与配置接口。
二、量化交易系统的全链路工程架构
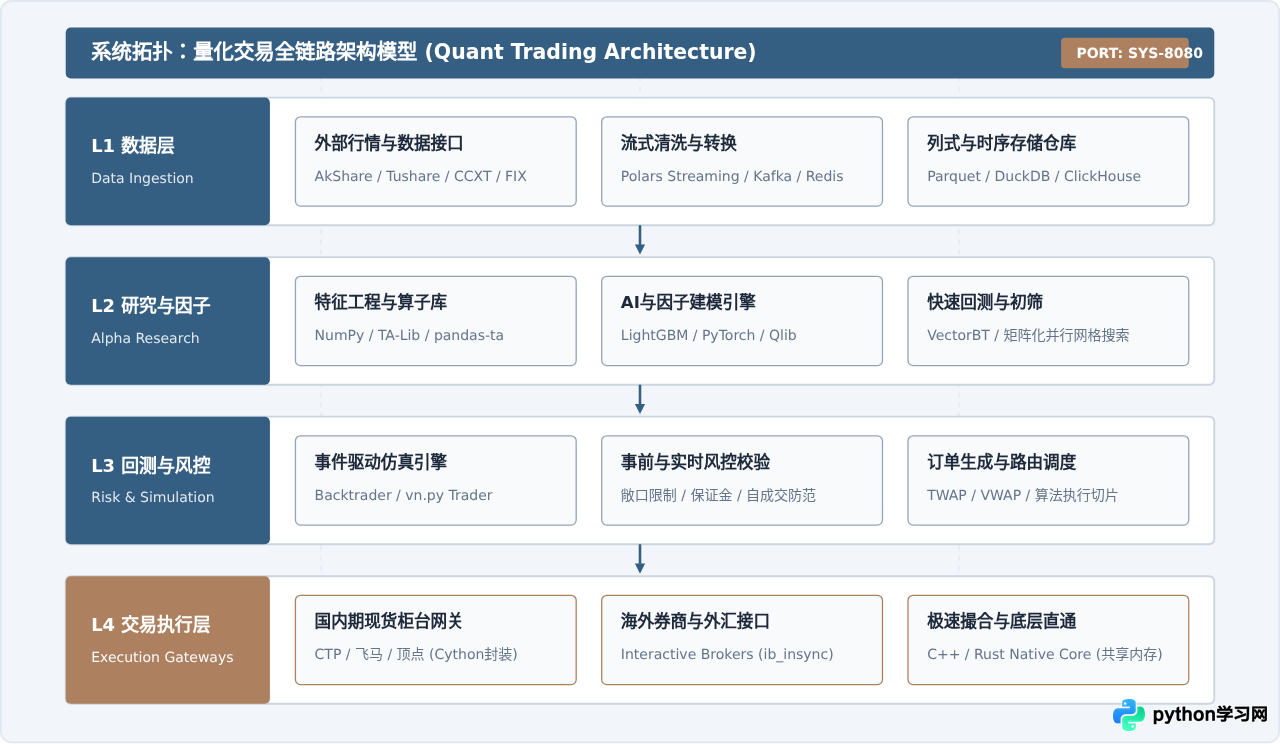
一个标准的量化交易系统通常遵循分层解耦的工程设计,涵盖数据持久化、因子与策略运算、风控审计及交易柜台接入四个主要层级。各层级之间通过规范化的数据格式与接口协议实现解耦联动。
三、主流技术栈分类详解与选型依据
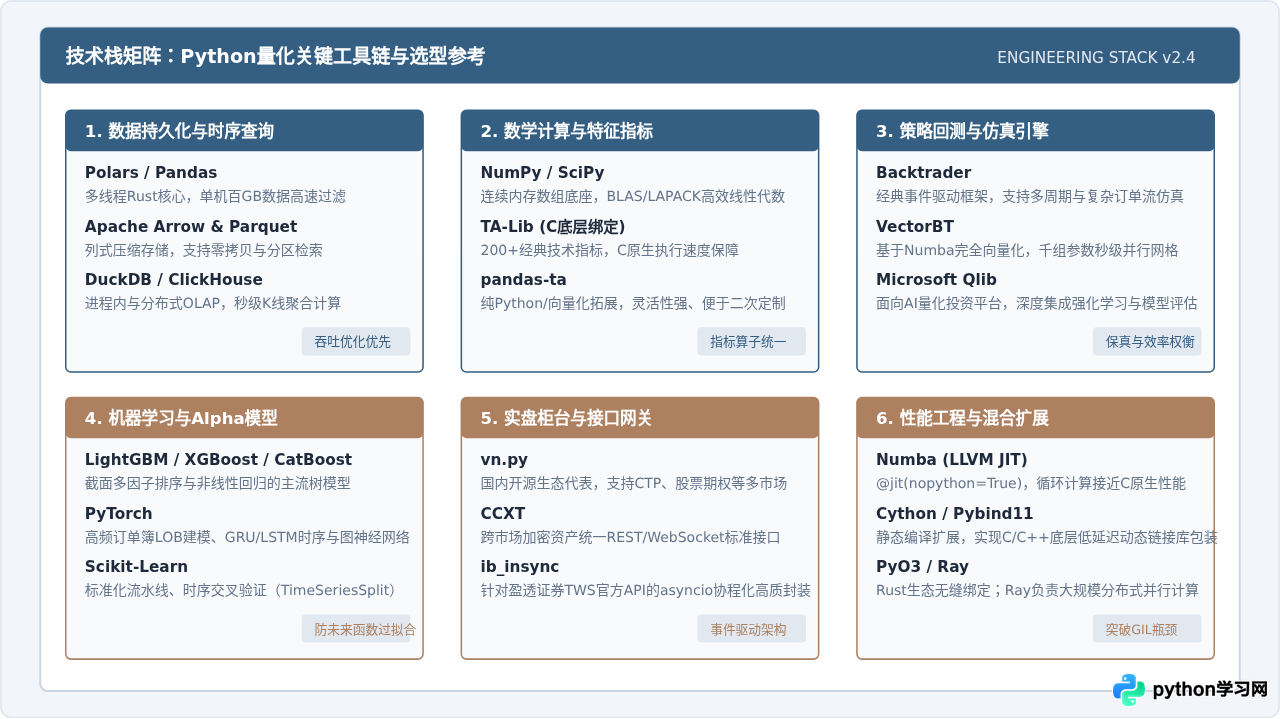
量化系统涉及从底层数据存储到高层策略运算的多种类库。根据实际生产场景的需求特征,主要技术组件分类如下:
1. 数据获取与列式时序存储
金融行情数据具有典型的高频、时序与连续特征。传统使用Pandas直接读取巨大CSV文件极易遭遇内存溢出(OOM)。现代量化团队普遍升级至Polars + Parquet/DuckDB组合:
- Parquet:列式存储格式,具备极高的高压缩比(普遍达到4x-10x)并支持谓词下推(Predicate Pushdown),只加载所需字段与时间段。
- Polars:底层基于Rust与Apache Arrow内存模型开发,支持真正的多核心并行处理与惰性求值(Lazy Execution),在十亿级逐笔委托与成交数据的清洗场景中,运算性能可比原生Pandas提升一个数量级。
2. 回测框架选型:向量化 vs 事件驱动
策略研发必须明确区分两种不同的回测机制:
| 回测范式 | 代表框架 | 核心原理 | 计算速度 | 仿真保真度 | 适用业务场景 |
|---|---|---|---|---|---|
| 向量化回测 | VectorBT, PyAlgoTrade (部分) | 基于矩阵乘法和向量切片同时计算全时间段信号与持仓 | 极快(秒级完成数千组参数) | 较低(难以精确模拟排队撮合、逐笔滑点与复杂资金占用) | 多因子初筛、大规模参数网格优化、中低频截面排序 |
| 事件驱动回测 | Backtrader, vn.py, Zipline | 逐Bar或逐Tick生成事件,严格模拟订单提交、撮合排队、状态回调与成交通知 | 较慢(按单步循环驱动) | 极高(完全贴近实盘生命周期,支持分笔资金风控) | 日内CTA趋势突破、微结构套利、实盘上线前压力测试 |
下面给出一段经典的Backtrader事件驱动双均线策略最小工程示例,展示策略逻辑的组织形式:
import backtrader as bt

class SmaCrossStrategy(bt.Strategy):
    params = (
        ('fast_period', 10),
        ('slow_period', 30),
    )

    def __init__(self):
        # 缓存基础价格线并绑定经典指标
        self.dataclose = self.datas[0].close
        self.fast_ma = bt.indicators.SimpleMovingAverage(self.datas[0], period=self.params.fast_period)
        self.slow_ma = bt.indicators.SimpleMovingAverage(self.datas[0], period=self.params.slow_period)
        self.crossover = bt.indicators.CrossOver(self.fast_ma, self.slow_ma)

    def next(self):
        # 每一个Bar时间片到达时触发一次事件驱动计算
        if not self.position:
            if self.crossover > 0:  # 快线上穿慢线:金叉买入
                self.buy(size=100)
        elif self.crossover < 0:    # 快线下穿慢线:死叉平仓
            self.close()

if __name__ == '__main__':
    cerebro = bt.Cerebro()
    cerebro.addstrategy(SmaCrossStrategy, fast_period=10, slow_period=30)

    # 注入标准行情切片
    data = bt.feeds.GenericCSVData(
        dataname='market_daily_sample.csv',
        datetime=0, open=1, high=2, low=3, close=4, volume=5, openinterest=-1
    )
    cerebro.adddata(data)
    cerebro.broker.setcash(1000000.0)
    cerebro.broker.setcommission(commission=0.0003)  # 考虑万三印花/手续费
    cerebro.run()
    print(f"最终资产价值: {cerebro.broker.getvalue():.2f}")
四、策略标准化研发流程:从假设到实盘的闭环
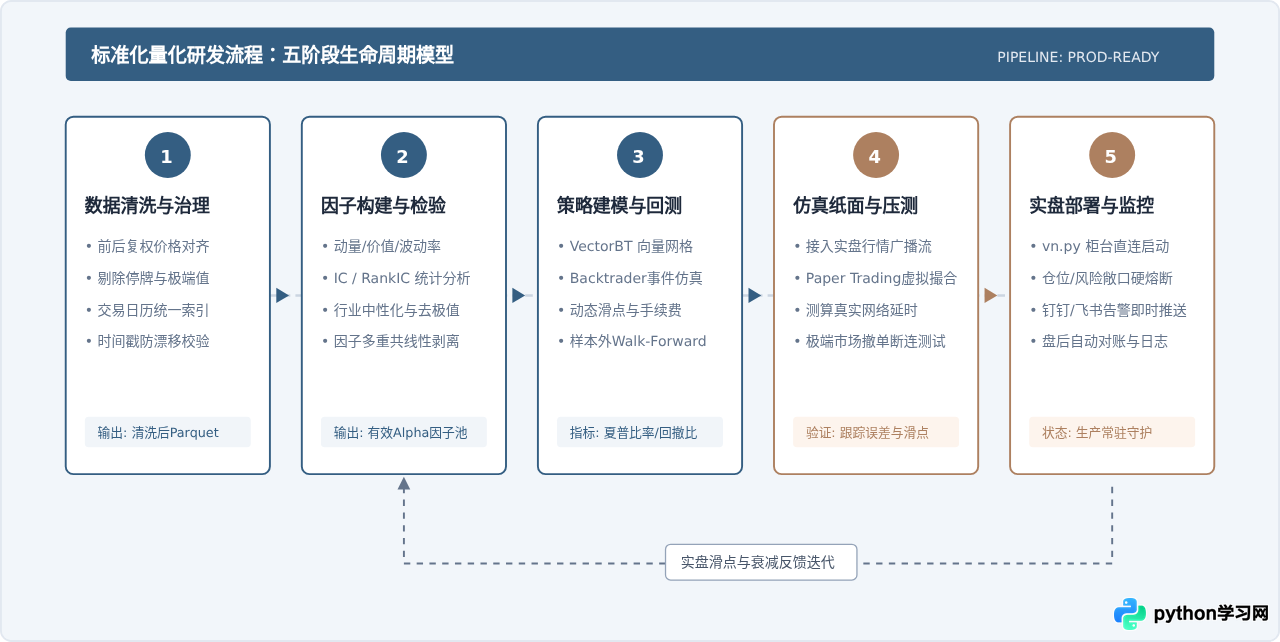
严谨的量化开发绝非在历史数据上反复调优参数,而是需要遵循严格的工程生命周期,防止“过拟合(Overfitting)”与“未来函数(Look-ahead Bias)”。
1. 前视偏差隔离:计算日线指标时,当日决策仅能使用 $t-1$ 日及之前的已收盘数据;若使用当日收盘价撮合,需强制添加下一交易日开盘成交与延时逻辑。
2. 幸存者偏差(Survivorship Bias):回测股票池必须动态纳入历史上已退市的标的,否则回测年化收益会显著虚高。
3. 成交量容量与市场冲击:回测中单笔委托量不应超过该Bar总成交量的5%至10%,并需引入二次方市场冲击成本模型。
五、工程性能突破与系统选型决策
当面对超高频逐笔计算或百个标的的并行风控时,常规Python循环会成为主要性能瓶颈。量化团队主要通过以下手段进行性能加速与系统选型:
1. 针对密集计算的JIT与扩展编译
- Numba JIT:对于具有强前后依赖关系的循环算法(如自适应移动止损、递归滤波计算),直接使用
@numba.njit(fastmath=True)装饰器,LLVM会在运行时将其编译为原生机器码,运行速度接近C。 - PyO3与Rust协同:在需要构建安全高并发的行情解析或订单路由网关时,通过PyO3编写Rust模块编译为Python wheel包。Rust的无垃圾回收和内存所有权机制,既能保证亚微秒级的确定性执行,又能向Python策略层提供简洁的API调用接口。
2. 回测与交易系统的选型决策树
面对不同的交易标的与频段要求,研发人员可以根据以下逻辑决策图确定最匹配的技术路线:
六、总结与落地建议
Python在量化交易领域确立了无可动摇的研发枢纽地位。在构建现代量化系统时,建议遵循以下工程原则:
- 分频治理,各司其职:切勿试图使用纯Python重写所有底层低延迟协议;低频与中频场景优先使用成熟Python生态提高策略迭代速率,超高频核心交给C++或Rust,并通过标准二进制或绑定接口交互。
- 拥抱现代时序栈:逐步用Polars和Parquet替代传统的单线程Pandas和CSV存储,在研发初期建立良好的数据底座与严谨的防未来函数校验体系。
- 关注全周期交易摩擦:任何优秀的回测表现都必须在考虑滑点、手续费、市场冲击与网络延时的约束下审视,通过模拟盘验证后再平滑接入实盘。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















