


Python网络爬虫基础代码模板:使用requests和BeautifulSoup抓取网页
本文提供了一套标准的Python网络爬虫基础代码模板,详细讲解如何使用requests库处理网络通信与请求头,并结合BeautifulSoup实现DOM树解析与数据提取,包含完整代码与健壮性处理。
抓取静态网页内容并不需要一开始就引入庞大的爬虫框架。在绝大多数日常抓取场景中,网络通信由 requests 负责获取原始 HTML 文档,文档解析由 BeautifulSoup 负责遍历提取所需字段,两者结合即可完成稳定高效的数据抓取任务。本文将直接提供一套开箱即用的标准代码模板,并详细剖析请求构建、DOM节点提取与异常防御的关键要点。
一、架构协作:requests 与 BeautifulSoup 的分工机制
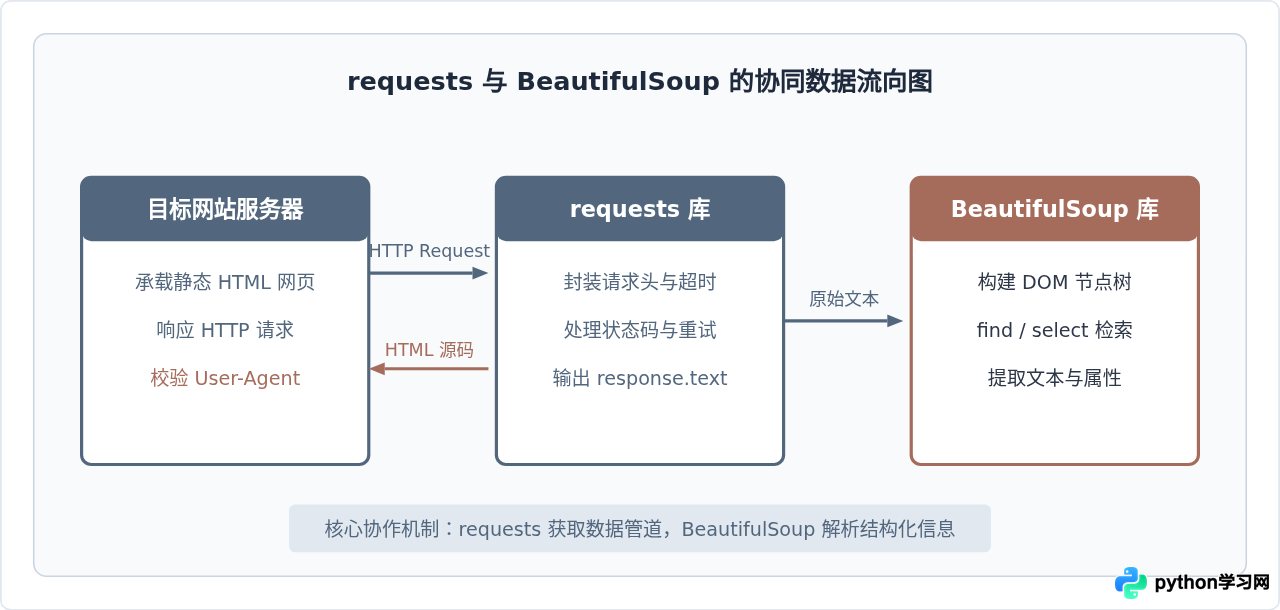
许多初学者在刚开始编写爬虫时容易混淆两个库的具体职能。实际上,网络爬虫的工作链路本质上分为“数据获取”与“文本解析”两个完全独立的阶段。requests 是一个底层的 HTTP 客户端,其核心功能是向目标服务器发送网络协议请求,并接收服务器返回的状态码、响应头与字节流;它完全不理解 HTML 的标签嵌套与节点语法。而 BeautifulSoup 是一个解析器包装库,它不能发起任何网络请求,必须接收现成的 HTML 字符串,将其构建为结构化的 DOM 语法树,从而允许开发者通过标签名称、类名或属性进行定位和提取。
二、环境依赖与准备工作
在编写代码前,必须确保安装了两个核心第三方库。建议同时安装 lxml 解析器,相比 Python 自带的 html.parser,lxml 在处理体积较大或标签不闭合的破损网页时拥有更高的执行速度和容错能力。
在命令行终端执行以下命令进行安装:
pip install requests beautifulsoup4 lxml注意:在安装包名上,BeautifulSoup 的最新第4版在 PyPI 中的全名是 beautifulsoup4,但代码导入时的模块名为 from bs4 import BeautifulSoup,切勿混淆。
三、核心基础代码模板
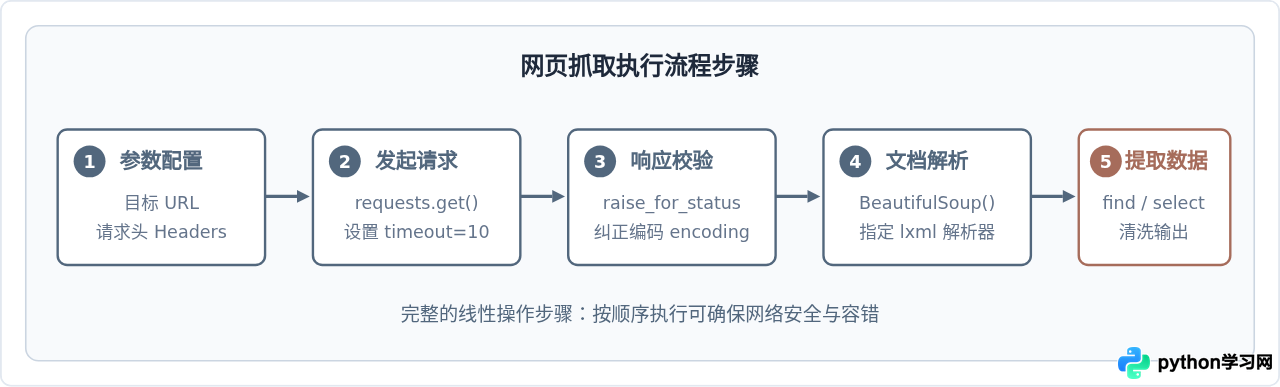
下面是一个标准的爬虫代码模板。该模板封装了自定义请求头(User-Agent)、网络超时设定、状态码校验、页面编码修正以及 DOM 节点解析与结构化打印,可以直接保存为 scraper_template.py 运行测试。
下面给出完整的代码实现:
import requests
from bs4 import BeautifulSoup

def fetch_webpage(target_url):
    """
    负责发起 HTTP 请求并获取经过编码处理的 HTML 源码文本
    """
    # 模拟真实浏览器请求头,避免大部分基础反爬拦截
    headers = {
        "User-Agent": (
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/122.0.0.0 Safari/537.36"
        ),
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
    }

    try:
        # 发起 GET 请求,设置合理的超时时间防止请求永久挂起
        response = requests.get(target_url, headers=headers, timeout=10)

        # 当 HTTP 状态码为 4xx 或 5xx 时主动抛出 HTTPError 异常
        response.raise_for_status()

        # 根据 HTTP 响应正文推断实际字符集,避免中文乱码
        response.encoding = response.apparent_encoding

        return response.text

    except requests.exceptions.Timeout:
        print("[错误] 请求超时,请检查网络或目标网站连接状态。")
    except requests.exceptions.HTTPError as http_err:
        print(f"[错误] HTTP 状态异常: {http_err} (状态码: {response.status_code})")
    except requests.exceptions.RequestException as req_err:
        print(f"[错误] 网络请求失败: {req_err}")

    return None

def parse_html(html_content):
    """
    解析 HTML 文档并提取结构化数据
    """
    if not html_content:
        return []

    # 使用 lxml 引擎构建 BeautifulSoup 对象
    soup = BeautifulSoup(html_content, "lxml")

    results = []

    # 示例提取:假设目标网页结构中包含若干 class 为 'post-card' 的文章卡片
    items = soup.find_all("div", class_="post-card")

    for item in items:
        # 安全查找子元素,防止单条数据缺失导致程序崩溃
        title_node = item.find("h2", class_="post-title")
        link_node = item.find("a", href=True)
        date_node = item.find("span", class_="post-date")

        title = title_node.get_text(strip=True) if title_node else "无标题"
        link = link_node["href"] if link_node else ""
        date = date_node.get_text(strip=True) if date_node else "未知日期"

        results.append({
            "title": title,
            "link": link,
            "date": date
        })

    return results

if __name__ == "__main__":
    # 以实际抓取目标 URL 为例
    url = "https://example.com/blog"
    html = fetch_webpage(url)

    if html:
        data = parse_html(html)
        print(f"成功提取到 {len(data)} 条数据记录。")
        for idx, entry in enumerate(data, start=1):
            print(f"[{idx}] {entry['title']} | {entry['date']} | {entry['link']}")
四、定位与提取策略:find 与 CSS 选择器的对比
在解析 HTML 时,BeautifulSoup 提供了两套最常用的查询接口:基于关键字参数的 find / find_all 方法,以及基于标准 CSS 选择器语法的 select / select_one 方法。理解两者的语法特点和适用场景,能够使提取代码更加简洁。
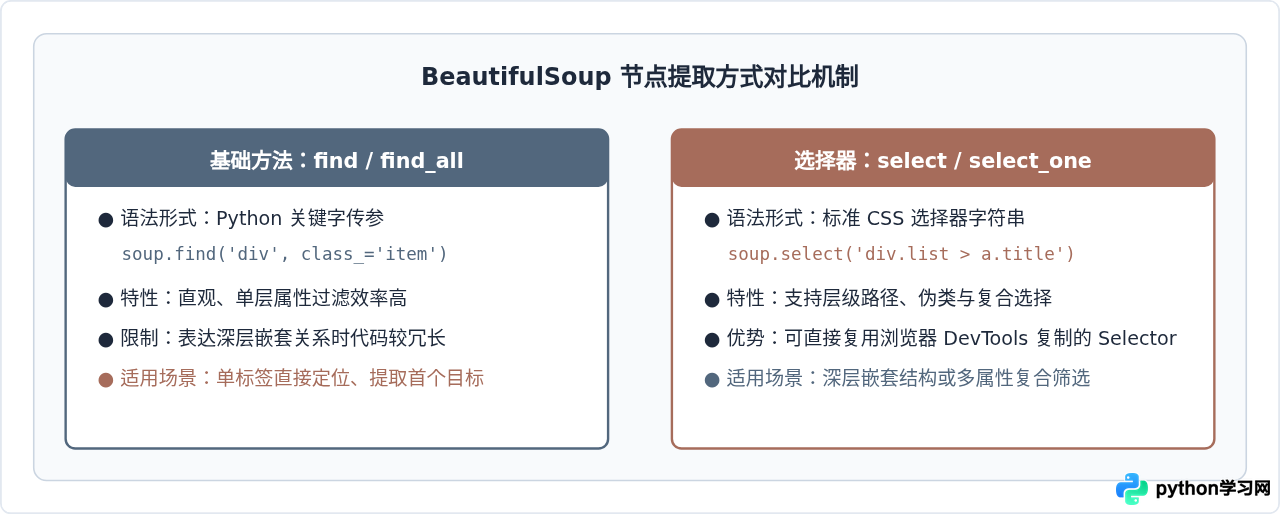
在实际编码中,可以根据页面层级复杂度灵活选择:
- 单层简单提取:使用
soup.find('h1')能够最快定位页面唯一标题。注意若通过 class 属性筛选,必须写为class_="target-class",因为class是 Python 的保留关键字。 - 深层路径匹配:如果需要获取
<div class="content">下第三个列表项里的超链接,写成 CSS 选择器soup.select("div.content ul > li a")远比连续链式调用find()更加紧凑且易读。 - 获取文本与属性:获取标签内纯文本时优先使用
node.get_text(strip=True),它会自动去除首尾多余换行与空格;获取标签属性则采用字典索引方式,如node['href']或node.get('src')。
五、容易忽略的关键细节与防御机制
编写爬虫不仅要保证“在正常情况下能抓出数据”,更要确保“在遇到异常时程序不崩溃、不卡死、不产出脏数据”。以下三个细节是编写爬虫时最容易被忽略的环节:
1. 必须显示指定超时参数(timeout)
在默认情况下,requests.get() 没有设置超时时间。如果目标服务器发生死锁、网络拥堵或丢包,程序将会永远阻塞在该请求上,导致整个后续流程彻底挂起。因此,务必在每次请求中显式设置 timeout=10(以秒为单位)。
2. 字符编码识别与修正
当打印抓取到的中文文本出现 ä½ 之类的乱码时,通常是因为 requests 根据 HTTP 头部的 Content-Type 猜错了编码(例如将 utf-8 猜为了 ISO-8859-1)。在调用 response.text 之前执行 response.encoding = response.apparent_encoding,可以让 requests 基于正文内容的实际字节特征重新推测编码,绝大多数乱码问题都可以因此解决。
3. 防范“空指针”None 异常
网页中部分数据项可能是可选的(例如某篇文章没有子标题或没有配图)。如果直接调用 item.find("span").get_text(),一旦 find() 找不到该标签返回 None,程序就会立即抛出 AttributeError: 'NoneType' object has no attribute 'get_text' 并退出。如模板中所示,必须使用条件判断或三元表达式进行防御性提取。
六、总结与健壮性自查
使用 requests 和 BeautifulSoup 抓取网页是 Python 数据采集的基础功底。掌握好基础模板后,无需复杂配置即可应对大部分静态页面需求。
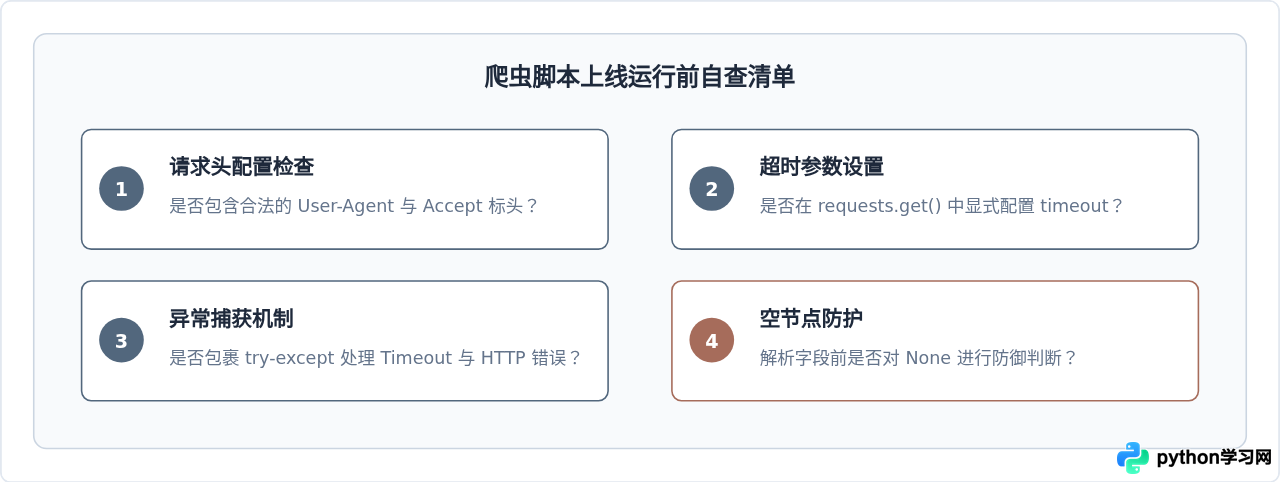
只要牢记“请求配超时、头信息伪装、编码重推测、解析防空指针”这四项原则,就能确保基础爬虫在面对网络波动与页面微调时依然稳健运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















