


Python爬虫入门:用requests和BeautifulSoup抓取第一个网页
面向初学者的Python网络爬虫实战指南,讲解如何搭配使用requests发起网络请求并利用BeautifulSoup解析HTML结构,手把手完成第一个基础网页的数据抓取与保存。
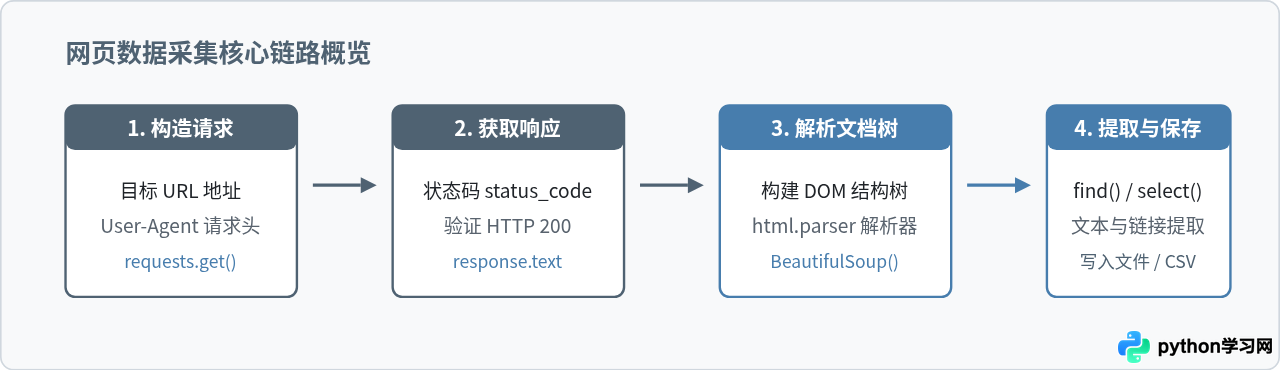
抓取一个网页的核心逻辑可以浓缩为两个明确步骤:首先使用 requests 库向目标服务器发送网络请求并拿到原始 HTML 文本,随后使用 BeautifulSoup 将文本解析为易于检索的文档对象模型(DOM)树,进而定位并提取所需数据。本文将以抓取结构规则的标准练习网页为例,演示从安装依赖、发起请求、解析标签到将结果写入文件的完整操作流程。
环境准备与两套工具的职责边界
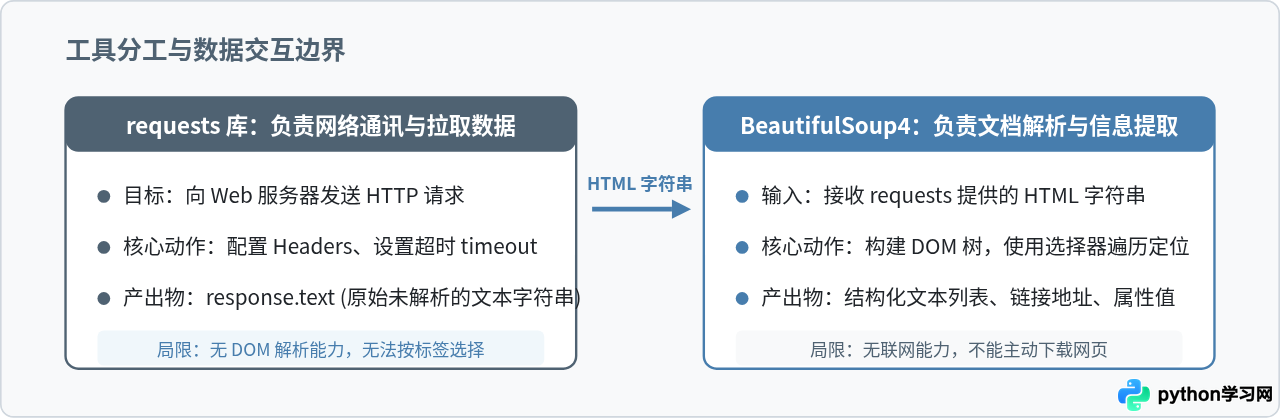
在开始编写代码前,必须清楚 requests 与 BeautifulSoup 在爬虫生命周期中的明确分工。爬虫并非单一黑盒程序,而是网络传输与文本处理两个独立环节的组合:
- requests 负责“抓”:它扮演的是浏览器底层网络通讯模块的角色,负责向目标网址发起 GET 或 POST 请求、携带必要的 HTTP 请求头(如 User-Agent)、接收服务器返回的状态码以及提取原始响应文本。它不理解任何 HTML 语法。
- BeautifulSoup 负责“选”:它不具备任何联网能力。它的唯一输入是字符串形式的 HTML,通过内置或外部解析引擎将一长串混乱的标签字符转变成一棵具有父子层级关系的文档对象树,让开发者可以通过标签名称、CSS 类名或属性直接检索目标内容。
安装所需第三方库
在终端或命令行工具中,执行以下 pip 命令安装两个核心依赖。BeautifulSoup 在 PyPI 上的包名为 beautifulsoup4:
pip install requests beautifulsoup4安装完成后,可在 Python 交互式环境中执行 import requests; from bs4 import BeautifulSoup 验证是否成功导入。若无报错,则说明环境准备就绪。
第一步:使用 requests 发送请求并获取网页源码
网络请求是抓取任务的前提。若直接使用 requests.get(url),默认携带的 User-Agent 会直接暴露 Python 脚本身份,很多服务器会直接返回 403 Forbidden 拦截。因此在发起请求时,必须显式定义请求头字典模拟正常的桌面浏览器。
import requests

url = "https://quotes.toscrape.com/"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

try:
    response = requests.get(url, headers=headers, timeout=10)
    # 状态码判断:如果服务器返回非 200 代码,主动抛出 HTTPError 异常
    response.raise_for_status()
    # 统一设定正确的编码格式
    response.encoding = response.apparent_encoding
    html_content = response.text
    print(f"成功获取页面,内容长度:{len(html_content)} 字符")
except requests.exceptions.RequestException as err:
    print(f"网络请求失败:{err}")
    html_content = ""
关键参数说明:timeout=10 用于限制最长等待时间为 10 秒,防止因网络拥堵导致程序无休止挂起;response.apparent_encoding 能基于响应体内容推断编码(如 UTF-8 或 GBK),避免中文网页抓取后出现乱码。
第二步:使用 BeautifulSoup 解析 HTML 与定位节点
获取到 html_content 字符串后,需要将其交给 BeautifulSoup 进行结构化。在解析前,需要通过浏览器的“检查”(DevTools)面板确认目标网页标签的排布规律。
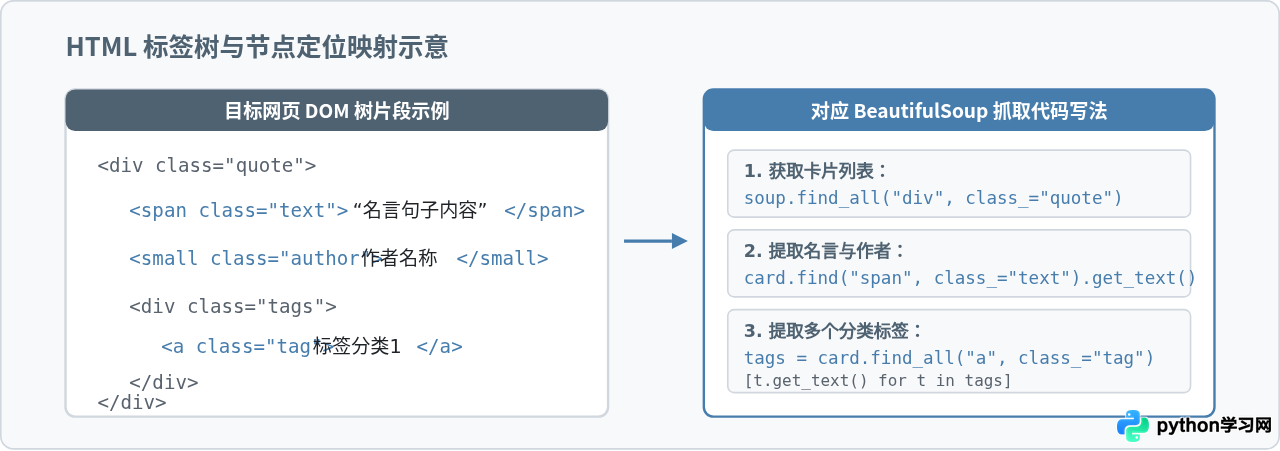
以测试网页 quotes.toscrape.com 为例,每条名言卡片都被包裹在 <div class="quote"> 容器中。在该容器内部:
- 名言文字位于
<span class="text">标签内; - 名言作者位于
<small class="author">标签内; - 分类标签位于
<div class="tags">内部的多个<a class="tag">标签内。
常用查找 API 对比
在定位节点时,推荐优先使用 find()、find_all() 或基于 CSS 语法的 select():
| 方法 | 返回值 | 典型调用语法 | 适用场景 |
|---|---|---|---|
soup.find(name, attrs) |
第一个匹配的 Tag 节点(无匹配返回 None) | soup.find("h1") |
页面中唯一的标题、特定 ID 区域 |
soup.find_all(name, attrs) |
包含所有匹配节点的列表(List) | soup.find_all("div", class_="quote") |
循环遍历结构相同的内容卡片、列表项 |
soup.select(selector) |
匹配 CSS 选择器的所有节点列表 | soup.select(".quote > .text") |
偏好前端 CSS 选择器语法、层级复杂的定位 |
第三步:完整的第一个网页抓取与存储脚本
将请求与解析整合成一个自包含脚本,并在提取数据后将其保存为标准的 CSV 文件,方便后续利用 Excel 或数据分析工具读取:
import csv
import requests
from bs4 import BeautifulSoup

def scrape_first_page():
    # 1. 目标地址与请求头设置
    target_url = "https://quotes.toscrape.com/"
    headers = {
        "User-Agent": (
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/120.0.0.0 Safari/537.36"
        )
    }

    print(f"正在请求:{target_url}")
    try:
        response = requests.get(target_url, headers=headers, timeout=10)
        response.raise_for_status()
        response.encoding = response.apparent_encoding
    except requests.exceptions.RequestException as err:
        print(f"网络异常导致抓取中止:{err}")
        return

    # 2. 构建 BeautifulSoup 对象
    soup = BeautifulSoup(response.text, "html.parser")

    # 3. 定位所有的名言卡片
    quote_cards = soup.find_all("div", class_="quote")
    print(f"共发现 {len(quote_cards)} 条数据卡片")

    results = []
    # 4. 循环遍历提取具体字段
    for item in quote_cards:
        # 提取文字并去除首尾空格
        text_node = item.find("span", class_="text")
        text = text_node.get_text(strip=True) if text_node else "无文本"

        # 提取作者
        author_node = item.find("small", class_="author")
        author = author_node.get_text(strip=True) if author_node else "未知作者"

        # 提取所有标签
        tag_nodes = item.find_all("a", class_="tag")
        tags = [t.get_text(strip=True) for t in tag_nodes]
        tags_str = "/".join(tags)

        results.append({
            "quote": text,
            "author": author,
            "tags": tags_str
        })

    # 5. 写入本地 CSV 文件
    csv_filename = "scraped_quotes.csv"
    with open(csv_filename, "w", newline="", encoding="utf-8-sig") as f:
        writer = csv.DictWriter(f, fieldnames=["quote", "author", "tags"])
        writer.writeheader()
        writer.writerows(results)

    print(f"抓取完成!数据已成功保存至 {csv_filename}")

if __name__ == "__main__":
    scrape_first_page()
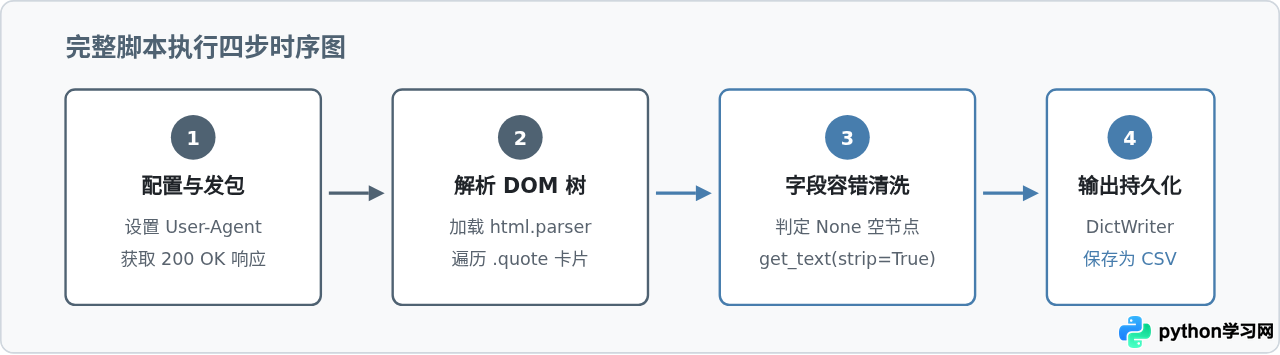
示例运行输出结果
在终端运行上述脚本后,将看到如下形式的输出信息(示例):
正在请求:https://quotes.toscrape.com/
共发现 10 条数据卡片
抓取完成!数据已成功保存至 scraped_quotes.csv
打开生成的 scraped_quotes.csv 文件,可以查看提取好的纯净表格数据:
quote,author,tags
"“The world as we have created it is a process of our thinking...”",Albert Einstein,change/deep-thoughts/thinking/world
"“It is our choices, Harry, that show what we truly are...”",J.K. Rowling,abilities/choices
"“There are only two ways to live your life. One is as though nothing is a miracle...”",Albert Einstein,inspirational/life/live/miracle/miracles
新手常见问题与排查路线
初学者在尝试抓取其他网页时,常会遇到以下三种典型故障:
- HTTP 403 访问拒绝:绝大多数情况下是由于请求头缺失。请检查
headers字典中是否配置了规范的User-Agent。对于防护稍严格的站点,还可能需要按需补齐Referer、Accept-Language等请求头字段。 - 查找到的标签列表为空:如果在浏览器按 F12 能够看到标签,但
find_all()返回结果为空,大概率是因为目标数据由 JavaScript 异步渲染(如使用 React 或 Vue),或者页面内容由后续 AJAX 接口提供。此时仅通过requests.get()获取到的只是骨架 HTML,应在浏览器 Network 面板中寻找返回 JSON 数据的接口,或改用自动化浏览器工具。 - 中文显示乱码:直接打印
response.text出现乱码时,通常是 requests 猜错了页面字符集。可在读取response.text之前显式赋值response.encoding = "utf-8"或response.encoding = response.apparent_encoding。
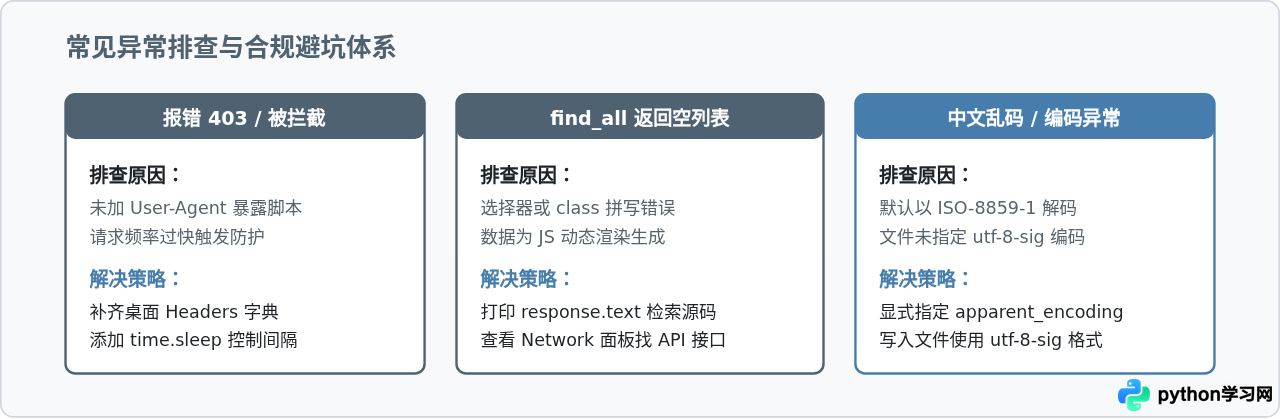
合规与频率控制
在编写爬虫时,应始终遵守网络爬取规范。首先通过访问目标网站根目录下的 /robots.txt 文件了解站方的爬取规则与禁止路径;其次,应始终在请求循环中通过 time.sleep(1) 保持温和的请求频率,避免在短时间内发起海量并发请求对目标服务器带来不必要的计算负担。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















