


Python map函数与列表推导式对比:何时选择哪种写法更合适

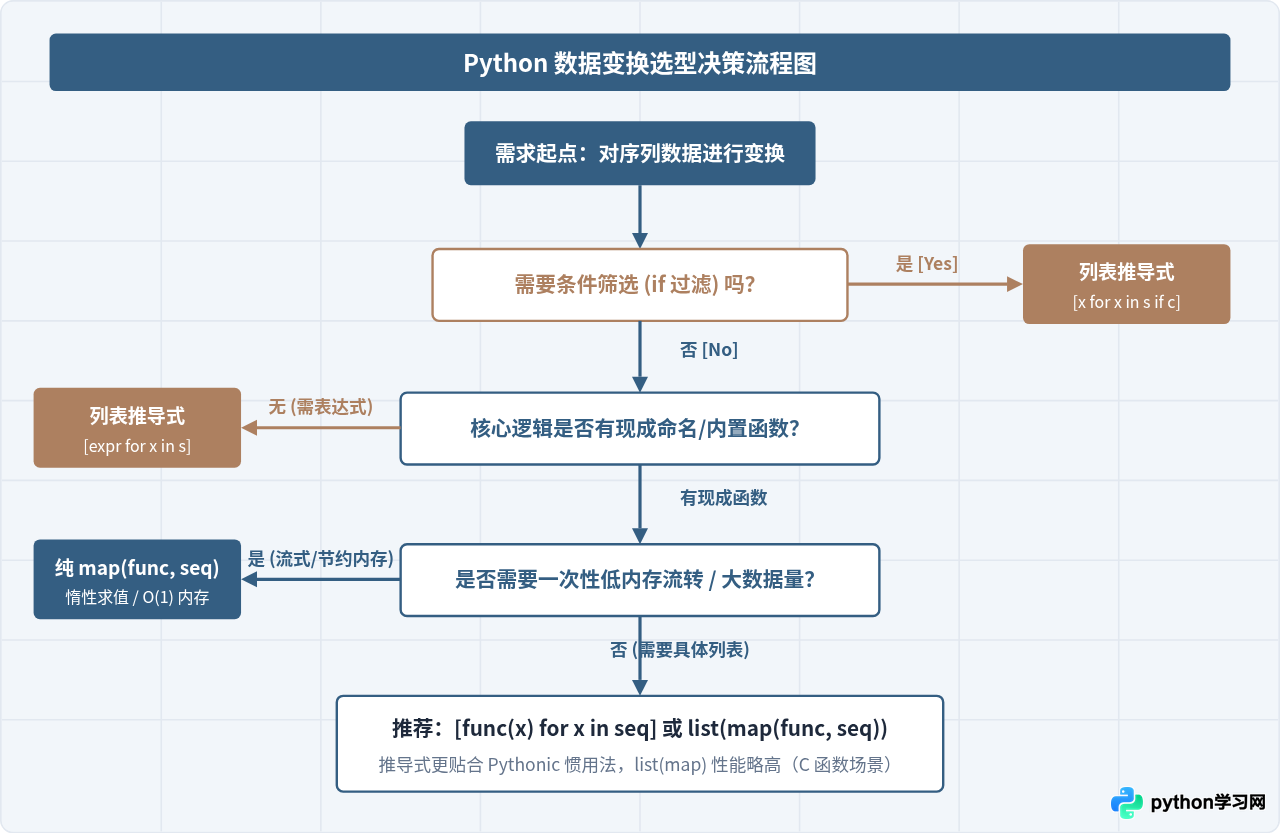
map() 与列表推导式(List Comprehension)是实现相同目标的两套核心机制。简明选择结论是:当需要调用已有的内置函数或命名函数、且希望利用惰性求值特性节省内存时,优先使用 map();当转换逻辑涉及数学运算表达式、条件筛选过滤、多层嵌套,或者明确需要直接得到一个完整列表时,列表推导式在代码可读性与执行效率上更为合适。
一、核心语法结构与设计理念
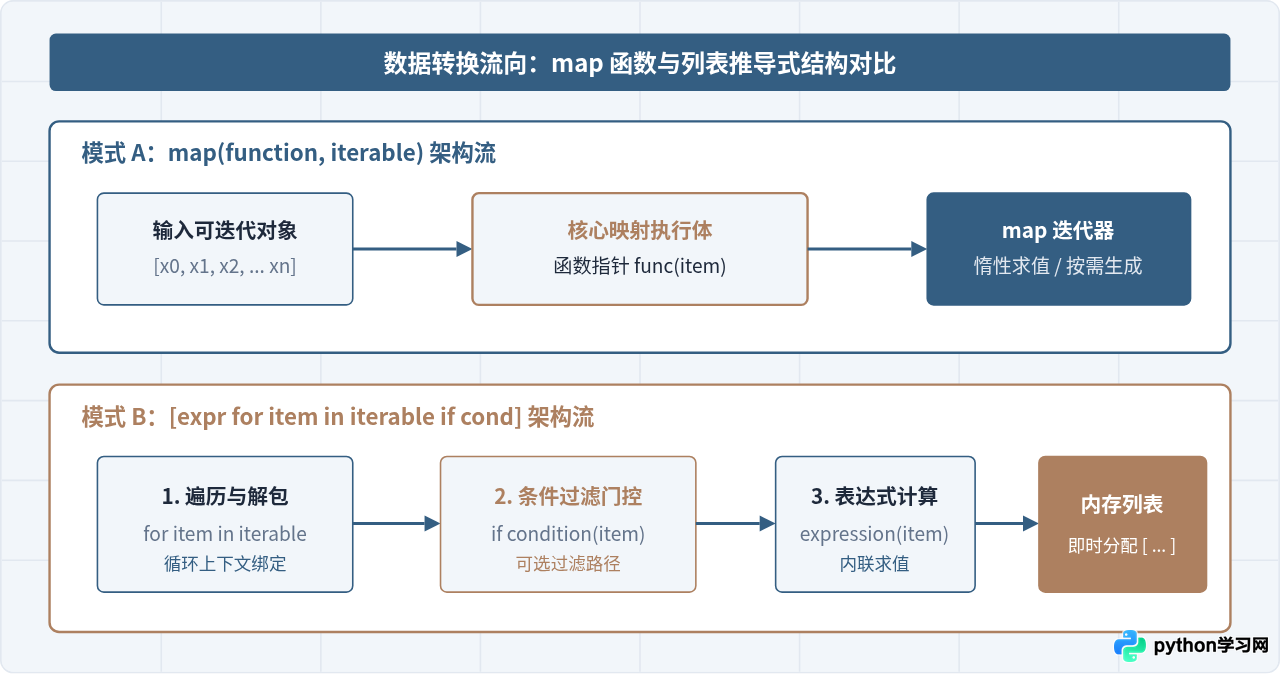
理解两者的差异首先需要从它们的基本语法形态入手。map() 源于函数式编程范式,其设计初衷是将一个确定的函数映射到一个或多个可迭代对象的每个元素上;而列表推导式则是 Python 提供的专用语法糖,旨在通过类似数学集合推导的形式直观构建新列表。
1. 基本书写形式
假设我们有一组字符串数字,需要将其逐项转为整数,两种写法的对照如下:
# 待处理数据
raw_numbers = ["10", "20", "30", "40", "50"]

# 方式一:使用 map 函数
# map 接收函数对象与可迭代对象,返回一个 map 迭代器
map_result = map(int, raw_numbers)

# 方式二:使用列表推导式
# 明确遍历元素并在前方执行类型转换表达式
list_comp_result = [int(item) for item in raw_numbers]
在已有现成命名函数(例如 int、str.strip、abs)的场景下,map(int, raw_numbers) 的语义非常纯粹——“将 int 规则应用到序列”。然而,一旦逻辑脱离现成函数,需要进行自定义运算时,两者的可读性差距就会显现:
# 对每个数值求平方并加上 3
# 使用 map 需要配合匿名函数 lambda
calc_map = map(lambda x: x ** 2 + 3, [1, 2, 3, 4])

# 使用列表推导式,表达式直接内联
calc_comp = [x ** 2 + 3 for x in [1, 2, 3, 4]]
当引入 lambda 后,map() 的语法噪音明显增多,而列表推导式保持了自然的数学表达语序,可读性显著更佳。
二、求值机制与内存开销:惰性迭代器与即时装箱
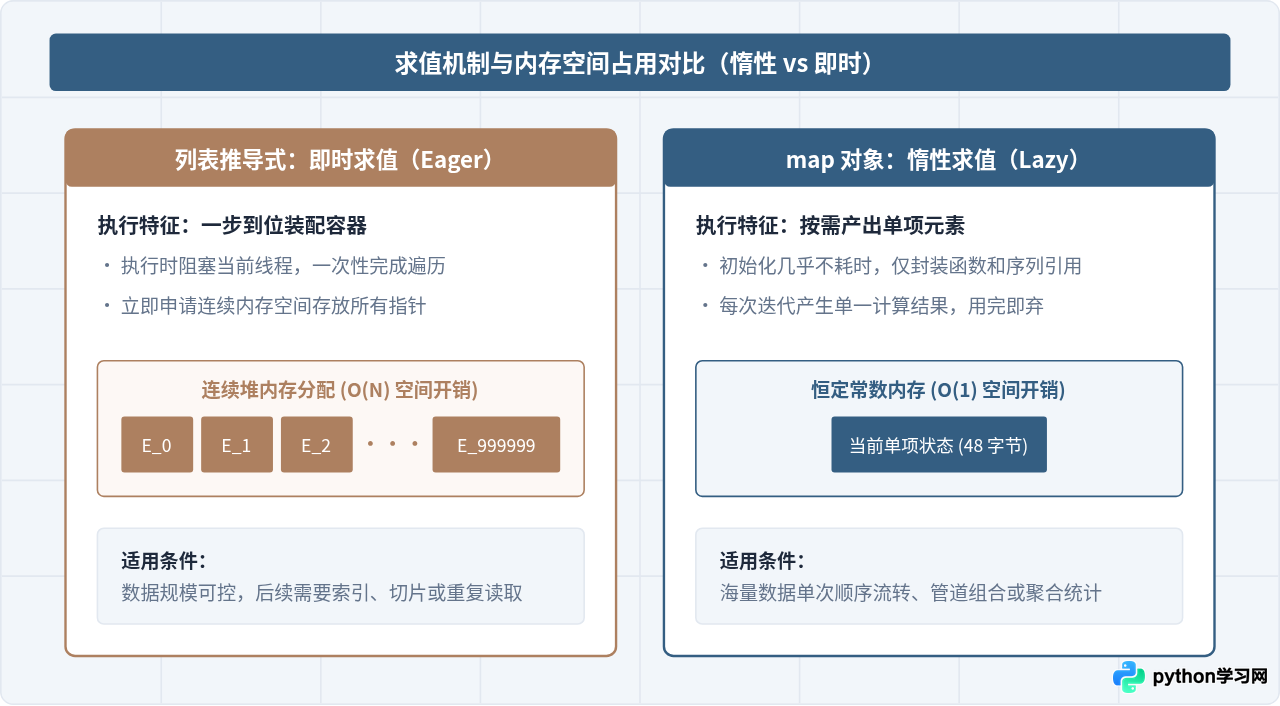
在 Python 3 中,两者在求值时机和内存占用模式上有着本质区别:
map()采用惰性求值(Lazy Evaluation):调用map()时不会对列表内的任何元素进行计算,它仅仅返回一个占用恒定微小内存的迭代器对象。只有当外部代码通过for循环、next()或类型转换消费该迭代器时,计算才会逐项触发。- 列表推导式采用即时求值(Eager Evaluation):一旦代码执行到推导式,Python 会立即运行循环,计算所有元素并将它们保存在一个全新的
list对象中,立即占用与数据规模成正比的堆内存。
1. 内存占用实测对比
通过 Python 标准库的 sys.getsizeof() 可以直观验证内存差异:
import sys

# 构建一个包含 100 万个整数的区间
data_source = range(1000000)

# map 对象:仅保存函数与迭代器指针
map_obj = map(lambda x: x * 2, data_source)
print(f"map 对象占用内存: {sys.getsizeof(map_obj)} 字节")
# 示例输出:map 对象占用内存: 48 字节

# 列表推导式:即时在内存中完整分配一个包含 100 万个新元素的列表
comp_obj = [x * 2 for x in data_source]
print(f"列表推导式结果占用内存: {sys.getsizeof(comp_obj)} 字节")
# 示例输出:列表推导式结果占用内存: 8448728 字节 (约 8.05 MB)
若处理的数据量达到千万级或涉及无限序列,使用列表推导式极易导致内存耗尽(OOM)。但需要注意的是,如果在 map 外部套用 list(map(...)),就会强行将迭代器展开为列表,此时惰性求值的内存优势荡然无存。
三、执行性能剖析与底层调用差异
在性能测试中,常常会出现看似矛盾的结果:有时 map() 比列表推导式更快,有时却慢得多。造成这种现象的核心原因在于底层解释器对函数调用开销的处理差异。
1. 为什么 map 搭配 C 内置函数更快?
当处理逻辑是 Python 的 C 语言内置函数(如 str、int、abs)时,map() 的内部循环是完全由 C 语言层级的解释器内核驱动的,无需在虚拟机中频繁执行字节码指令跳转:
import timeit

# 测试样本:100 万个整数字符串
setup_data = 'items = [str(i) for i in range(1000000)]'

# 测试 1:list(map(int, items))
t_map = timeit.timeit('list(map(int, items))', setup=setup_data, number=10)

# 测试 2:[int(x) for x in items]
t_comp = timeit.timeit('[int(x) for x in items]', setup=setup_data, number=10)

print(f"map + 内置函数平均耗时: {t_map / 10:.4f} 秒")
print(f"推导式 + 内置函数平均耗时: {t_comp / 10:.4f} 秒")
# 典型表现:map 耗时通常比推导式少 15% ~ 25%
2. 为什么 map 搭配 lambda 显著变慢?
一旦给 map() 传入 lambda 匿名函数,情况便彻底逆转。每次迭代时,Python 虚拟机都必须为该 lambda 创建一个标准的函数调用栈帧(Frame),引发 CALL_FUNCTION 字节码开销;而在列表推导式中,表达式是直接作为局部指令在当前作用域内计算并立即附加到列表中,没有任何额外的调用栈帧开销。
# 测试样本:100 万个浮点数
setup_calc = 'nums = [float(i) for i in range(1000000)]'

# 测试 1:list(map(lambda x: x * 1.5 + 2, nums))
t_map_lambda = timeit.timeit('list(map(lambda x: x * 1.5 + 2, nums))', setup=setup_calc, number=10)

# 测试 2:[x * 1.5 + 2 for x in nums]
t_comp_direct = timeit.timeit('[x * 1.5 + 2 for x in nums]', setup=setup_calc, number=10)

print(f"map + lambda 平均耗时: {t_map_lambda / 10:.4f} 秒")
print(f"推导式内联计算平均耗时: {t_comp_direct / 10:.4f} 秒")
# 典型表现:推导式速度通常比 map + lambda 快 30% ~ 50%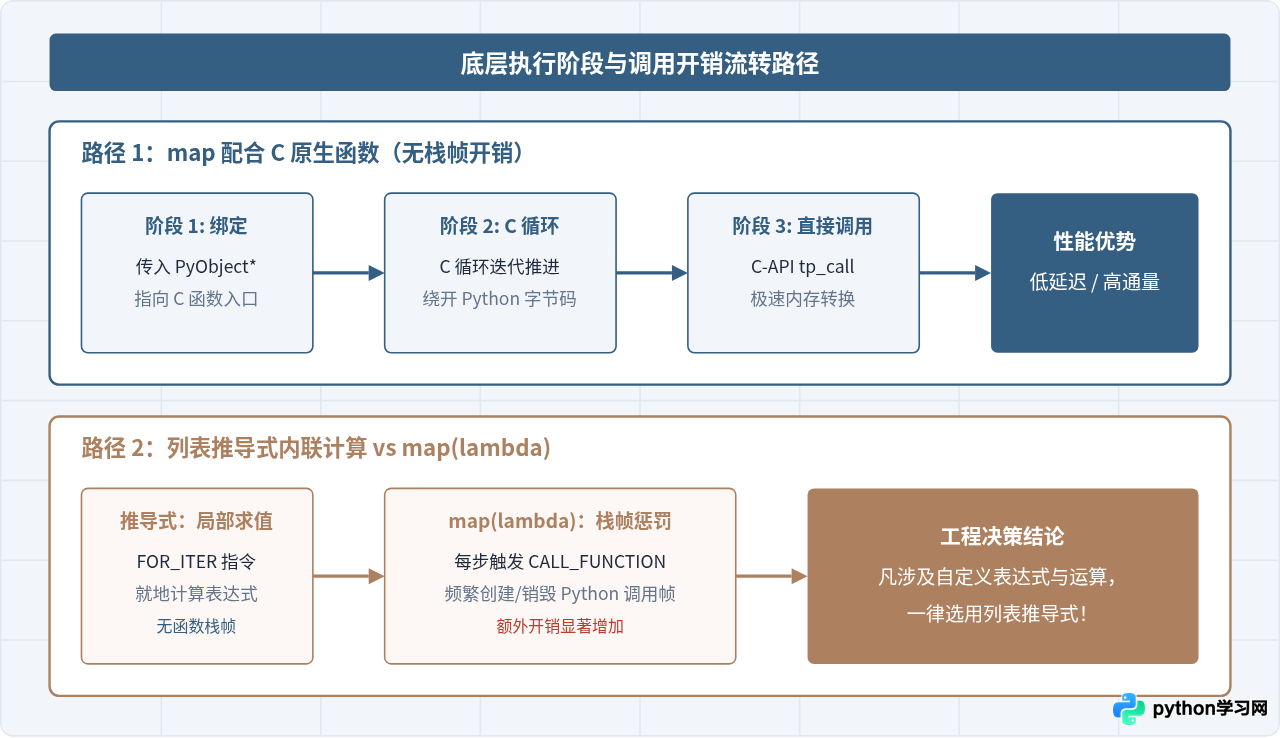
四、关键差异与场景选型决策依据
为了帮助在实际业务场景中做出准确决策,我们先将两者的核心指标归纳如下:
| 比较维度 | map 函数 | 列表推导式 |
|---|---|---|
| 返回值类型 | map 迭代器对象(惰性求值) |
完整的 list 列表对象(即时求值) |
| 内存占用 | 常数级别 \(O(1)\),与元素总量无关 | 线性级别 \(O(N)\),随数据量成正比增长 |
| 语法与可读性 | 调用已有函数简洁;配合 lambda 时冗长晦涩 | 语法贴近自然语言,结构直观清晰 |
| 条件筛选支持 | 无原生条件语法,需嵌套 filter() |
原生支持 if condition 过滤子句 |
| 多序列并行 | 天然支持传入多个可迭代对象并行处理 | 需要搭配 zip() 函数实现多序列遍历 |
| 复用与二次消费 | 单次迭代后即耗尽,不可二次读取 | 完整列表常驻内存,支持索引、切片与重复遍历 |
1. 适宜选用 map 的典型场景
-
已有高效内置函数或公共转换器:
# 数据清洗:快速剥离一组字符串的前后空格 raw_words = [" apple\n", " banana ", "\torange "] cleaned_words = map(str.strip, raw_words) -
多个等长可迭代对象的并行逐项聚合:
map可以直接接收多个可迭代对象作为参数,按序提取传给函数,省去了显式zip的步骤:# 并行相加两组向量 vector_a = [1, 2, 3, 4] vector_b = [10, 20, 30, 40] # map 可以直接接收多个参数 vector_sum = map(lambda x, y: x + y, vector_a, vector_b) # 或配合 operator.add(无 lambda 开销): import operator vector_sum_fast = map(operator.add, vector_a, vector_b) - 超大数据流或生成器管道处理: 当处理几千万条日志记录或读取大文件时,返回迭代器可以接入后续生成器管道,保持内存占用处于几十字节水平。
2. 适宜选用列表推导式的典型场景
-
需要对元素进行过滤筛选(Filter + Map):
若用函数式方式,需要编写
map(func, filter(pred, data)),代码由内向外阅读,认知负荷大;推导式则由左至右一气呵成:scores = [85, 42, 91, 58, 76, 33] # 列表推导式:过滤出及格者并打八折 passed_discounted = [score * 0.8 for score in scores if score >= 60] -
自定义运算与属性访问表达式:
# 直接访问对象属性或进行算术组合 user_names = [user.profile.full_name.upper() for user in user_list] -
业务后续明确需要多次使用该列表:
由于
map产生的是单次迭代器,如果后续需要通过下标result[0]访问、获取长度len(result)或进行二次循环,推导式生成的列表无需二次转换。
五、实际开发中的注意事项与避坑指南
在工程实践中,不恰当的用法不仅无法带来性能提升,还会引发隐蔽的 Bug。以下是必须注意的三个关键问题:
初学者最容易踩的坑是将
map 当作持久容器使用。当 map 对象被迭代完毕后,其内部指针已到达末尾,再次对其循环或执行 sum() 等操作将返回空值:
squares = map(int, ["1", "2", "3"])

print(list(squares))  # 正常输出: [1, 2, 3]
print(list(squares)) # 输出: [] (迭代器已耗尽,无法再次消费)list(map(...))。
在代码评审中,类似
list(map(lambda x: x.split(",")[0].lower(), data)) 的写法极为常见。这种代码同时引入了函数式包裹与匿名函数,既失去了 map 惰性求值的内存优势,又丧失了 C 层函数的执行速度优势,可读性远低于 [x.split(",")[0].lower() for x in data]。在任何需要 lambda 的场景中,列表推导式都是更优的选项。
如果既需要列表推导式优雅直观的
if 过滤与自定义表达式语法,又希望像 map 那样获得惰性求值与低内存开销,可以使用生成器表达式——只需将外层的方括号 [] 替换为圆括号 ():
# 生成器表达式:兼具列表推导式的直观语法与 map 的惰性求值特性
large_stream = (x ** 2 for x in range(10000000) if x % 2 == 0)

# 在后续流程中按需迭代,内存始终保持恒定常数级
first_val = next(large_stream)本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















