


怎么用Python内置函数map、filter和zip简化代码逻辑
深入讲解如何使用Python内置函数map、filter和zip简化数据转换、筛选与序列聚合逻辑,通过实际代码对比与流程图解,提升代码执行效率与可读性。
在日常的 Python 编程中,处理列表、元组等集合数据是最频繁的操作。许多开发者习惯直接写 for 循环并在循环体外部声明空列表,通过不断调用 .append() 来完成数据提取、筛选与重组。虽然这种写法直观,但当逻辑交织时,样板代码和中间变量会迅速膨胀,增加维护成本。Python 内置的 map()、filter() 和 zip() 函数提供了高内聚的声明式处理能力,配合迭代器的惰性求值特性,能够在不占用额外内存的前提下,将多层循环精简为语义清晰的单行调用。
一、使用 map() 简化数据批量转换
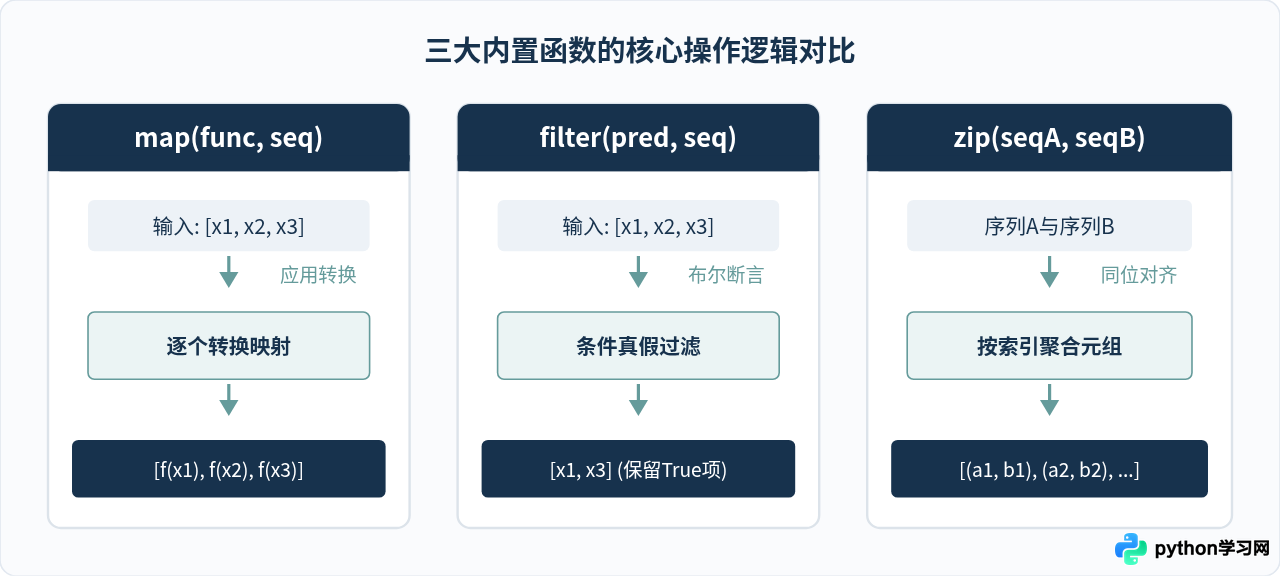
map() 的语法结构为 map(function, iterable, ...)。它的核心职责是把传入的函数依次作用到可迭代对象的每一个元素上,并返回一个生成结果的迭代器。
1. 消除类型转换循环
读取外部输入或日志文件时,数值通常以字符串形式呈现。如果要把一组字符串格式的数字转为整型,传统写法往往需要新建列表并通过循环逐一调用 int():
# 传统循环写法
raw_ids = ["1001", "1002", "1003", "1004"]
user_ids = []
for item in raw_ids:
    user_ids.append(int(item))

# 使用 map 简化
user_ids = list(map(int, raw_ids))
# 示例输出: [1001, 1002, 1003, 1004]
直接将内置类型转换器 int 作为函数参数传递,既省去了循环变量的命名负担,也避免了解释器在循环中频繁查找并调用 append 方法的开销。
2. 并行处理多个可迭代对象
map() 还支持接收多个可迭代对象。此时传入的函数必须接收相应数量的参数。map() 会在每次迭代时分别从各个序列取出一个元素传入函数,当最短的序列耗尽时迭代结束:
bases = [10, 20, 30]
powers = [1, 2, 3]

# pow(x, y) 依次计算 10^1, 20^2, 30^3
results = list(map(pow, bases, powers))
# 示例输出: [10, 400, 27000]
二、使用 filter() 精简条件筛选逻辑
filter() 的签名是 filter(function, iterable)。它通过指定的断言函数(返回 True 或 False 的函数)对序列中的元素进行判定,仅保留返回值为真值的元素。
1. 替代多分支的 if 过滤循环
在筛选特定业务对象(例如提取偶数或合规记录)时,传统写法需要在 for 内部嵌套 if 语句:
scores = [88, 52, 95, 60, 45, 78]

# 传统过滤写法
passed = []
for score in scores:
    if score >= 60:
        passed.append(score)

# 使用 filter 简化
passed = list(filter(lambda s: s >= 60, scores))
# 示例输出: [88, 95, 60, 78]
2. 快速清理空值与无效数据
当 filter() 的第一个参数传入 None 时,它会自动采用 Python 对象的真值检测规则(Truth Value Testing),自动剔除 None、空字符串 ""、数字 0 以及空集合等“假值”:
raw_tags = ["python", "", None, "backend", "   ", "api"]

# 去除空白与无效假值(结合 strip)
cleaned_tags = list(filter(None, map(str.strip, filter(None, raw_tags))))
# 示例输出: ['python', 'backend', 'api']
三、使用 zip() 实现多序列同步对齐与重构
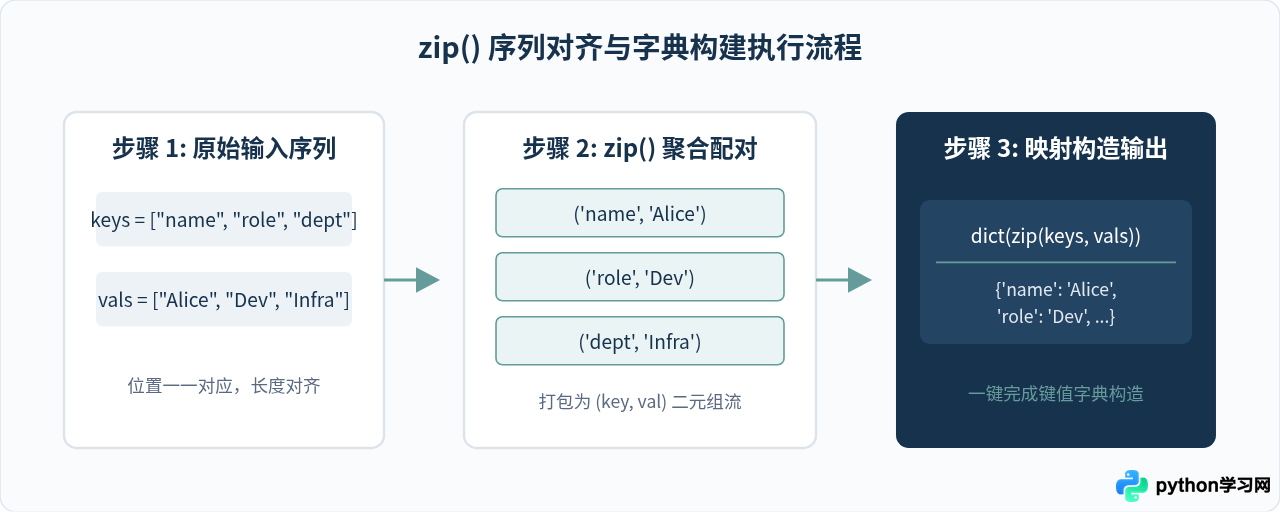
在处理表格式数据或分离的字段列表时,我们经常需要把来自不同列表但位置相同的元素组合在一起。zip(*iterables) 会并行遍历所有输入序列,每次产出一个包含各序列同位置元素的元组。
1. 快速构建字典与并行迭代
最常用的技巧是搭配 dict() 将两个一维列表直接拼接成字典,摆脱下标索引 i 的束缚:
fields = ["username", "email", "level"]
values = ["alex_99", "alex@example.com", "vip"]

# 传统索引循环
user_profile = {}
for i in range(len(fields)):
    user_profile[fields[i]] = values[i]

# 使用 zip 简化
user_profile = dict(zip(fields, values))
# 示例输出: {'username': 'alex_99', 'email': 'alex@example.com', 'level': 'vip'}
2. 二维矩阵转置(行列互换)
结合参数解包操作符 *,zip() 可以在一行内实现二维矩阵的行列反转,免去双重嵌套循环的繁琐逻辑:
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]

# 行列转置
transposed = [list(row) for row in zip(*matrix)]
# 示例输出: [[1, 4, 7], [2, 5, 8], [3, 6, 9]]
四、协同应用:构建声明式数据处理流水线
当需要从多组数据源中对齐字段、清洗转换并按规则筛选时,单靠某一个函数往往不够。将 zip、map 与 filter 串联起来,能形成类似管道(Pipeline)的数据流,彻底消除中间状态列表。
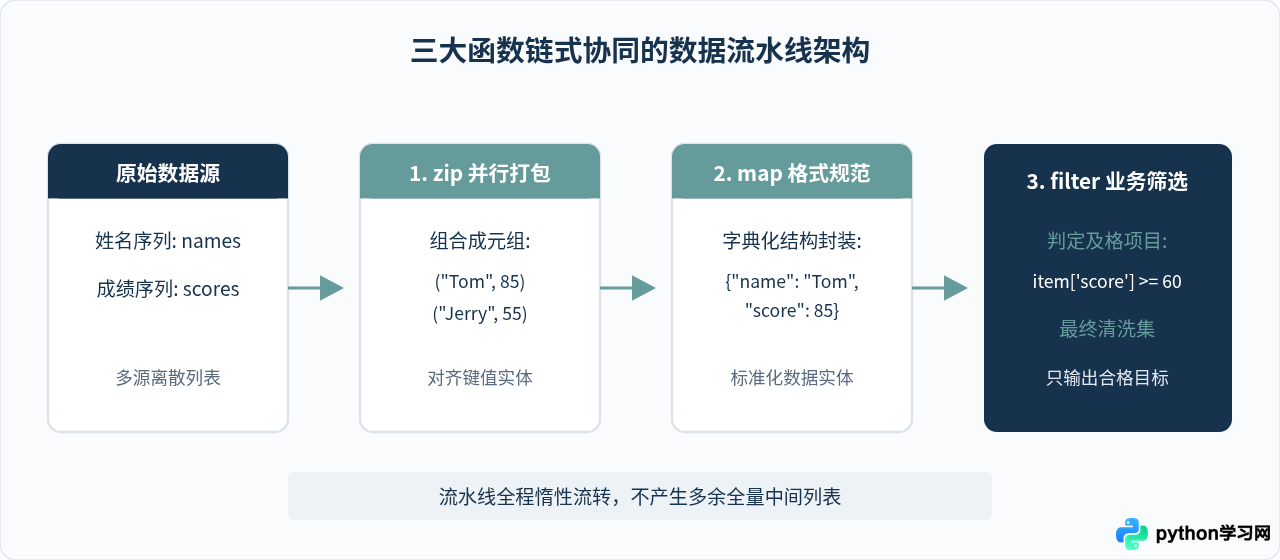
考虑以下需求:有两个平行列表分别存储考生姓名和各科总分,需要将它们打包成标准字典,并且只保留总分在 80 分以上的“优秀”记录:
names = ["张伟", "李强", "王芳", "赵敏"]
scores = [76, 92, 85, 68]

# 组合式流处理
qualified = list(
    filter(
        lambda item: item["score"] >= 80,
        map(lambda pair: {"name": pair[0], "score": pair[1]}, zip(names, scores))
    )
)

# 示例输出:
# [{'name': '李强', 'score': 92}, {'name': '王芳', 'score': 85}]
整段处理从头至尾无需显式使用任何临时循环索引,逻辑的意图(先对齐、再映射封装、后条件过滤)自内向外层层递进,结构极为紧凑。
五、选型决策与边界注意事项
虽然 map、filter 和 zip 能够有效精简代码,但在实际工程中,不能盲目替代一切循环。理解它们的底层特性和适用边界,是写出健壮代码的前提。
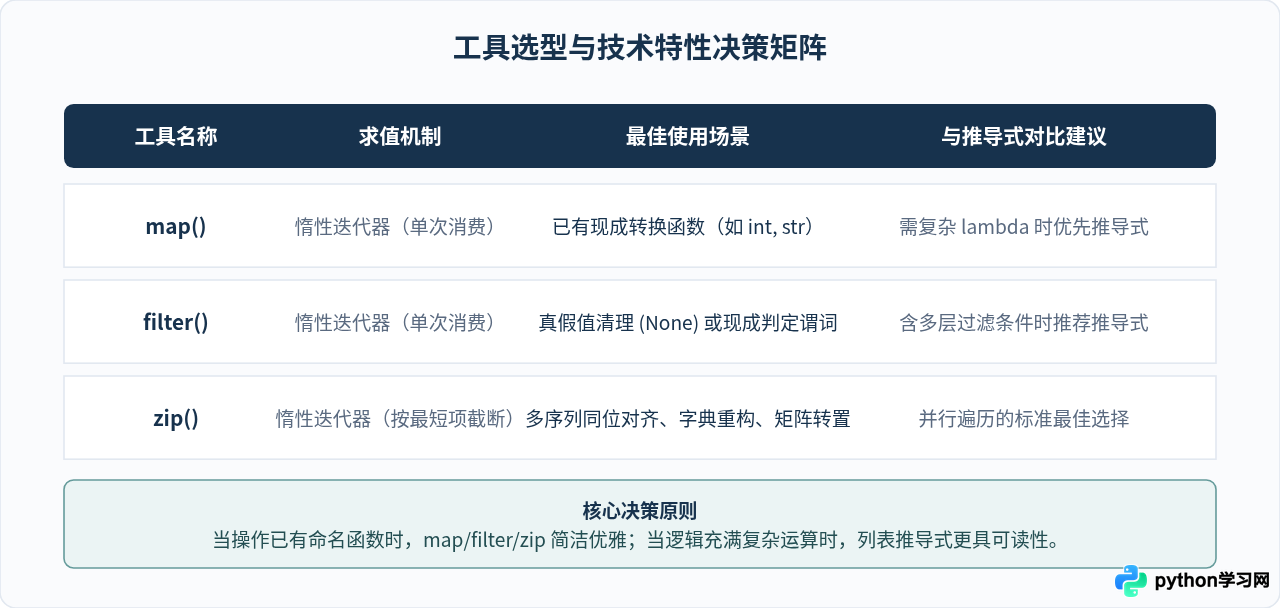
关键避坑点提醒:
- 迭代器单次耗尽:在 Python 3 中,这三个函数返回的都是迭代器而非列表。迭代器被遍历一次后就会变空。如果需要多次使用计算结果,必须显式用
list()或tuple()进行固化。 - zip 的短板截断:当传入的序列长度不一致时,
zip()会默认在最短的序列结束时停止。如果需要以最长序列为基准并为缺失项填充默认值,应使用标准库中的itertools.zip_longest(),避免数据被静默吞没。 - 避免过度嵌套 lambda:如果数据转换逻辑复杂(超过一行表达式),强行在
map或filter内部塞入多重三元表达式或复杂lambda反而会损害可读性。此时拆分为普通具名函数或改用列表推导式是更稳妥的选择。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















