


Python探索性数据分析(EDA)怎么做?关键统计指标与分布检查

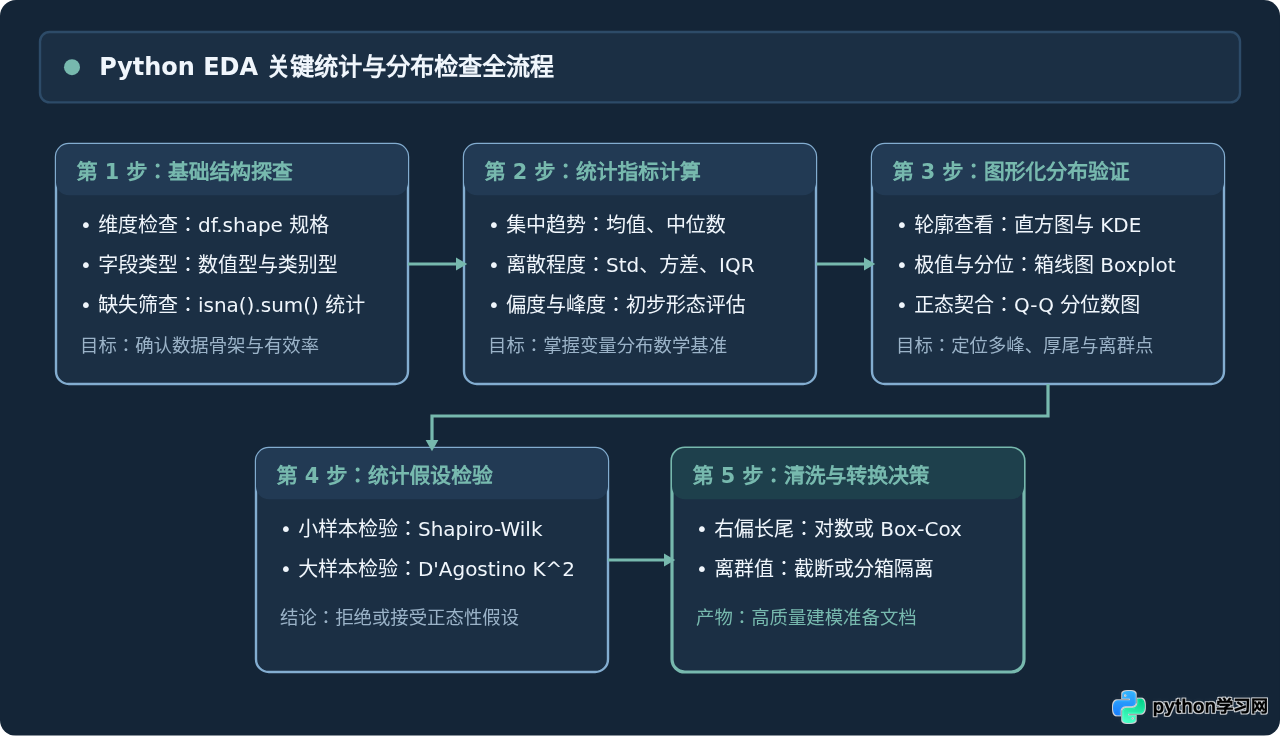
假设你刚从业务系统中导出一份含有数十万条记录的用户交易日志 CSV 文件,如果直接把这批数据丢给回归或分类模型,很可能会遭遇训练发散、预测失真或模型对极值极其敏感的问题。探索性数据分析(Exploratory Data Analysis,简称 EDA)的核心目的,就是通过系统的描述性统计指标与图形化分布检查,在建模前彻底摸清数据的集中趋势、离散范围、偏斜形态以及潜在的异常干扰,从而为后续的数据清洗、特征转换与算法选择提供可靠的客观依据。
一、准备工作:搭建分析环境与数据初检
进行数据探索分析时,Python 生态中最基础且高效的依赖库包含 pandas、numpy、scipy 以及可视化库 matplotlib 与 seaborn。推荐在标准的 Python 3.9+ 虚拟环境中安装这些工具:
pip install pandas numpy scipy matplotlib seaborn拿到数据集后的第一步是执行宏观结构检查,查验数据行列数、各列字段的数据类型以及缺失值覆盖率,避免在非数值型字段上强行执行统计运算。
import pandas as pd
import numpy as np

# 模拟构建一个具有实际特征的电商用户交易样本数据集
np.random.seed(42)
n_samples = 1000

data = {
    "user_id": np.arange(1001, 1001 + n_samples),
    # 右偏长尾分布:大部分订单金额在 50~200 之间,少数大客单价超 2000
    "order_amount": np.round(np.random.exponential(scale=120, size=n_samples) + 20, 2),
    # 近似正态分布:用户活跃天数
    "active_days": np.clip(np.round(np.random.normal(loc=45, scale=12, size=n_samples)), 1, 90),
    # 含有离群值的转化率得分
    "score": np.random.uniform(10, 95, size=n_samples)
}

df = pd.DataFrame(data)

# 基础结构探查
print("数据集形状 (行, 列):", df.shape)
print("\n缺失值统计:\n", df.isna().sum())
print("\n数据类型概览:\n", df.dtypes)二、核心统计指标体系与数学解读
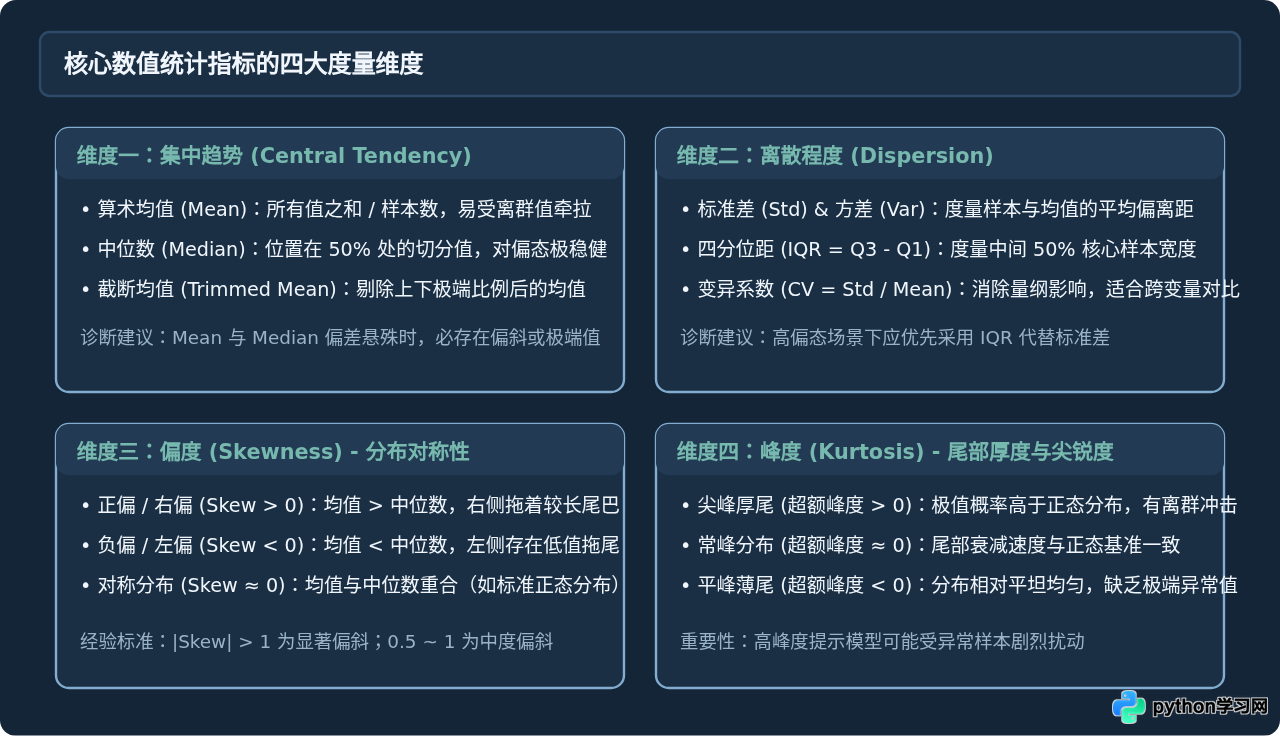
单一统计值往往具有很强的欺骗性。例如,仅仅观察一组薪资数据的均值,往往会因为几位超高收入者而严重高估普遍水平。因此,必须将集中趋势、离散程度与形态指标(偏度、峰度)结合起来,形成完整的数值坐标系。
1. 关键指标的 Python 计算实操
利用 Pandas 和 SciPy,我们可以一次性输出全面的描述统计量,并编写自动化函数提取五数概括(最小值、下四分位数、中位数、上四分位数、最大值)以及偏度、峰度指标:
from scipy import stats

def calculate_distribution_metrics(series: pd.Series) -> pd.Series:
    """计算指定数值列的关键位置与形态统计指标"""
    q1 = series.quantile(0.25)
    q3 = series.quantile(0.75)
    iqr = q3 - q1

    metrics = {
        "样本总量": series.count(),
        "均值 (Mean)": series.mean(),
        "中位数 (Median)": series.median(),
        "标准差 (Std)": series.std(),
        "四分位距 (IQR)": iqr,
        "偏度 (Skewness)": series.skew(),
        "峰度 (Kurtosis)": series.kurtosis()  # pandas 默认计算 Fisher 超额峰度(正态分布为 0)
    }
    return pd.Series(metrics)

# 对比两组具有不同分布特征的变量
metrics_summary = pd.DataFrame({
    "订单金额 (order_amount)": calculate_distribution_metrics(df["order_amount"]),
    "活跃天数 (active_days)": calculate_distribution_metrics(df["active_days"])
})

print(metrics_summary.round(3))active_days 的均值(44.821)与中位数(45.000)高度重合,偏度为 0.038(非常接近 0),峰度为 -0.124,表现出极其标准的对称正态特征;而 order_amount 的均值(138.452)显著高于中位数(101.340),偏度达到 1.984,峰度达到 4.812,属于典型的强右偏且厚尾分布,存在长尾极端大额订单。三、分布检查工具的对比与图形化实现
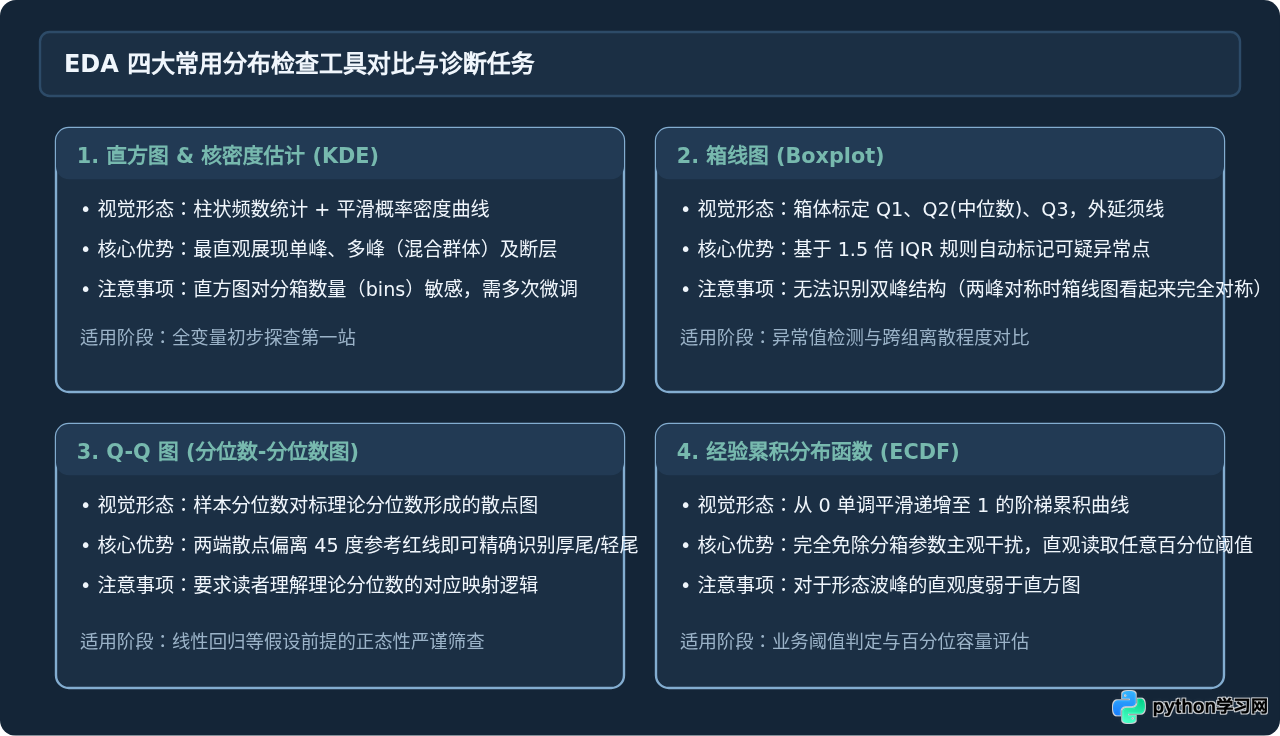
统计数字能给出量化轮廓,但无法完全还原细节。例如,当数据存在双峰(Bimodal)现象时,均值与中位数可能恰好落入两峰之间的波谷,仅看数字就会遗漏重要业务分群。因此必须结合分布图形进行校验。
2. 使用 Python 绘制分布检查组合图
在实际工程中,通常通过 matplotlib 和 seaborn 构建 2x2 的子图矩阵,将直方图+KDE、箱线图、Q-Q 图与 ECDF 放在同一画布中,全面排查目标特征:
import matplotlib.pyplot as plt
import seaborn as sns

def plot_distribution_diagnostics(series: pd.Series, feature_name: str):
    fig, axes = plt.subplots(2, 2, figsize=(12, 10))
    plt.subplots_adjust(hspace=0.3, wspace=0.25)

    # 1. 直方图 + KDE 曲线
    sns.histplot(series, kde=True, ax=axes[0, 0], color="#0f4c81", bins=30)
    axes[0, 0].set_title(f"{feature_name} - 直方图与核密度估计")
    axes[0, 0].set_ylabel("频数")

    # 2. 箱线图 (识别 1.5*IQR 离群点)
    sns.boxplot(x=series, ax=axes[0, 1], color="#77B9AE")
    axes[0, 1].set_title(f"{feature_name} - 箱线图")

    # 3. Q-Q 图 (检验正态性契合)
    stats.probplot(series, dist="norm", plot=axes[1, 0])
    axes[1, 0].set_title(f"{feature_name} - 正态 Q-Q 图")
    axes[1, 0].get_lines()[0].set_color("#0f4c81")
    axes[1, 0].get_lines()[1].set_color("#e11d48")  # 理论基准线标红

    # 4. ECDF 经验累积分布
    sns.ecdfplot(series, ax=axes[1, 1], color="#0f766e")
    axes[1, 1].set_title(f"{feature_name} - 经验累积分布 (ECDF)")
    axes[1, 1].set_ylabel("累计概率")
    axes[1, 1].grid(True, linestyle="--", alpha=0.5)

    plt.tight_layout()
    plt.show()

# 执行诊断绘图
plot_distribution_diagnostics(df["order_amount"], "订单金额")
四、统计假设检验:量化验证正态性
虽然图形能够给出明确的视觉倾向,但在许多科学分析或受到合规审计的业务中,我们需要用可量化的统计假设检验给出确定性结论。常用的正态性检验包括:
- Shapiro-Wilk 检验:在小样本量(如 $N < 2000$)时检验效力最强。
- D'Agostino's K-squared 检验:基于偏度和峰度联合构造统计量,在大样本下更为可靠。
# 执行统计检验验证假设
stat_sw, p_sw = stats.shapiro(df["active_days"])
stat_dag, p_dag = stats.normaltest(df["order_amount"])

print("【活跃天数 - Shapiro-Wilk 检验】")
print(f"统计量: {stat_sw:.4f}, p值: {p_sw:.4f}")
if p_sw > 0.05:
    print("判定结论: p > 0.05,无法拒绝原假设,数据服从正态分布。")
else:
    print("判定结论: p <= 0.05,拒绝原假设,数据显著偏离正态分布。")

print("\n【订单金额 - D'Agostino K^2 检验】")
print(f"统计量: {stat_dag:.4f}, p值: {p_dag:.4e}")
if p_dag > 0.05:
    print("判定结论: p > 0.05,无法拒绝原假设,数据服从正态分布。")
else:
print("判定结论: p <= 0.05,拒绝原假设,数据显著非正态。")五、根据分布检查结果推导数据工程决策
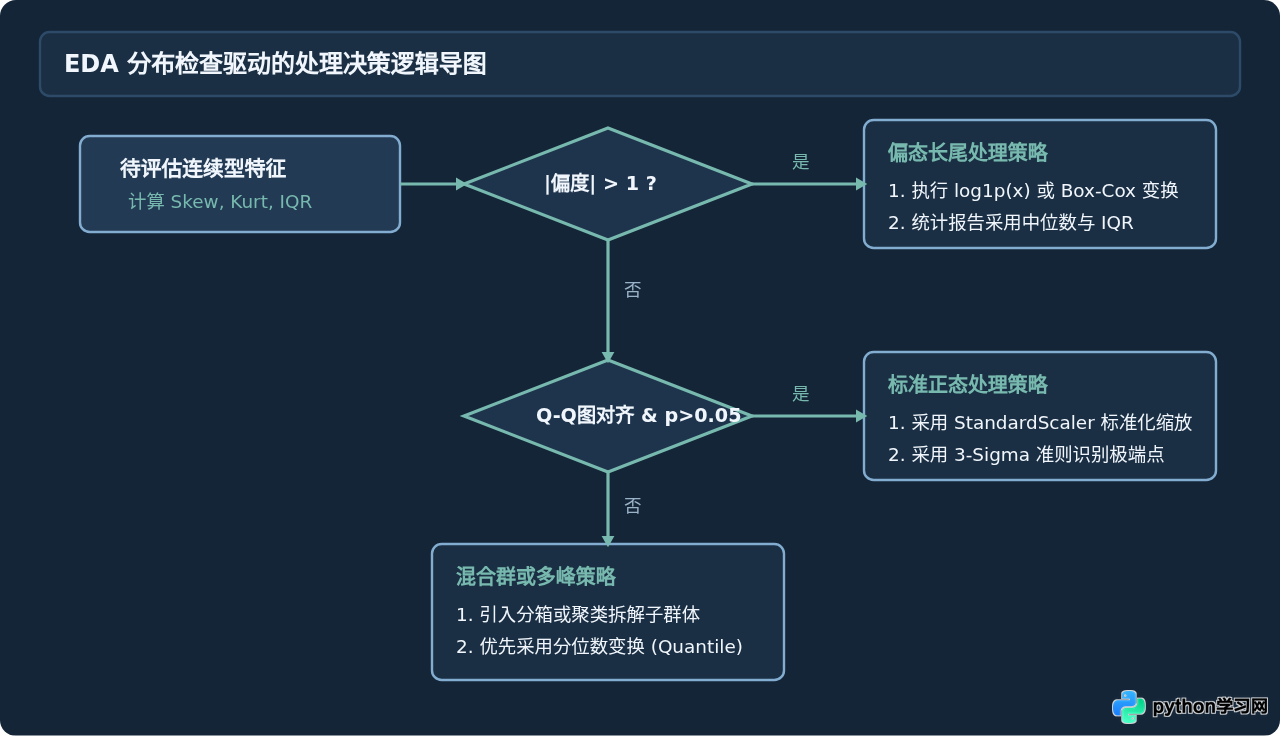
完成关键指标与分布检查之后,不能停留在“写出几张图”的阶段,而是要形成具体的技术处理闭环:
1. 针对右偏长尾数据的实际转换示例
对于如 order_amount 这类严重右偏特征,直接代入基于距离度量或线性可加性的算法(如 KNN、线性回归、神经元激活)通常表现欠佳。常见做法是对其进行对数变换(Log Transform):
# 执行对数平滑转换
df["order_amount_log"] = np.log1p(df["order_amount"])

print("转换前偏度:", round(df["order_amount"].skew(), 3))
print("转换后偏度:", round(df["order_amount_log"].skew(), 3))经过 log1p 变换后,偏度从 1.984 急剧下降至 0.125,原本拖拉的长尾被有效收敛,数据形态迅速接近对称正态分布。
六、EDA 实践中的高频陷阱与规避指南
| 常见陷阱 | 典型表现与风险 | 规范做法与应对方案 |
|---|---|---|
| 均值依赖陷阱 | 在强偏态分布中仅汇报平均数,导致业务评估严重偏离大众真实情况。 | 在计算均值的同时必须并行汇报中位数与 IQR;当两者差距过大时,以中位数作为代表值。 |
| 离群点草率删除 | 将所有超出箱线图须线的点当作错误数据全部过滤,丢失重要的核心业务事件(如大促巨额消费、设备故障信号)。 | 区分“数据录入错误”与“真实极端业务表现”。对真实极端值采用盖帽处理(Winsorization)或分桶,而非直接物理删除。 |
| 直方图分箱过粗/过细 | 分箱(bins)设为 5 导致所有结构被抹平;分箱设为 200 导致产生大量锯齿伪波峰。 | 结合 Freedman-Diaconis 经验法则确定分箱宽度:$\text{bin width} = 2 \times \text{IQR} \times n^{-1/3}$,并叠加平滑 KDE 曲线。 |
| 忽视大样本检验灵敏度 | 当样本量达到十万级别时,微弱的不规则波动就会使检验 p 值趋近于 0,机械判定为“非正态”。 | 在大数据量场景下以 Q-Q 图偏离程度与偏度绝对值为主观核心依据,假设检验结果仅作参考。 |
shape 与 isna 锁定边界,接着计算均值、中位数、IQR、偏度与峰度构建量化基准,随后运用直方图、箱线图、Q-Q 图与 ECDF 排查分布细节与异常,最终得出该特征应该“对数平滑”、“稳健缩放”还是“拆解分群”的工程决策。建立起这套标准流程后,你便能在面对任意陌生数据集时,从容高效地推进建模准备。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















