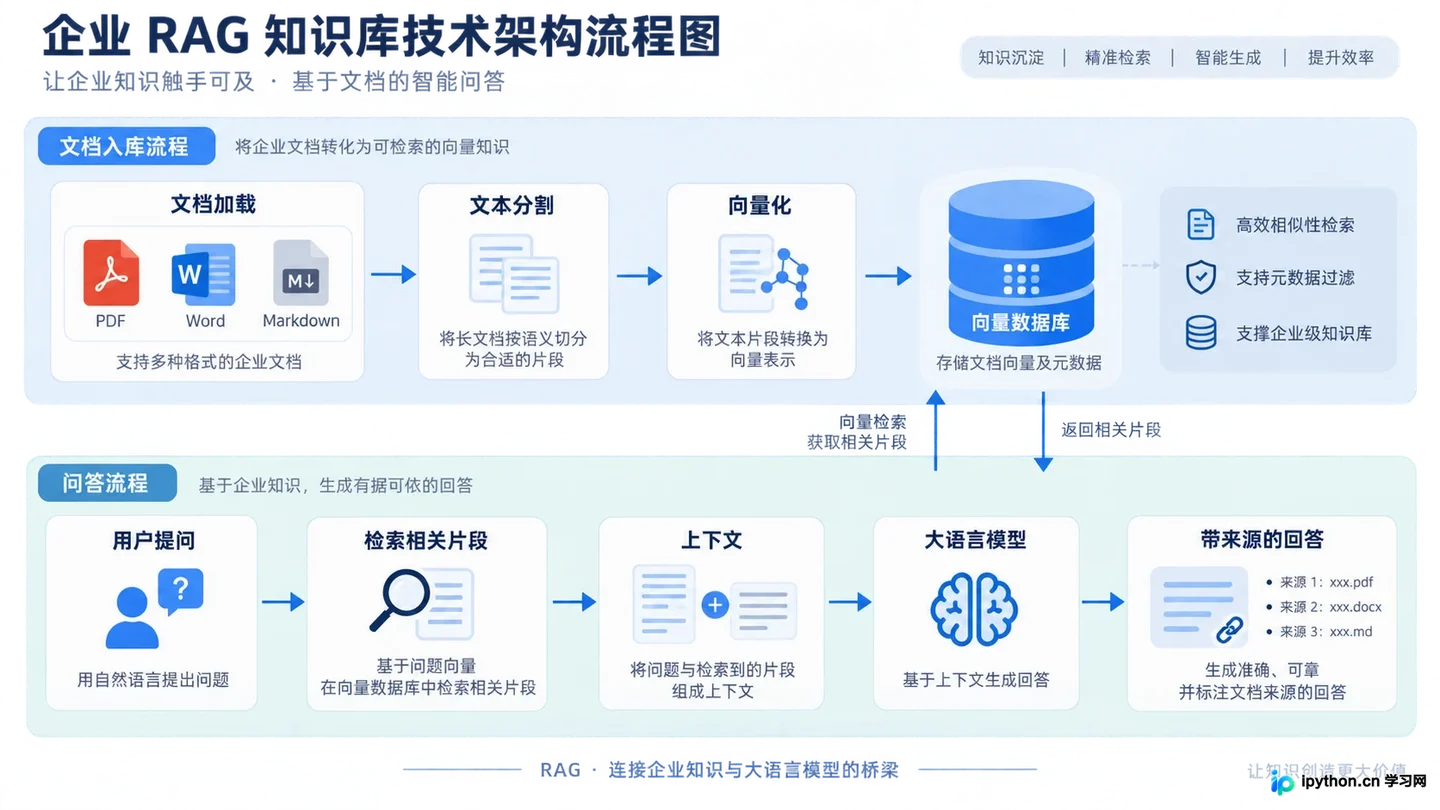
提升RAG检索准确率的5个策略:从分块优化到重排序
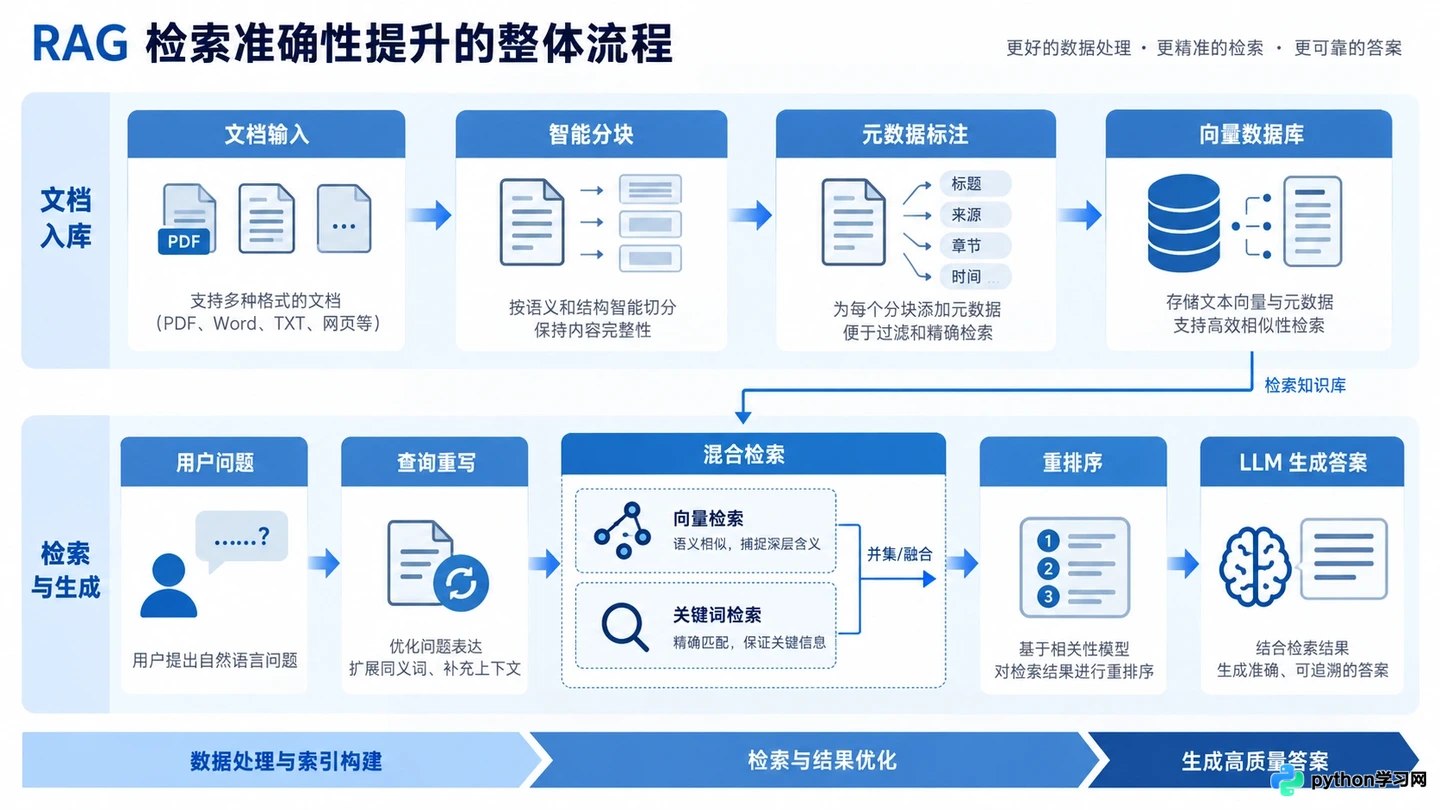
本文介绍优化RAG系统检索效果的五个关键设置策略,包括智能分块、元数据过滤、查询重写、混合检索及重排序,旨在帮助开发者提升生成质量与回答准确性。
10-23
26




本文介绍优化RAG系统检索效果的五个关键设置策略,包括智能分块、元数据过滤、查询重写、混合检索及重排序,旨在帮助开发者提升生成质量与回答准确性。
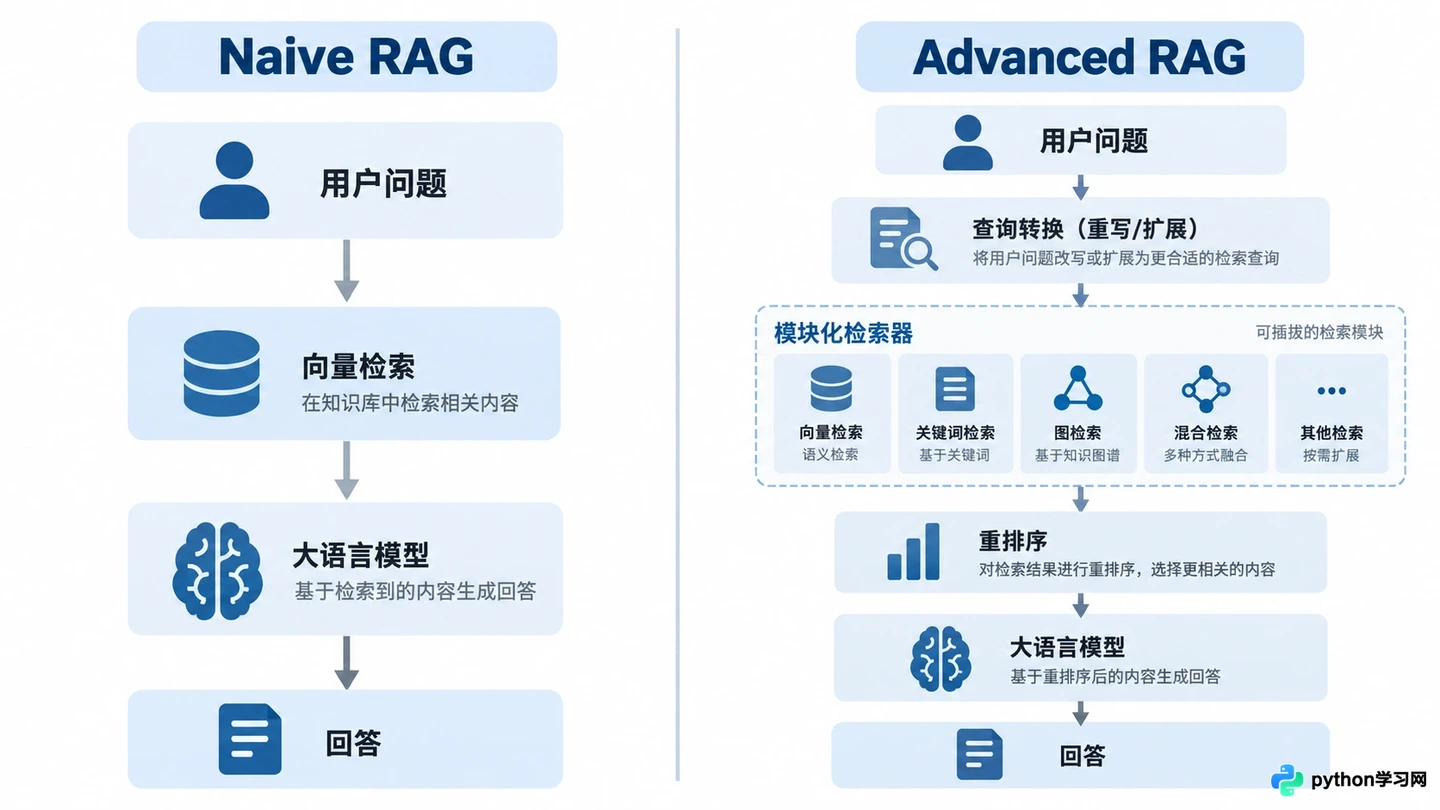
本文详解如何从基础的Naive RAG架构升级至Advanced RAG,重点介绍模块化检索组件的构建与查询转换(Query Transformation)技术的实现方法,通过具体代码示例展示优化检索效果的关键步骤。
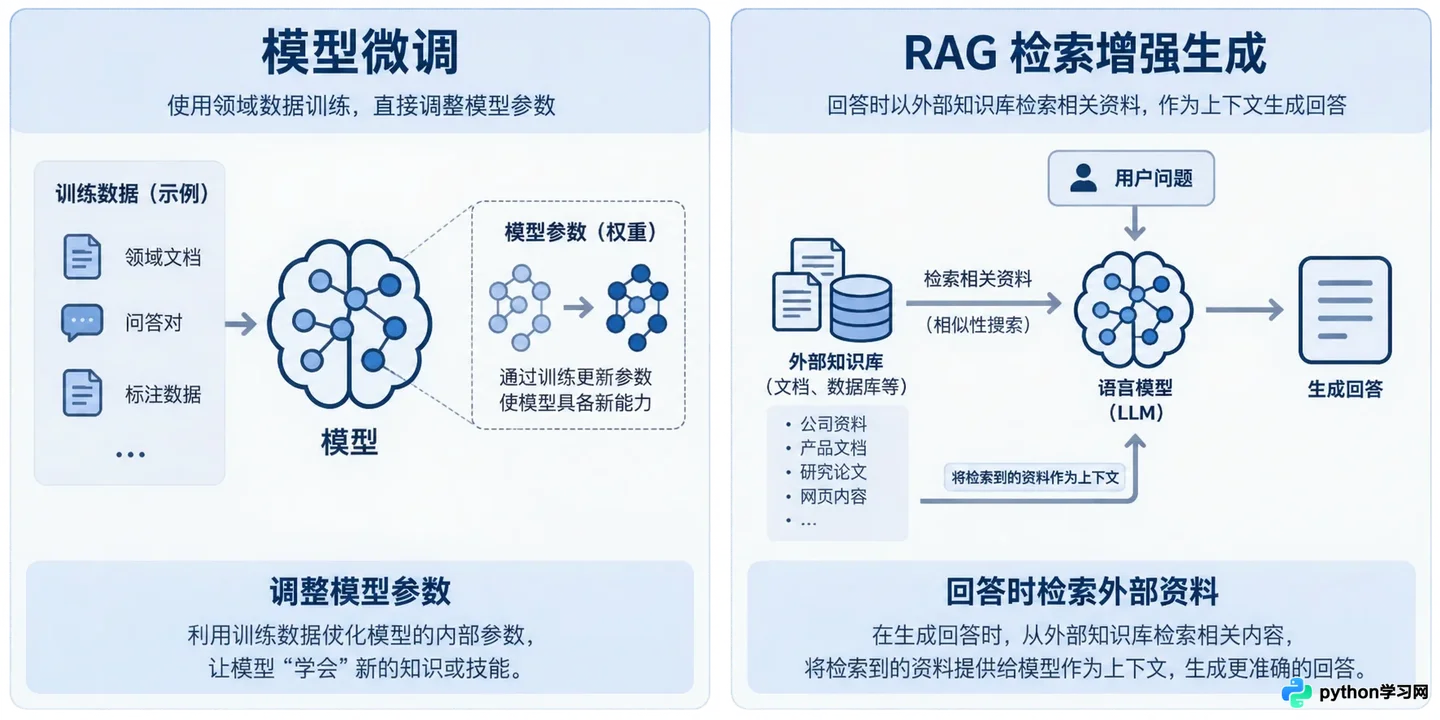
本文通过对比检索增强生成(RAG)与模型微调(Fine-tuning)的核心机制、适用场景及成本结构,帮助企业在构建AI应用时做出准确的技术选型决策,避免盲目投入。
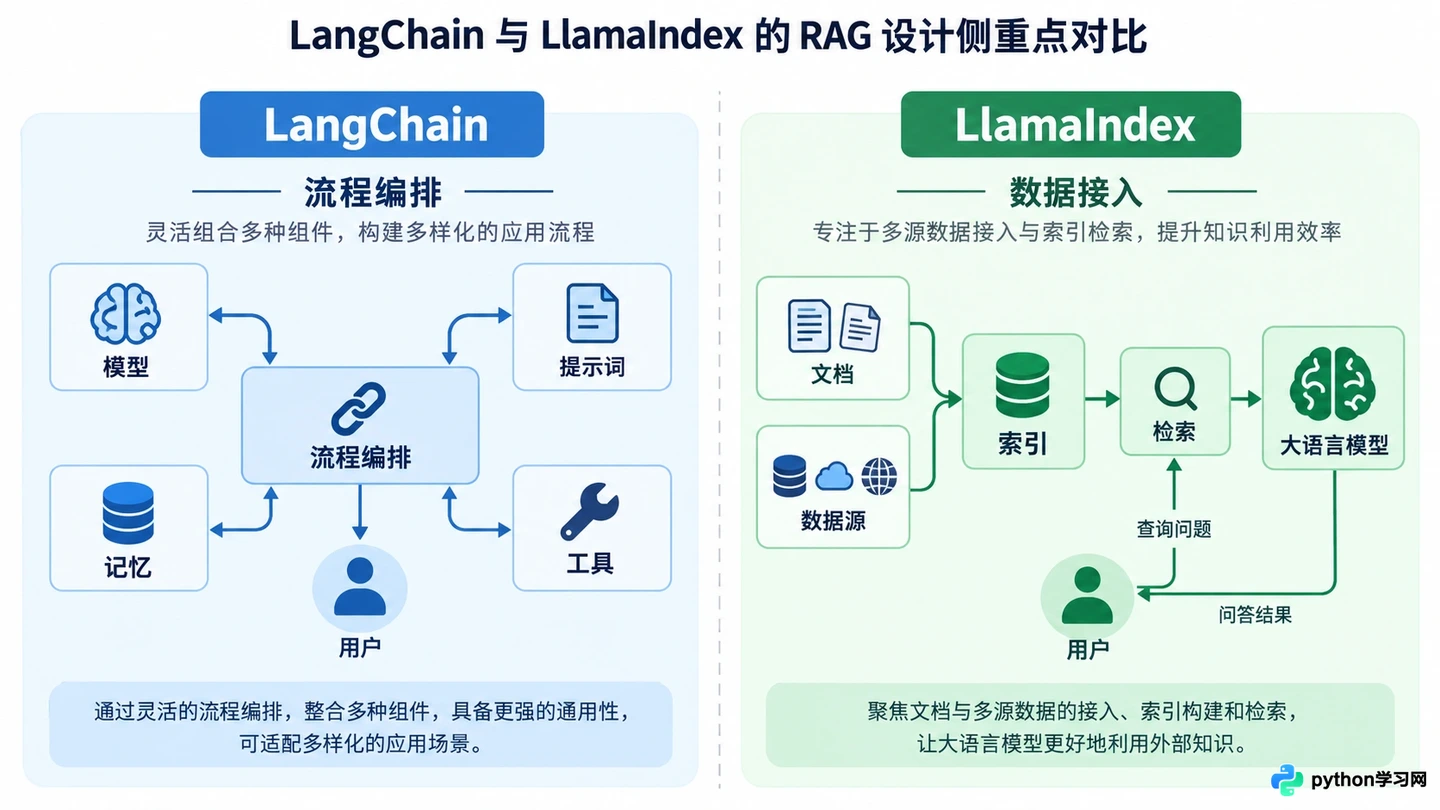
本文对比LangChain和LlamaIndex两大RAG开发框架,从架构设计、数据索引能力、查询引擎及适用场景四个维度进行分析,帮助开发者根据项目需求选择最适合的工具栈。
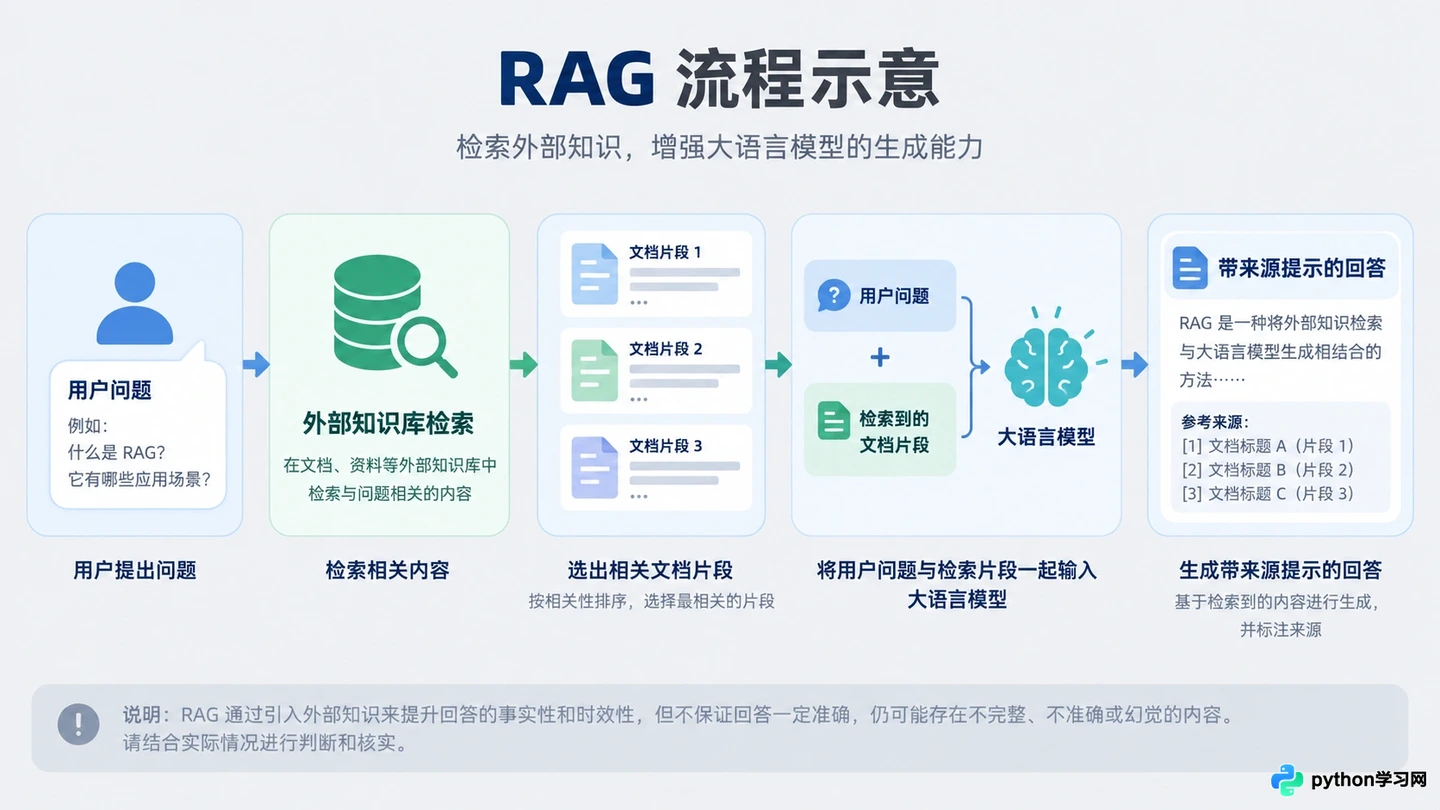
本文用通俗语言解释RAG(检索增强生成)技术的基本原理,说明它如何通过引入外部知识库来减少大模型的“胡编乱造”,并列举了适合使用RAG的典型场景与实施要点。
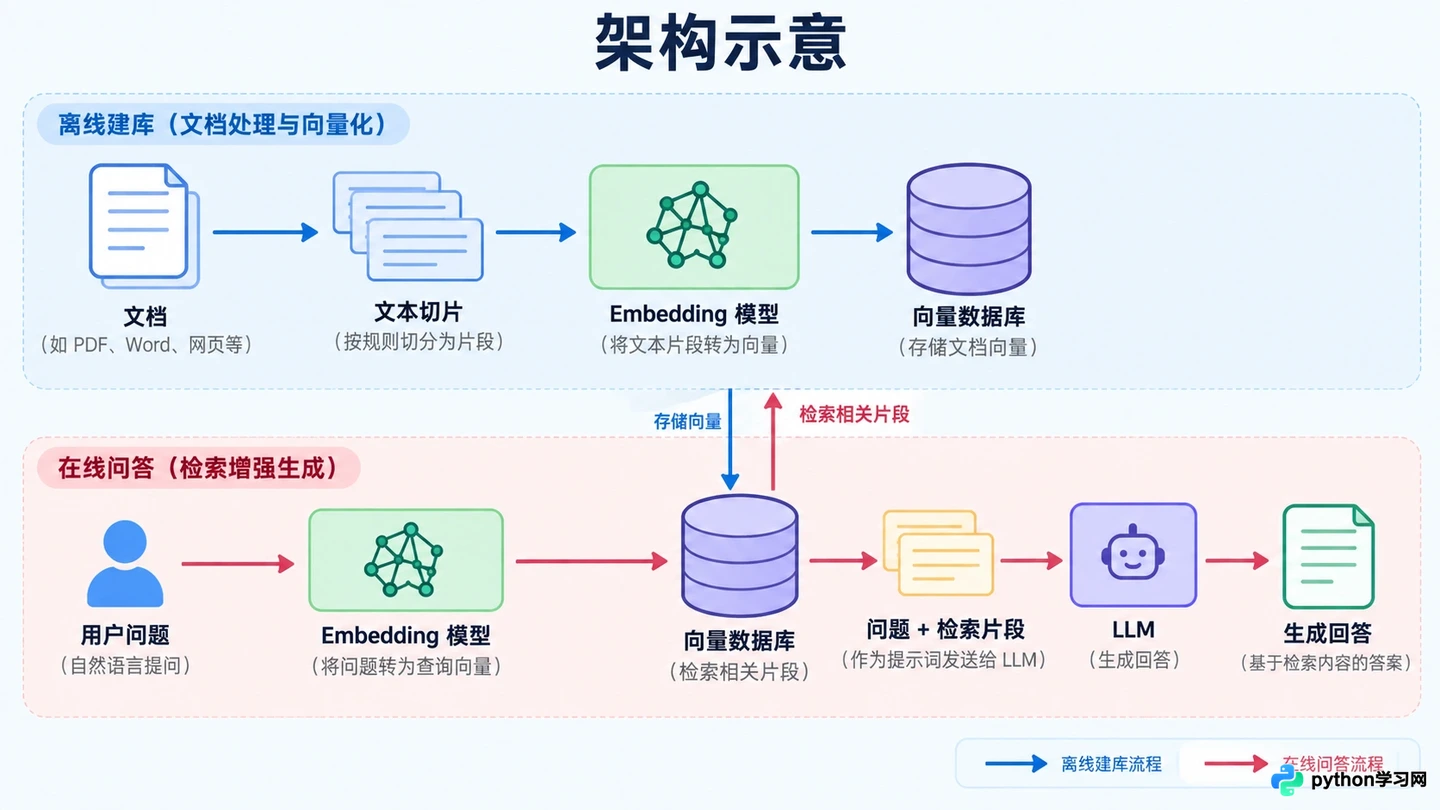
本文通过实操视角解析RAG系统的核心工作流,重点展示Embedding模型如何将文本转化为向量、向量数据库如何进行相似度检索,以及大语言模型如何结合检索结果生成最终答案。旨在帮助开发者理解各组件间的协作机制,避免将RAG视为黑盒。
本文通过具体场景解析检索增强生成(RAG)技术如何解决企业知识库更新滞后和智能客服幻觉问题,展示其在提升信息准确性和响应效率方面的实际落地效果。