


提升RAG检索准确率的5个策略:从分块优化到重排序

在构建检索增强生成(RAG)系统时,许多开发者会发现,仅仅将文档切片并存入向量数据库并不能保证高质量的回答。检索阶段的噪声往往直接导致大模型产生幻觉或遗漏关键信息。优化RAG的核心不在于更换更强大的语言模型,而在于精细化调整检索链路的每一个环节。通过调整分块策略、引入元数据、优化查询表达以及改进排序机制,可以显著提升最终生成的准确性。
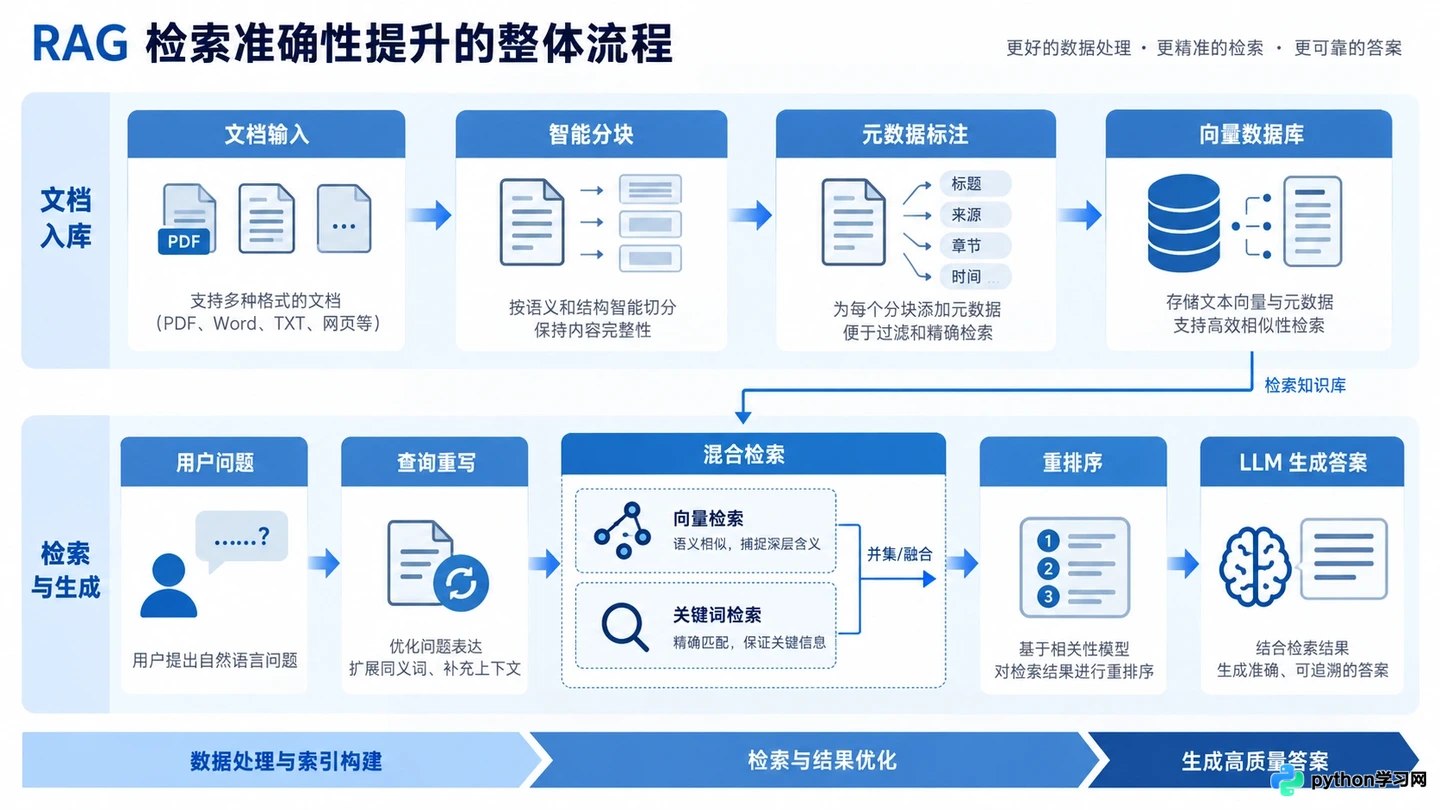
RAG系统从数据预处理到生成输出的完整优化链路示意图
关于智能分块策略
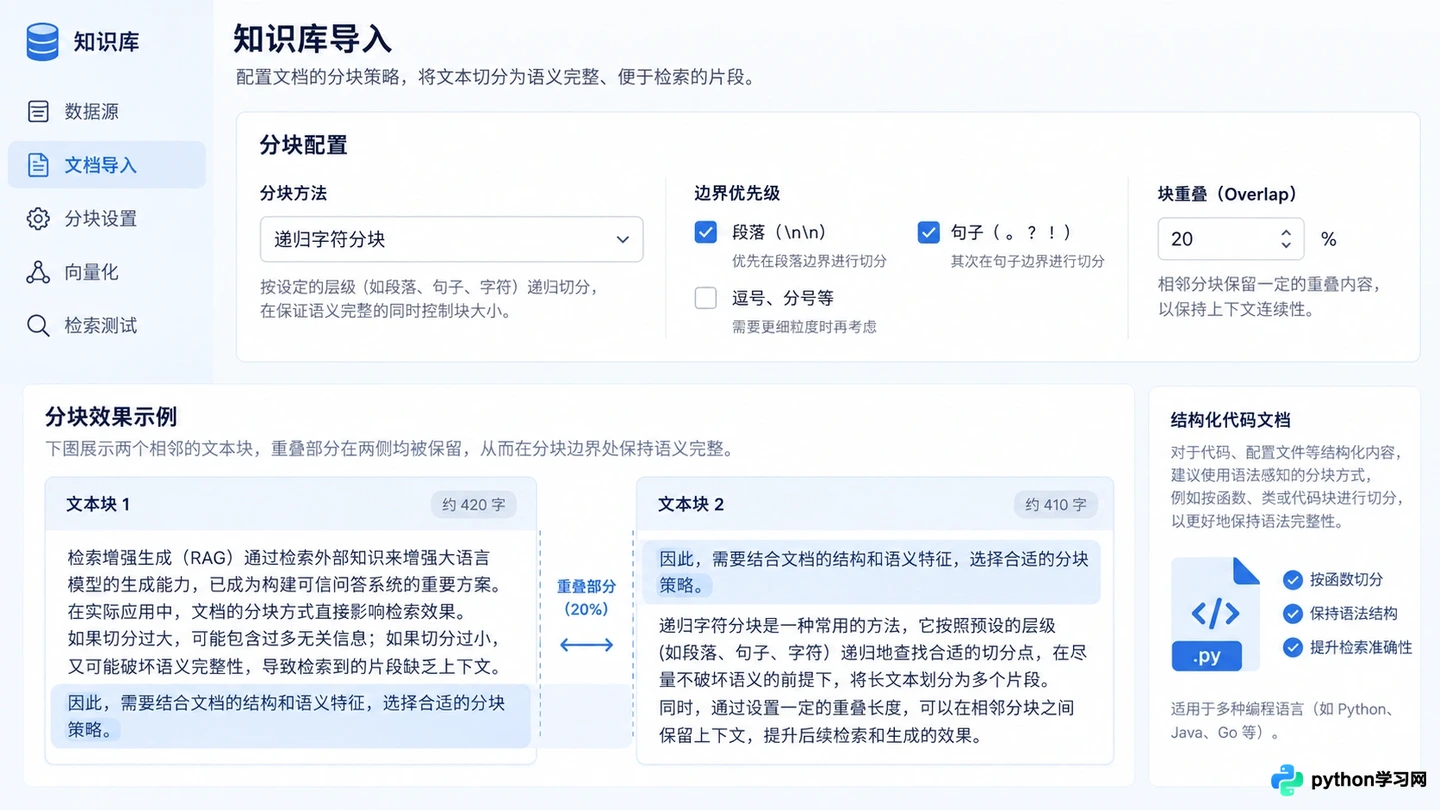
传统的固定字符数分块容易切断语义完整的句子或段落,导致检索到的片段缺乏上下文。优化分块的首要任务是保持语义的连贯性。基于递归字符的分块方法能够优先在自然边界如句号、段落结束处进行切割,从而保留更多的语境信息。
除了基础的分块算法,重叠窗口设置至关重要。在相邻的数据块之间保留一定比例的重复内容,可以确保处于边界的关键词不被遗漏。例如,设置20%的重叠率意味着前一个块的尾部会出现在后一个块的头部,这增加了检索命中的概率。对于代码或结构化文档,应采用基于语法树或特定标记的分块方式,以确保逻辑单元的完整性。
关于智能分块策略
关于元数据过滤
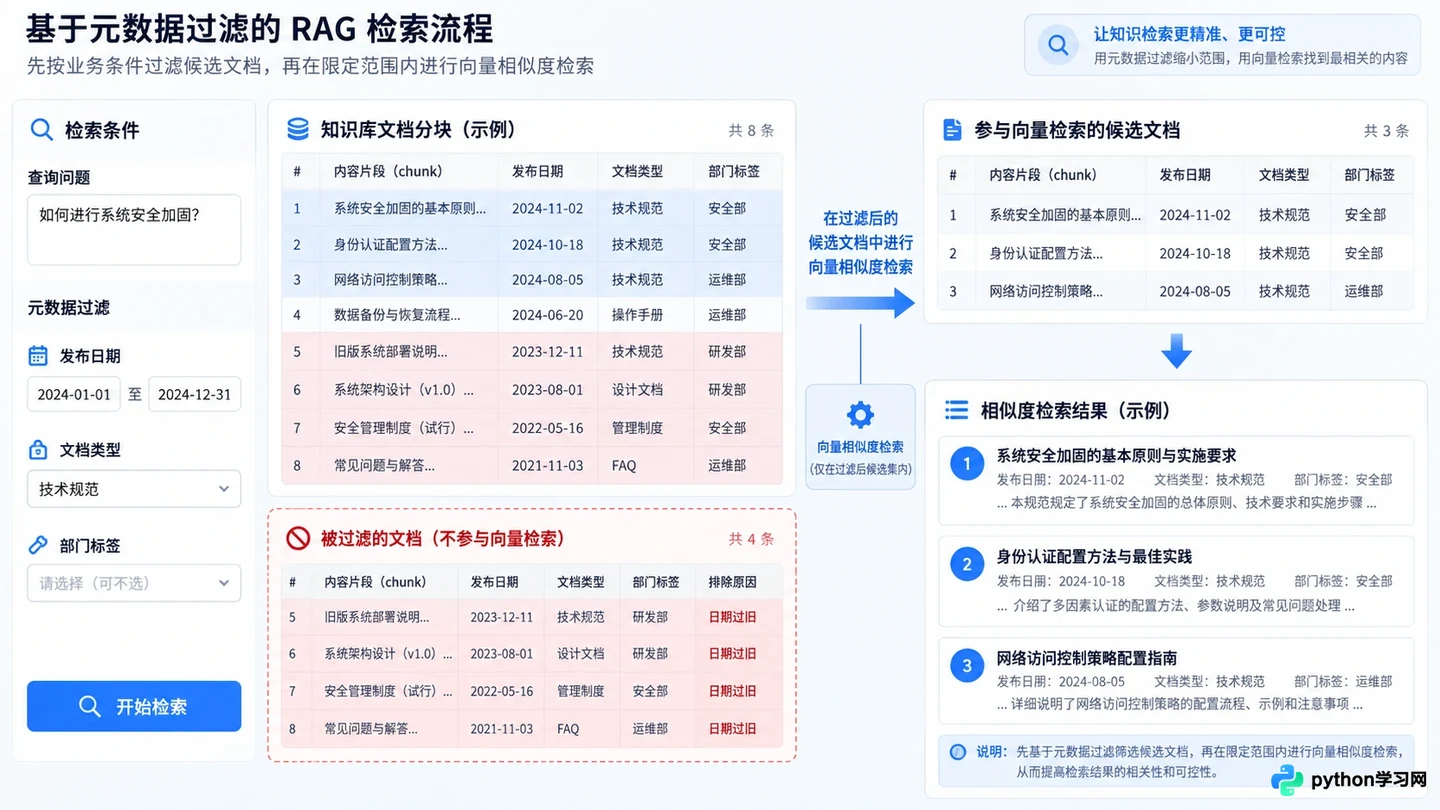
纯向量检索有时会忽略时间、来源或作者等关键约束条件,导致检索出过时或不相关的文档。引入元数据过滤可以将搜索范围限定在特定的子集内,从而大幅提高信噪比。在索引阶段,为每个文本块附加诸如“发布日期”、“文档类型”或“部门标签”等属性。
在执行检索时,先通过元数据进行预筛选,再对剩余候选集进行向量相似度计算。这种“先过滤后检索”的策略能有效排除干扰项。例如,当用户询问最新的技术规范时,系统可自动过滤掉两年前的旧文档,确保检索结果具备时效性。元数据过滤与向量搜索的结合,是解决垂直领域精确检索问题的有效手段。
关于元数据过滤
关于查询重写
用户的原始提问往往简短、模糊或缺乏必要的背景信息,直接将其转化为向量可能导致匹配偏差。查询重写旨在将用户意图转化为更适合检索的形式。一种常见的方法是使用小参数模型对用户问题进行扩展,补充隐含的实体或同义词。
另一种策略是假设性问题生成,即让模型根据文档内容反向生成可能的问题,并将这些生成问题与原文一起索引。当用户提问时,系统不仅匹配原始问题,还匹配这些假设性问题,从而拓宽检索覆盖面。此外,多步推理查询可以将复杂问题拆解为多个子问题,分别检索后再合并结果,适用于处理需要多跳推理的场景。
关于混合检索机制
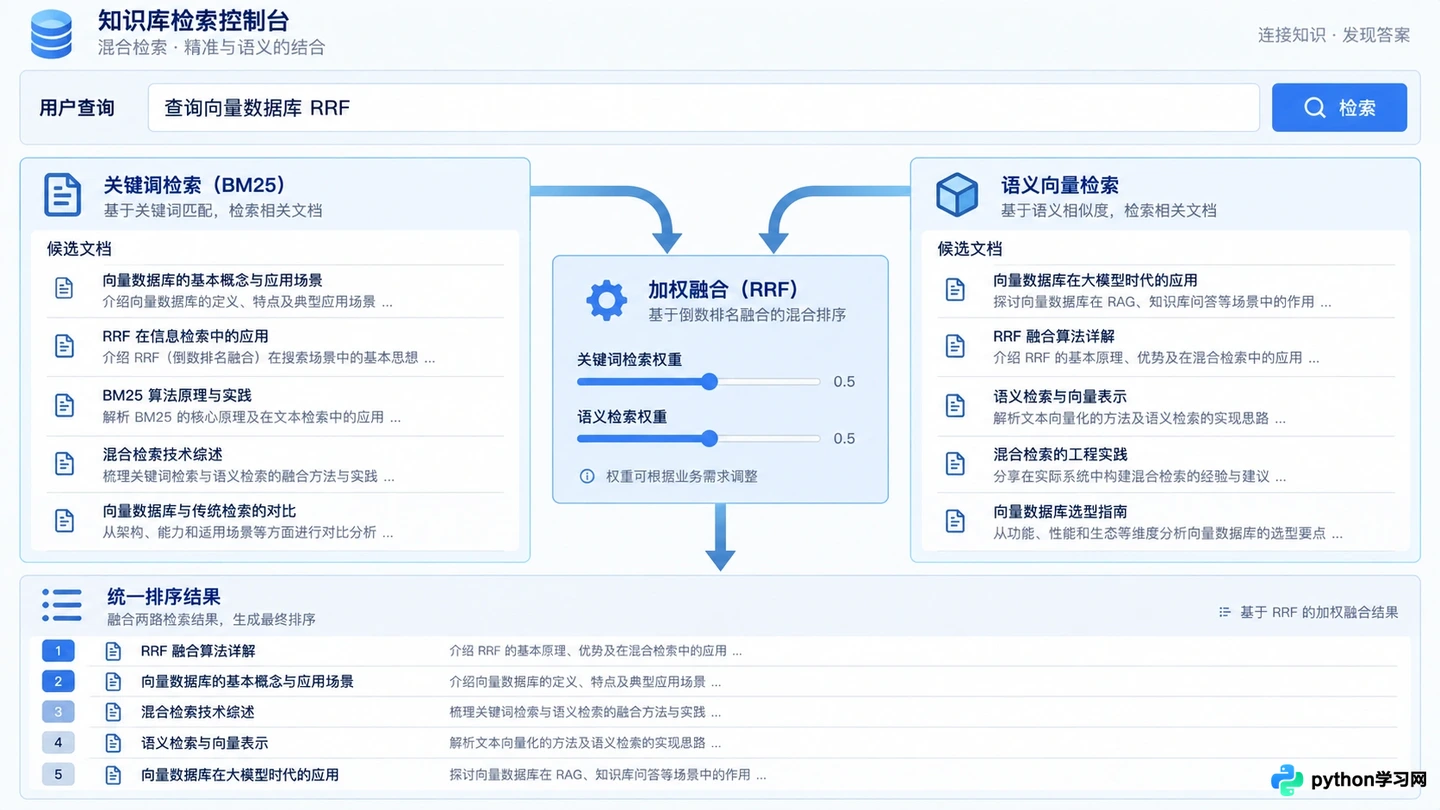
单一的词法检索或向量检索各有局限。词法检索擅长精确匹配专有名词,而向量检索擅长捕捉语义相似性。混合检索结合了两者的优势,通常采用BM25算法与向量相似度得分加权融合的方式。
在实际配置中,需要调整两者的权重比例。对于术语密集型的专业技术文档,可适当提高BM25的权重;对于概念解释类内容,则侧重向量相似度。现代向量数据库大多支持原生混合检索功能,允许在一次请求中并行执行两种搜索,并通过倒数排名融合(RRF)等算法统一排序结果。这种机制能显著改善对生僻词或特定术语的召回效果。
关于混合检索机制
关于重排序模型
初步检索返回的前K个结果中,可能仍包含相关性较低但向量距离较近的噪声数据。重排序(Reranking)是在检索后引入的一个精细排序步骤,使用专门的交叉编码器模型对候选文档与查询的相关性进行打分。
虽然重排序会增加一定的延迟,但它能极大地提升Top-N结果的准确度。通常的做法是先通过向量检索快速召回较大数量的候选集(如50-100条),然后利用重排序模型对这些候选进行精排,最终只选取得分最高的前3-5条送入大模型生成答案。这种“粗排+精排”的两阶段架构,是当前提升RAG系统最终回答质量最具性价比的策略之一。
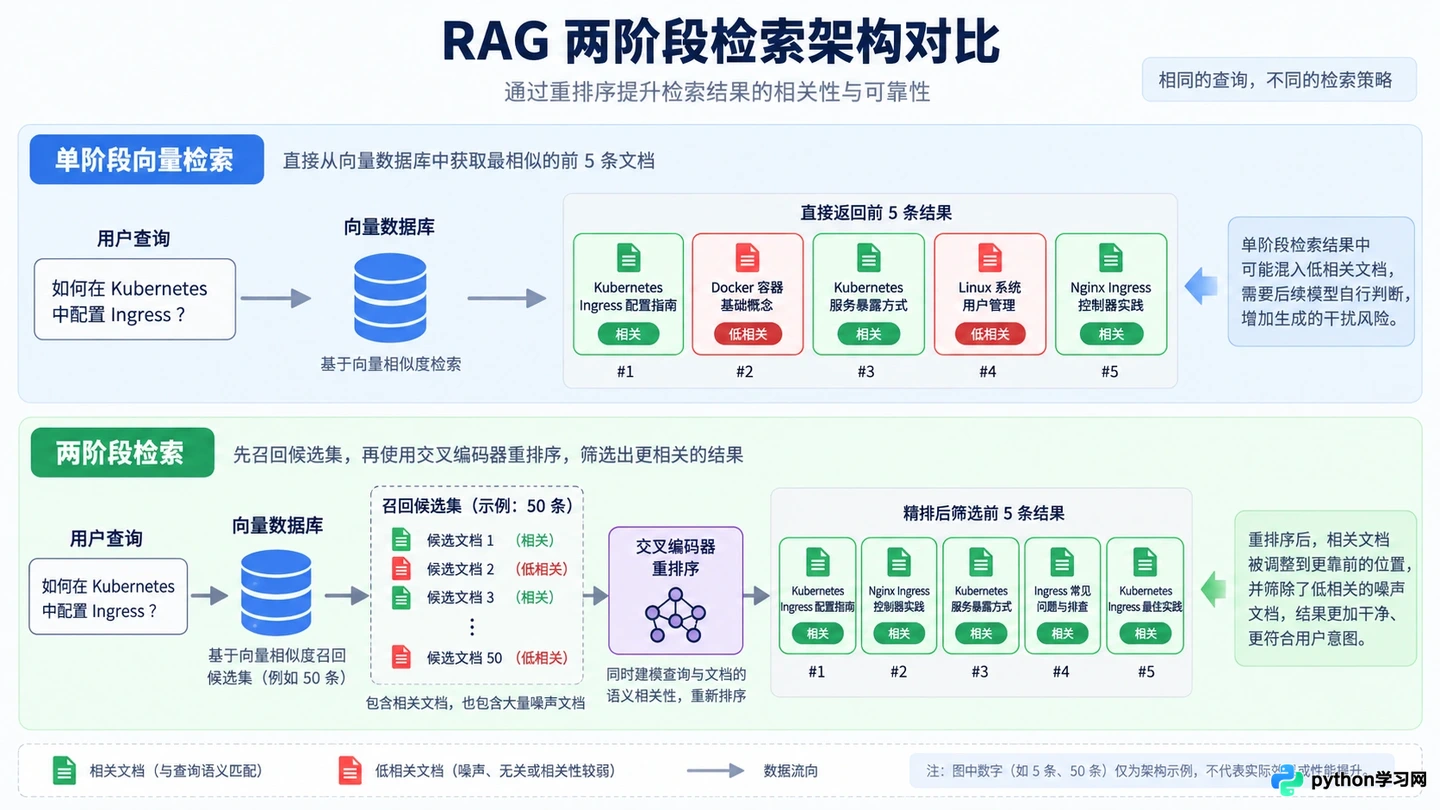
两阶段检索架构:粗排召回与重排序精排的对比
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















