


Python多行字符串与转义字符:三重引号和raw string用法

在编写 Python 代码时,处理跨行的 SQL 语句、HTML 模板,或是包含反斜杠的 Windows 路径与正则表达式,是每天都会遇到的场景。很多开发者在初学阶段经常遭遇两类困扰:要么是长文本在终端输出时多出了预期之外的换行和缩进空格,要么是在文件路径中放入反斜杠后,触发莫名其妙的 SyntaxError 或字符乱码。这两类问题的根源在于混淆了 Python 的文本排版包裹机制(三重引号)与词法阶段的转义字符解释机制(转义序列与 raw string)。本文将直接切入这两大机制的核心语法、底层行为与工程避坑实践,帮助你建立清晰的字符串处理直觉。
一、转义字符的本质与词法解析机制
在 Python 源代码中,字符串字面量是由引号包裹的一段文本。但在源码文件中,键盘无法直接敲出某些特殊动作(例如 ASCII 换行符、制表符退格),或者直接输入某些字符会与字符串自身的边界定义产生冲突(例如在单引号字符串中包含单引号)。为了解决这一矛盾,Python 引入了反斜杠 \ 作为转义引导符。
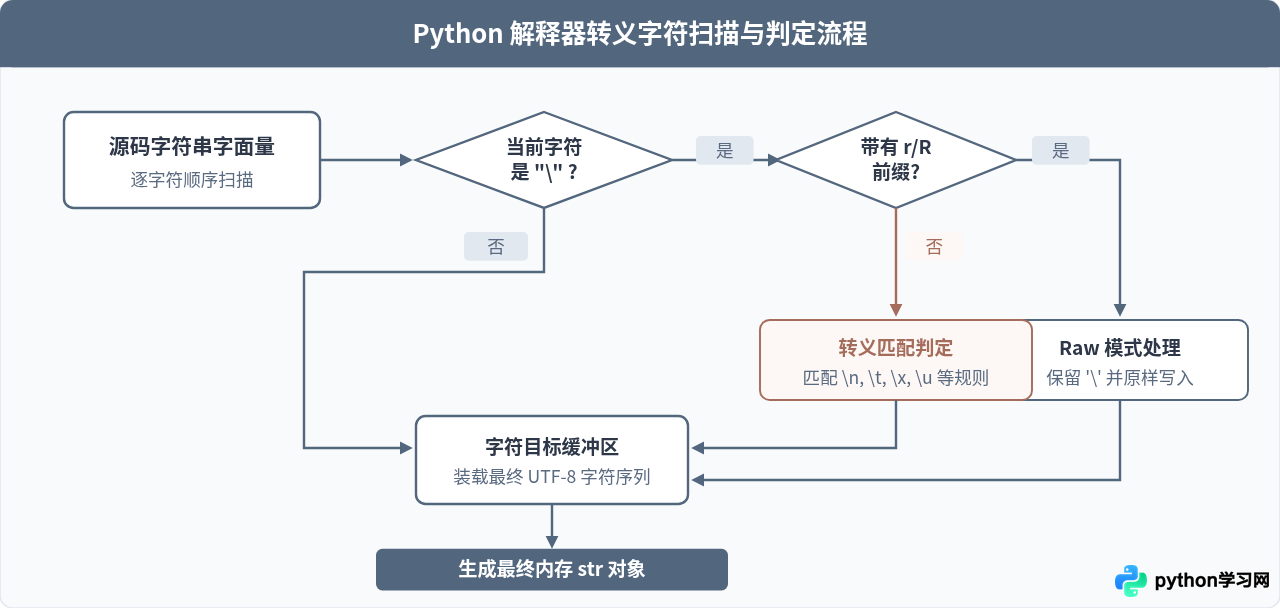
当 Python 词法分析器(Lexer)扫描字符串时,一旦检测到反斜杠 \,它便不再将后续字符视为普通的字面量字符,而是尝试与后面的字符合并,解释为一个预定义的转义序列。常见的转义序列包括:
\n:换行符(Line Feed, ASCII 10),使输出光标跳至下一行起始位置。\t:水平制表符(Horizontal Tab, ASCII 9),用于对齐排版。\\:字面量反斜杠本身,防止后续字符被意外转义。\'与\":单双引号转义,避免提前闭合当前字符串。\uXXXX与\UXXXXXXXX:16 位与 32 位 Unicode 字符编码序列。
反斜杠带来的最典型意外往往发生在输入文件路径时。例如,直接书写 path = "C:\users\test\notes.txt" 时,解释器会将 \u 误判为 Unicode 字符转义的起始标记,将 \t 转换为制表符,最终导致抛出 SyntaxError: (unicode error) 'unicodeescape' codec can't decode bytes...。理解词法扫描的这一判定顺序,是解决一切字符串转义异常的前提。
二、多行字符串的构建利器:三重引号语法
在 Python 中,单引号 '...' 和双引号 "..." 默认只能包含单行字面量。若直接在单双引号内部换行,词法分析器会在行尾遇到换行符时立即抛出 SyntaxError: unterminated string literal。要直接跨行书写文本,最直观的语法是使用连续三个单引号 '''...''' 或三个双引号 """..."""。
1. 换行符与空白字符的原样保留机制
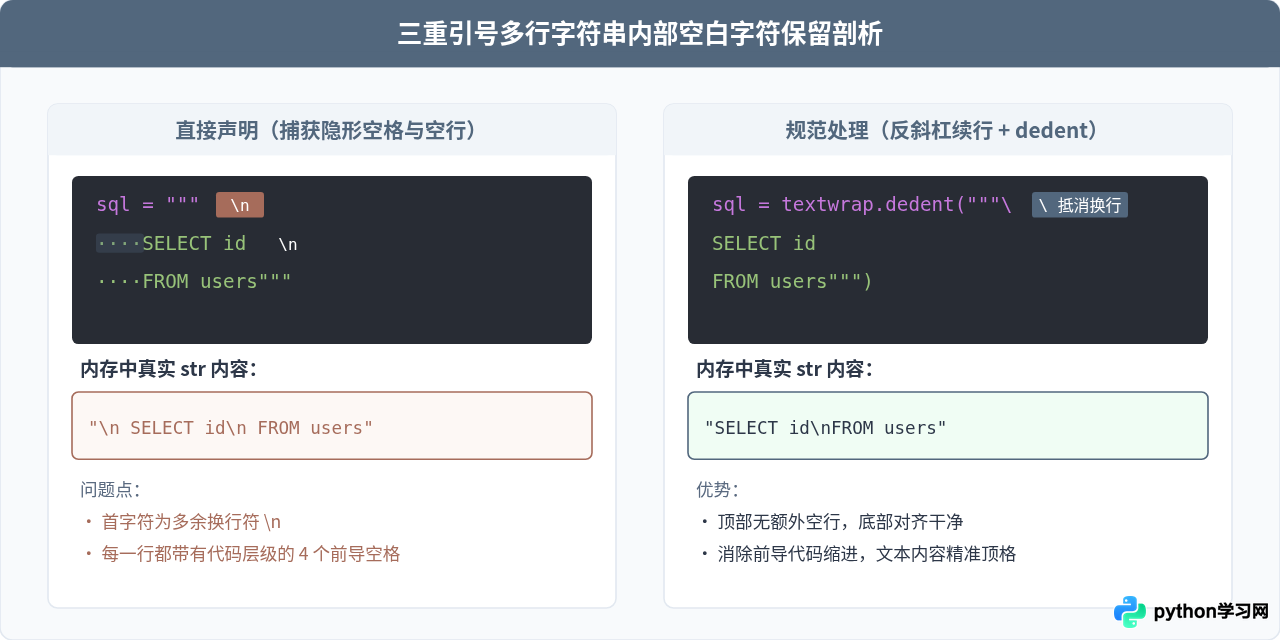
三重引号的设计核心是所见即所得的换行与缩进捕获。换言之,你在三重引号内部敲下的每一个回车、制表符或空格,都会被 Python 解释器忠实地转换为 \n 和空格字符,存入字符串的内存表示中。
# 示例 1:默认保留首尾换行与前导空格
query = """
    SELECT id, name
    FROM users
    WHERE active = 1
"""

# 查看真实字符结构
print(repr(query))
# 示例输出:'\n    SELECT id, name\n    FROM users\n    WHERE active = 1\n'
观察上述输出的 repr() 可以看到,三重引号起始位置紧随其后的回车,生成了首个 \n;每行前面的 4 个代码缩进空格,也完整保留在 SELECT 和 FROM 之前;最后一行的闭合引号之前同样保留了一个换行。在 SQL 查询中,多余空白并不影响执行;但在构建 Markdown、生成 Shell 脚本或格式化提示词时,这些前导空格和空行会导致排版错乱。
2. 精确控制多行边界与缩进清理
为了既保持代码排版美观,又不让冗余字符污染字符串内容,Python 社区有两项经过实战检验的标准做法:
- 行尾反斜杠转义换行符:在起始的三重引号后面立即放置一个反斜杠
\。反斜杠会转义掉紧跟其后的物理回车,消除字符串起始处的空行。 - 标准库
textwrap.dedent()剔除公共缩进:在函数或类内部定义多行文本时,代码必须遵循 PEP 8 缩进规范。使用textwrap.dedent()可以智能计算所有非空行的最小前导空格数,并在运行时将其安全剥离。
import textwrap

def get_config_template():
    # 首行加 \ 消除开头空行,末行 \ 消除结尾空行
    raw_text = """\
    server:
      host: 127.0.0.1
      port: 8080
    logging:
      level: INFO\
"""
    return textwrap.dedent(raw_text)

print(repr(get_config_template()))
# 示例输出:'server:\n  host: 127.0.0.1\n  port: 8080\nlogging:\n  level: INFO'
三、Raw String(原始字符串)工作原理与边界陷阱
许多初学者认为 Raw String(以 r 或 R 为前缀的字符串字面量)会彻底关闭一切转义规则。这种理解只对了一半,正是对后半部分的忽略导致了实际开发中的诸多暗坑。
1. Raw String 的根本作用:抑制转义解释
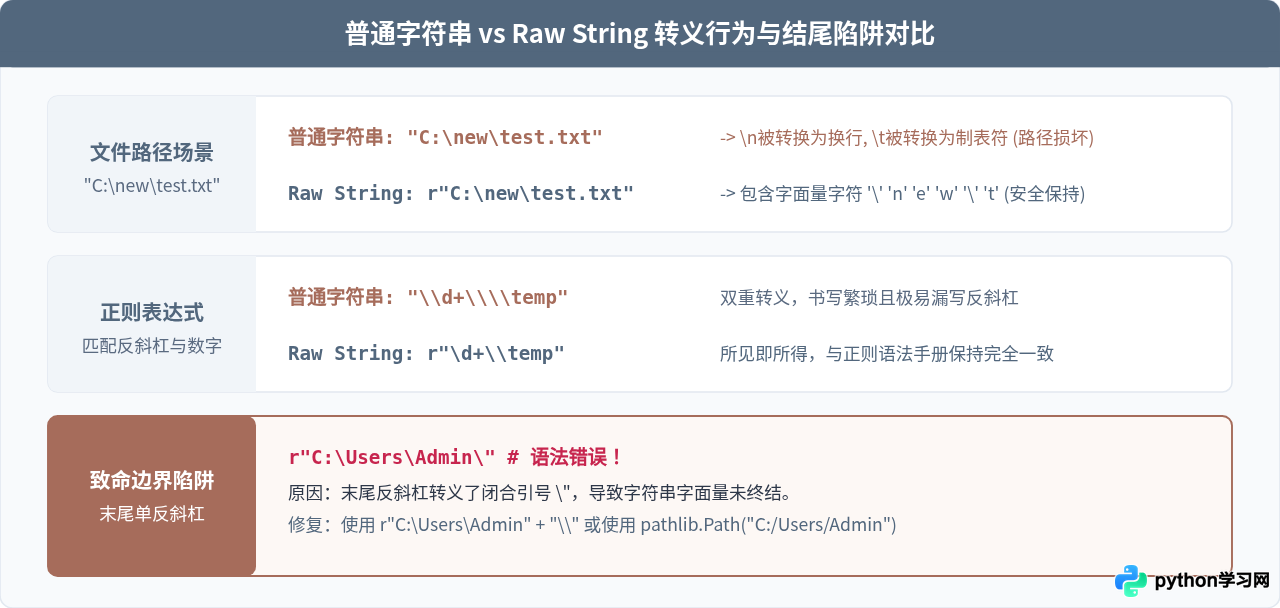
在普通字符串中,\n 代表换行,\b 代表退格,反斜杠本身必须写成 \\。而当给字符串加上 r 前缀(例如 r"hello\nworld")时,Python 词法分析器便不再将反斜杠及其后继字符映射为特殊 ASCII 控制字符。在内存中,它会忠实地保留两个独立的字符:反斜杠字符 \ 和字母 n。
这一特性在以下两个领域至关重要:
- 正则表达式(Regular Expressions):在正则规则中,
\d表示数字,\s表示空白。如果使用普通字符串,为了传递一个字符\d给正则引擎,必须在 Python 语法层面先将反斜杠转义,写成"\\d";若要匹配一个字面量反斜杠,甚至需要写成"\\\\"。而使用r"\d"则完全免去了 Python 语法层的二次转义负担。 - Windows 文件路径:使用
r"C:\workspace\temp\new"可以彻底避免\t(制表符)或\n(换行符)对文件路径造成的破坏。
底层机制警示:Raw String 并不是真正意义上的“未处理原始字节”!
在 Python 的语法规范中,即便在 Raw String 内部,反斜杠依然保留了转义引号的能力。这一规则是为了允许我们在 raw 字符串中嵌入与定界符相同的引号(例如 r'what\'s up')。这也随之带来了一个臭名昭著的语法限制:Raw String 的末尾绝对不能出现奇数个反斜杠。
例如,以下书写是完全非法的:
# 错误示例:末尾的单反斜杠转义了结束引号,导致字符串未闭合
dir_path = r"C:\Program Files\Python\"
# 运行结果:SyntaxError: unterminated string literal (detected at line 1)
因为最后一个反斜杠转义了双引号 ",词法分析器认为该双引号只是字符串内容的一部分,进而导致寻找不到字符串的闭合边界。要解决 Windows 路径末尾的反斜杠问题,最佳工程实践是使用 Python 3 的 pathlib.Path,或者通过显式拼接补齐:
from pathlib import Path

# 推荐方案 1:使用跨平台 pathlib,完全脱离手动拼接反斜杠
safe_path = Path(r"C:\Program Files\Python")

# 推荐方案 2:如果必须以反斜杠结尾的字符串输出
ending_slash_path = r"C:\Program Files\Python" + "\\"
四、协同用法:三重引号与 Raw String 的组合
三重引号与 raw string 并非相互排斥的单选项,二者可以结合使用:r"""...""" 或 r'''...'''。这种语法组合同时赋予了字符串跨越多行书写以及原样保留内部反斜杠的两大特性。
最常见且高频的生产场景是编写带有详细注释的多行正则表达式(结合 re.VERBOSE 标志),或者编写内嵌有大量转义符与换行排版的脚本模版:
import re

# 组合使用 r 和三重引号:多行且含有大量 \d, \s 等原生反斜杠
phone_pattern = re.compile(r"""
    ^                    # 匹配行首
    (?:\+?(\d{1,3}))?    # 可选国际区号(1-3位数字)
    [-. ]?               # 可选分隔符
    (\d{3,4})            # 区号或前缀
    [-. ]?               # 可选分隔符
    (\d{4})              # 后续编号
    $                    # 匹配行尾
""", re.VERBOSE)

match = phone_pattern.match("+86 010-8888")
print(match.groups() if match else "No match")
在 Python 3.6 之后,甚至还可以将格式化字符串与 raw 模式以及三重引号结合,即 rf"""...""" 或 fr"""..."""。这种形态既允许大括号表达式 {expr} 进行动态插值,又能够抑制普通反斜杠的转义行为。
五、形态选择与工程避坑全景总结
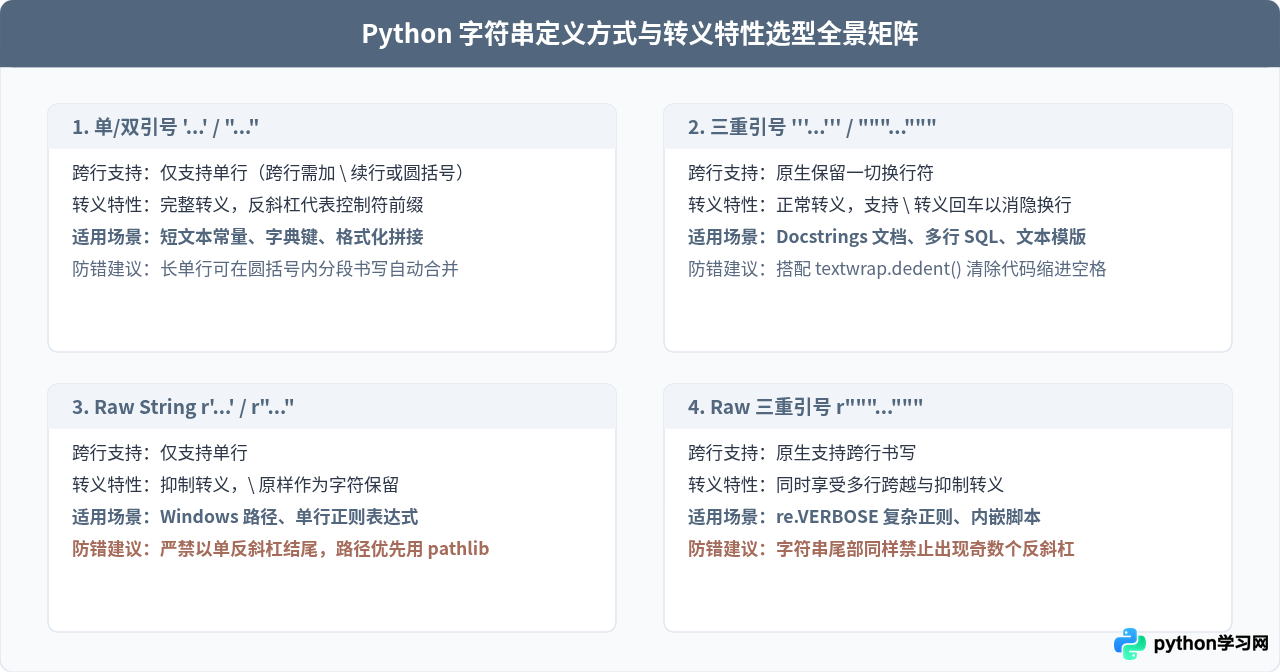
面对各种不同类型的文本构造需求,合理选用单双引号、三重引号、Raw String 或系统库工具,能够大幅提高代码的可读性并减少隐蔽缺陷。下表梳理了不同形态的核心差异与适用场景:
| 字符串形式 | 转义序列处理 | 跨行能力 | 典型应用场景 | 易错提醒 |
|---|---|---|---|---|
单 / 双引号'...' / "..." |
正常转义解释(如 \n) |
否(单行) | 字典键名、单行日志、短文本 | 内部有相同引号时须转义或混用单双引号 |
三重引号'''...''' / """...""" |
正常转义解释(如 \n) |
原生支持跨行 | 函数 Docstring、多行 SQL、邮件模板 | 会保留代码缩进空格,必要时用 dedent 清理 |
Raw Stringr'...' / r"..." |
抑制转义解释(原样保留 \) |
否(单行) | 短正则表达式、Windows 文件路径 | 末尾不可为单数反斜杠(如 r"C:\" 报错) |
Raw 三重引号r"""...""" |
抑制转义解释(原样保留 \) |
原生支持跨行 | re.VERBOSE 正则、Shell 嵌入脚本 |
同样受末尾不能为奇数反斜杠的限制 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















