


Python中r''和普通字符串有什么区别?
深入解析Python中r''原始字符串与普通字符串的核心区别。详细探讨词法分析阶段的转义处理、正则表达式与Windows路径应用、末尾反斜杠语法错误成因及选型决策。
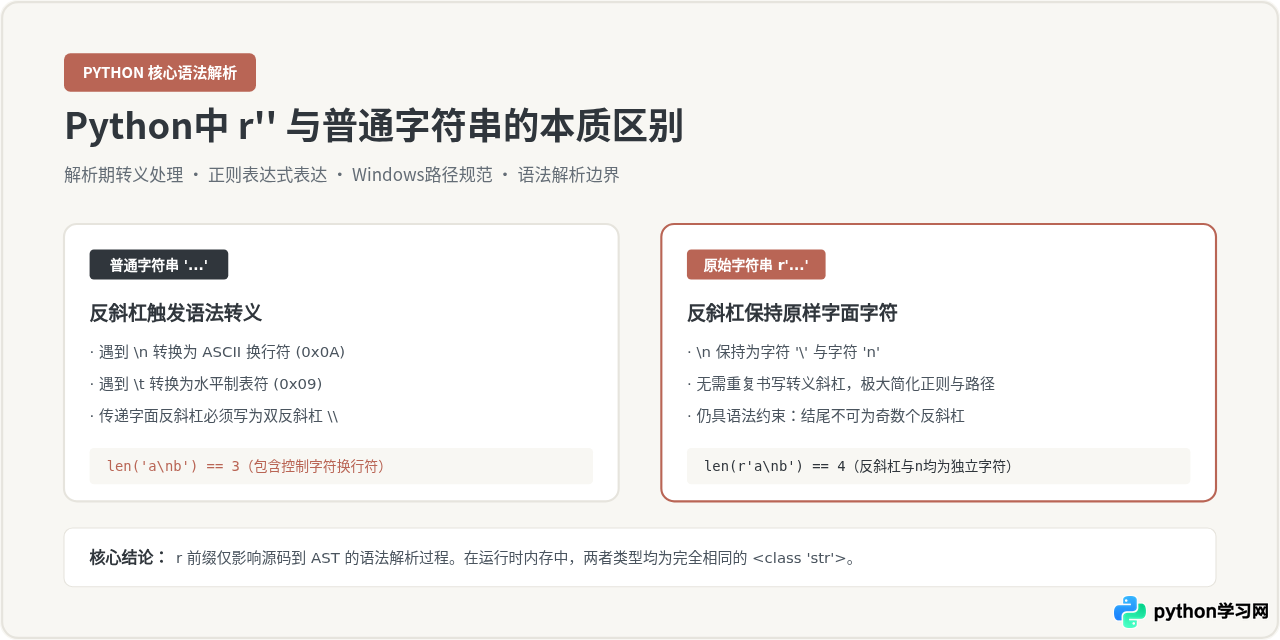
r''(原始字符串,Raw String)与普通字符串的核心区别仅在于代码解析期对反斜杠(\)的转义处理机制不同。普通字符串会将反斜杠与后续字符组合识别为转义字符(如 \n 代表换行),而原始字符串会按字面意义将反斜杠作为普通字符保留。两者在运行时的内存类型完全一致,均为内置的 str 对象。
一、核心结论:解析期行为差异与类型同一性
很多初学者在接触 Python 原始字符串时,容易产生一种误解,认为 r'hello' 会生成一种特殊的“原始字符串类型”。实际上,Python 解释器在运行时并没有一个名为 raw_str 的数据类型。
normal_s = 'hello\nworld'
raw_s = r'hello\nworld'

print(type(normal_s))  # 输出: <class 'str'>
print(type(raw_s))     # 输出: <class 'str'>
print(type(normal_s) is type(raw_s))  # 输出: True
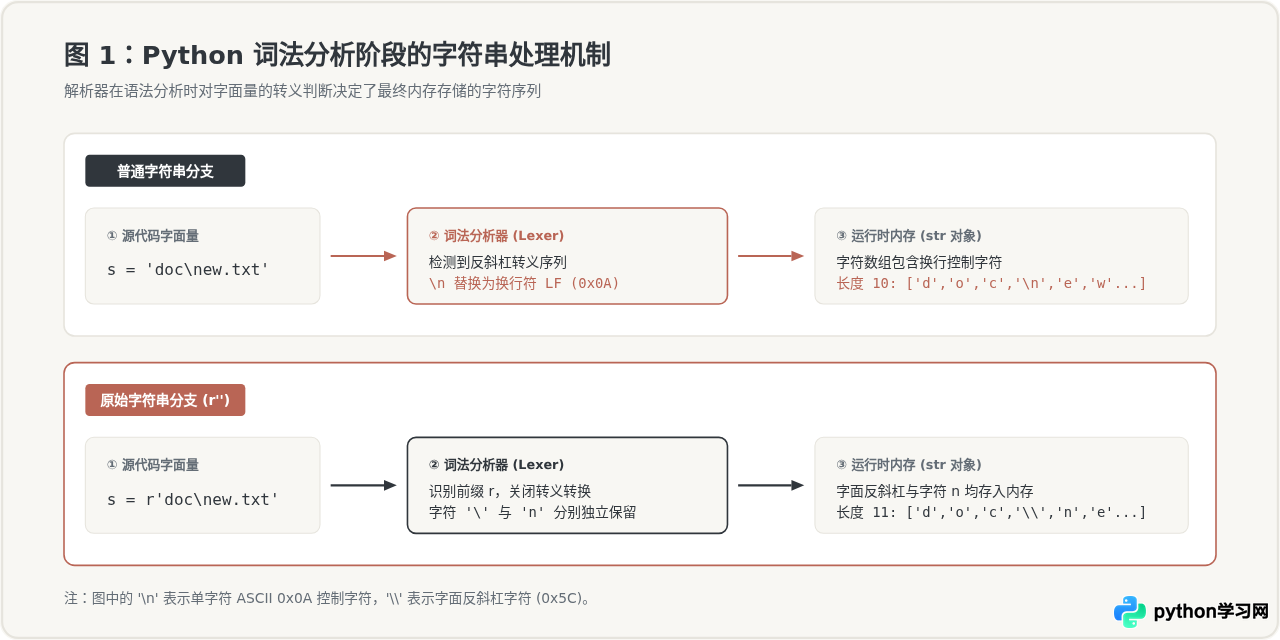
两者在内存中的本质都是不可变的 Unicode 字符序列(str)。r(或大写的 R)前缀的作用仅仅发生在词法分析(Lexical Analysis)阶段。当 Python 解析器读取源码并构建抽象语法树(AST)时,前缀 r 充当一个标记指令,告诉解析器:“在处理这个字符串字面量的内容时,不要将反斜杠视作转义符的起始标记,直接将其作为普通的反斜杠字符存入内存”。
| 字面量书写方式 | 内存中实际字符 | 字符长度 len() | 控制台 print() 输出效果 |
|---|---|---|---|
'a\nb' |
['a', '\n', 'b'] |
3 | a 和 b 分居两行 |
r'a\nb' |
['a', '\\', 'n', 'b'] |
4 | 单行直接输出 a\nb |
'C:\target' |
['C', ':', '\t', 'a', 'r', 'g', 'e', 't'] |
8 | C: 后面接水平制表位与 arget |
r'C:\target' |
['C', ':', '\\', 't', 'a', 'r', 'g', 'e', 't'] |
9 | 完整保持 C:\target |
二、普通字符串的转义机制与“斜杠困境”
在标准 Python 语法中,普通字符串支持丰富的转义序列。反斜杠被赋予了“转义引导符”的特殊身份:
\n代表换行(ASCII 0x0A)\t代表水平制表符(ASCII 0x09)\r代表回车(ASCII 0x0D)\\代表反斜杠本身(ASCII 0x5C)\'与\"分别代表单双引号\u4e2d或\x41代表 Unicode 与十六进制编码
这种机制极大方便了控制字符与特殊字符的表达。但在以下两类极为常见的高频开发场景中,反斜杠本身就是业务内容的一部分,普通字符串就会引发著名的“反斜杠困境”。
1. Windows 文件路径处理
Windows 操作系统的文件路径使用反斜杠作为层级分隔符。如果不使用原始字符串,直接写路径往往会引发不可预期的 Bug:
# 错误示例:路径中的 \t 和 \n 被意外转义
path = 'C:\target\new_project\report.csv'
print(path)
# 打印结果:
# C:   arget
# ew_project\report.csv在上面的代码中,\t 变成了制表符,\n 变成了换行符,传给文件打开函数时会直接抛出 FileNotFoundError 或 OSError: [Errno 22] Invalid argument。若坚持使用普通字符串,开发者必须手动将每个反斜杠写成双反斜杠 'C:\\target\\new_project\\report.csv',这显著降低了代码的可读性与维护效率。
2. 正则表达式模式匹配
更令人头疼的是正则表达式模块 re。正则表达式语法本身也深度依赖反斜杠进行字符集定义(例如 \d 匹配数字、\b 匹配单词边界、\s 匹配空白符)。
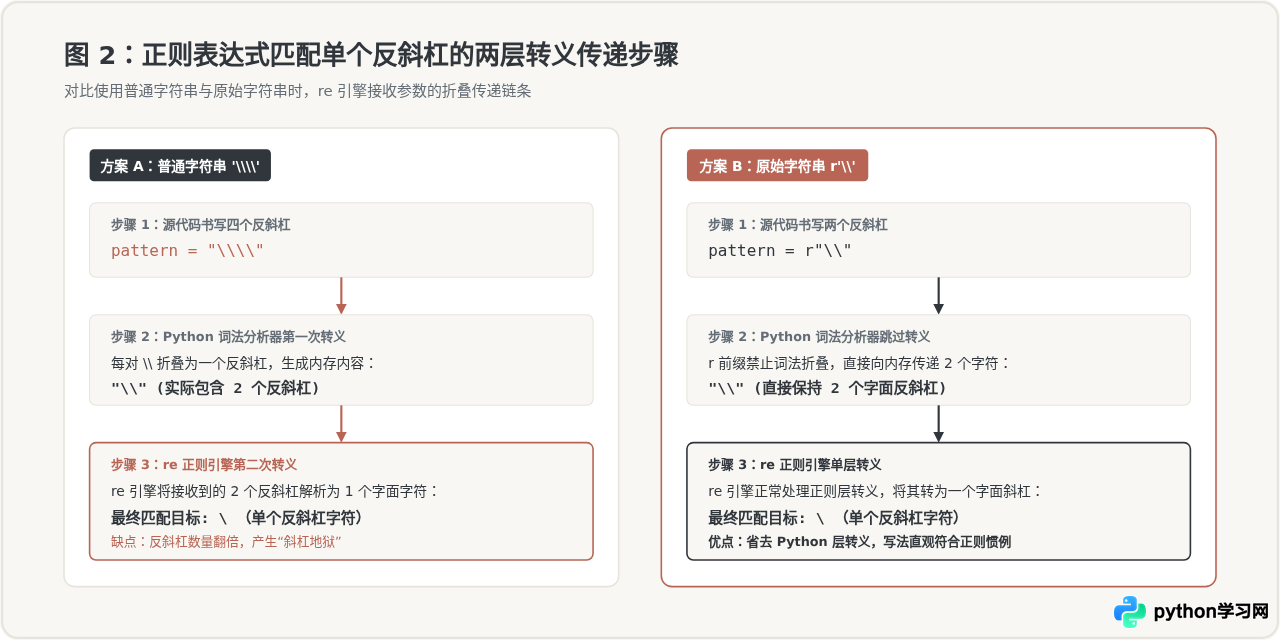
如果使用普通字符串书写正则表达式,字符串需要先经历 Python 词法分析器 的第一次转义折叠,折叠后的字符串再被传递给 re 编译引擎 进行第二次转义解析。如果目标仅仅是在文本中匹配一个字面的反斜杠 \,普通字符串将不得不写成令人费解的四个反斜杠:"\\\\"。
三、原始字符串(r'')的工作原理与实际应用
为了免除上述不必要的转义摩擦,Python 引入了原始字符串语法。在单引号、双引号、三单引号或三双引号之前添加 r 或 R,即构成原始字符串字面量。
1. 正则表达式中的标准写法
编写正则表达式时,业界公认的规范是所有正则模式均应使用 r'' 前缀。这不仅能有效消除 Python 层的转义干扰,还能规避未来的语法弃用告警。
从 Python 3.6 开始,如果在普通字符串中使用了无效的转义序列(例如 '\d' 不是合法的 Python 内置转义字符),Python 解释器会发出 DeprecationWarning;在未来的 Python 版本中,这甚至会升级为语法错误(SyntaxError)。而使用 r'\d+' 则完全合规且安全。
import re

text = "Apple price: $120, Banana price: $85"

# 推荐规范:明确添加 r 前缀
pattern = r'\$(\d+)'
matches = re.findall(pattern, text)
print(matches)  # 输出示例: ['120', '85']
2. Windows 路径与原生字面量
在涉及包含反斜杠的硬编码路径或测试用例时,r'' 能够原汁原味地保留反斜杠:
# 规范写法:使用原始字符串避免意外转义
config_path = r'C:\Users\Administrator\new_data\config.ini'
print(config_path)  # 输出示例: C:\Users\Administrator\new_data\config.ini
四、经典陷阱:末尾反斜杠语法错误与本质误区
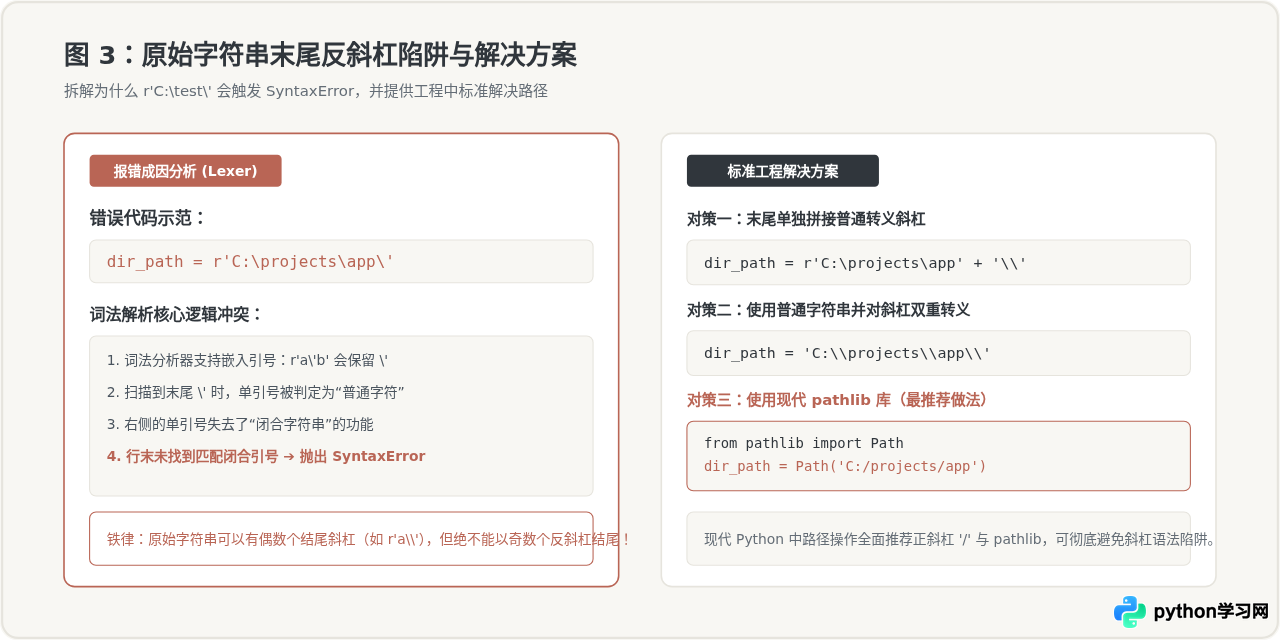
原始字符串虽好,但绝非“可以完全任意输入字符的黑盒”。许多开发者在使用 r'' 时都会踩入一个非常隐蔽的经典语法报错:字符串末尾不能有奇数个反斜杠。
# 错误示例:直接抛出 SyntaxError
path = r'C:\Users\name\'
# SyntaxError: unterminated string literal (detected at line 1)
1. 为什么 r'...' 末尾不能是单个反斜杠?
很多人的直觉是:“既然是原始字符串,那末尾的反斜杠就当成反斜杠字符,后面的单引号自然就是闭合引号,为什么会报‘字符串未闭合’呢?”
这是因为 Python 词法分析器在扫描原始字符串时,依然保留了对引号的转义识别能力。这一规则的设计初衷,是为了允许我们在原始字符串中嵌入与定界符相同的引号字符。例如:
- 对于
r'He said: \'Hello\'',如果不允许转义引号,解析器在遇到第一个\'时就会误认为字符串提前结束。 - 因此,Python 的规则是:遇到
\'时,单引号不会关闭字符串,并且该反斜杠与单引号都会被字面保留在结果中。
正因如此,当解析器扫描到 r'C:\Users\name\' 时,末尾的 \' 被解释为“被转义的单引号”,该单引号失去了闭合字符串的功能。解析器继续向后寻找真正的闭合单引号,直到行尾都没找到,最终抛出 SyntaxError: unterminated string literal。
从 Python 3 起,你可以组合使用前缀,如 rf'...' 或 fr'...'。它同时具备原始字符串不转义反斜杠与格式化表达式插值的能力。但请特别注意:在 Python 3.12 之前,rf'{var}\' 依然受制于末尾反斜杠语法规则,花括号内部也不允许直接出现反斜杠(Python 3.12+ 放宽了花括号内反斜杠的限制,但字面量结尾规则依然有效)。
五、选型指南与决策流程
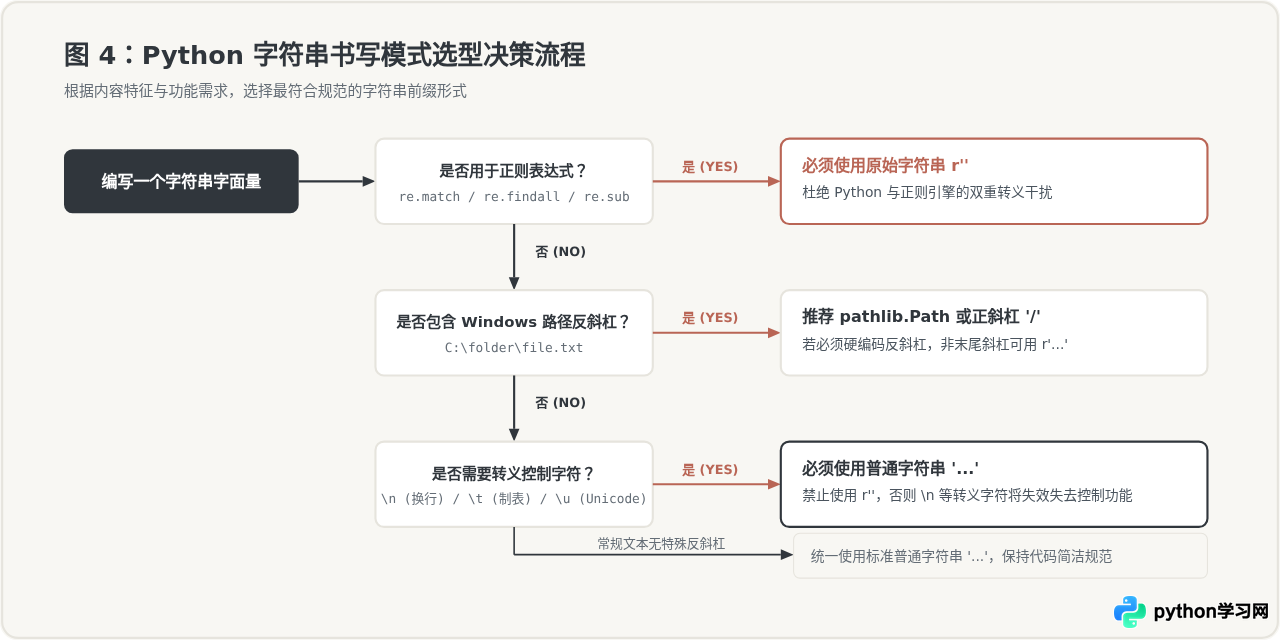
为了在实际工程中写出稳健、优雅的代码,我们可以根据字符串的具体用途遵循以下决策树:
总结而言:
- 看场景:编写正则表达式时,无条件优先使用
r'';需要真正的换行、制表符或 Unicode 字符时,必须使用普通字符串。 - 看边界:使用
r''时,时刻警惕末尾不可留有奇数个反斜杠。在涉及路径时,现代 Python 推荐优先使用跨平台的pathlib.Path或统一的正斜杠/。 - 记本质:
r前缀只在编译与解析源码时发挥作用,绝不会在内存中创建某种“特殊类型”。理解了这一点,就能彻底掌握 Python 中普通字符串与原始字符串的差异与协作方式。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















