


Python标准库支持XPath吗?xml.etree.ElementTree的功能边界

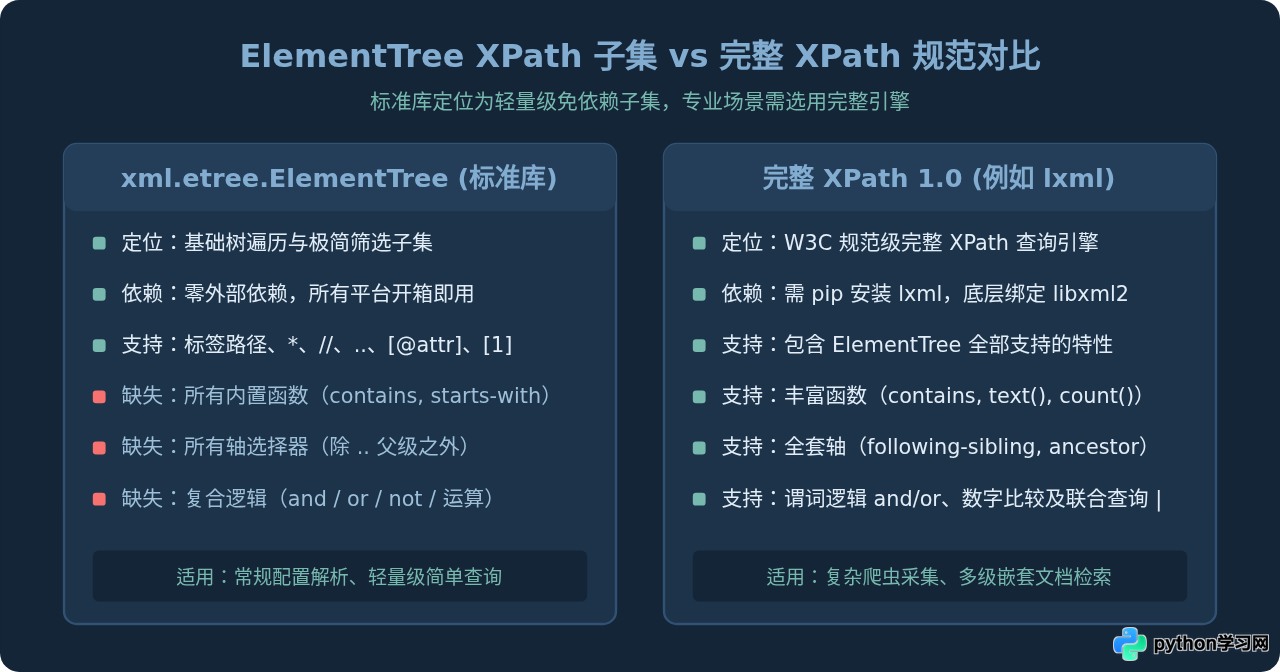
核心结论:Python 标准库内置的 xml.etree.ElementTree 确实支持 XPath,但它支持的仅仅是一个高度精简的功能子集(XPath Subset)。它能够完成基础的层级定位、通配匹配、属性检查和位置筛选,但完全不支持任何 XPath 函数(如 contains())、轴选择器(如兄弟节点定位)、布尔组合条件以及联合查询。当业务需要使用完整 XPath 1.0 或更高规范时,必须使用第三方库 lxml。
一、问题起因:为什么你的 XPath 表达式会直接报错?
在日常开发中,许多开发者在解析 XML 配置文件或提取 Web 服务返回的数据时,往往希望利用自己熟悉的 XPath 语法直接定位节点。假设我们面对如下一段商品 XML 数据:
<catalog>
    <book id="b1" status="active">
        <title>Python Automation</title>
        <price>59.00</price>
    </book>
    <book id="b2" status="draft">
        <title>Advanced Data Structures</title>
        <price>89.00</price>
    </book>
</catalog>
开发者常常习惯性地写出如下查询代码,试图模糊筛选标题中带有 “Python” 的书籍,或者筛选价格大于 50 的项目:
import xml.etree.ElementTree as ET

root = ET.fromstring(xml_text)
# 尝试使用 contains() 函数
root.findall(".//book[contains(title, 'Python')]")
执行这段代码时,Python 解释器会立即抛出异常:SyntaxError: cannot use xpath function 'contains'。这是许多开发者第一次直观感受到 Python 标准库限制的时刻。标准库之所以这样设计,是因为 ElementTree 的核心目标是轻量、纯粹与高效,内置轻量遍历引擎,而避免为了完整实现庞大的 W3C XPath 规范引入沉重的 C 运行时与语法解释器。
二、查询核心:ElementTree 的三类检索方法与执行机制
在 ElementTree 中,XPath 表达式主要传递给三个方法:find()、findall() 和 iterfind()。无论是在 ElementTree 对象上还是在单个 Element 节点上调用,它们都遵循统一的执行逻辑:
find(match, namespaces=None):在树结构中按 XPath 规则寻找第一个匹配的节点,找到立即返回Element对象;若无匹配则返回None。findall(match, namespaces=None):遍历所有匹配项,以 Python 的list[Element]形式一次性返回所有匹配节点;若无匹配则返回空列表[]。iterfind(match, namespaces=None):返回一个惰性求值的生成器(Generator)。在处理中大型 XML 文档时,它不需要一次性将所有匹配对象加载进内存列表,适合流式处理。
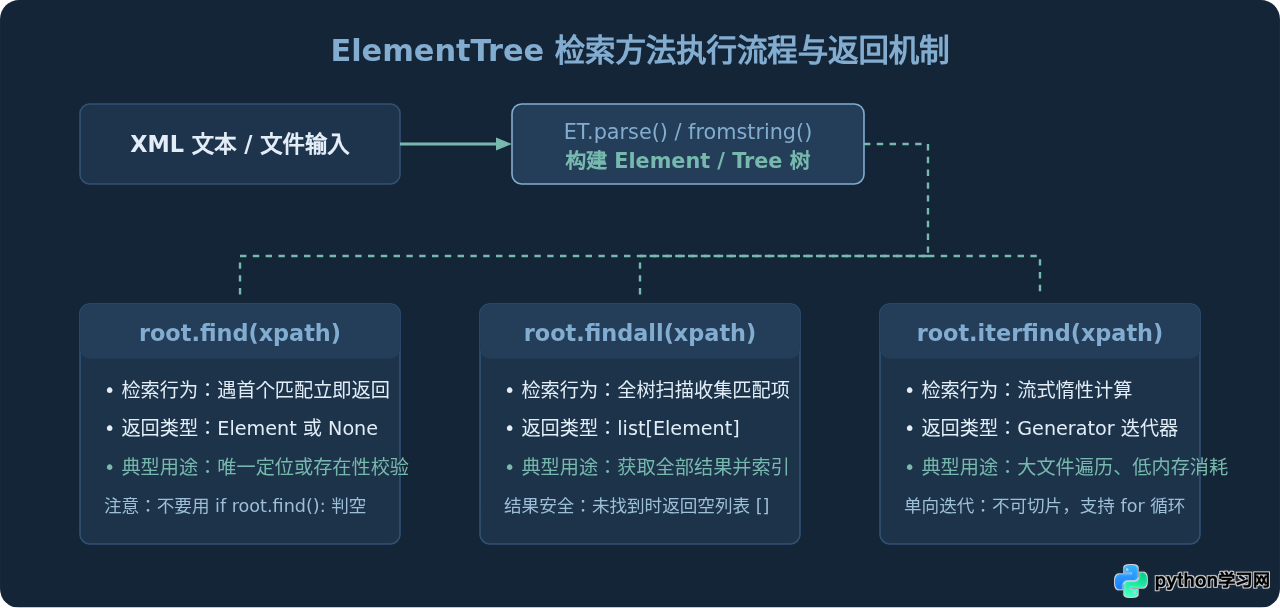
防坑提醒:在 Python 3 中,空 Element 对象在布尔上下文中曾被视为 False(如果没有子节点)。官方明确建议严禁使用 if root.find("title"): 来判断节点是否存在,必须显式书写为 if root.find("title") is not None:,以防引起意料之外的逻辑分支判断错误。
三、能做什么:ElementTree 官方支持的 XPath 语法全集
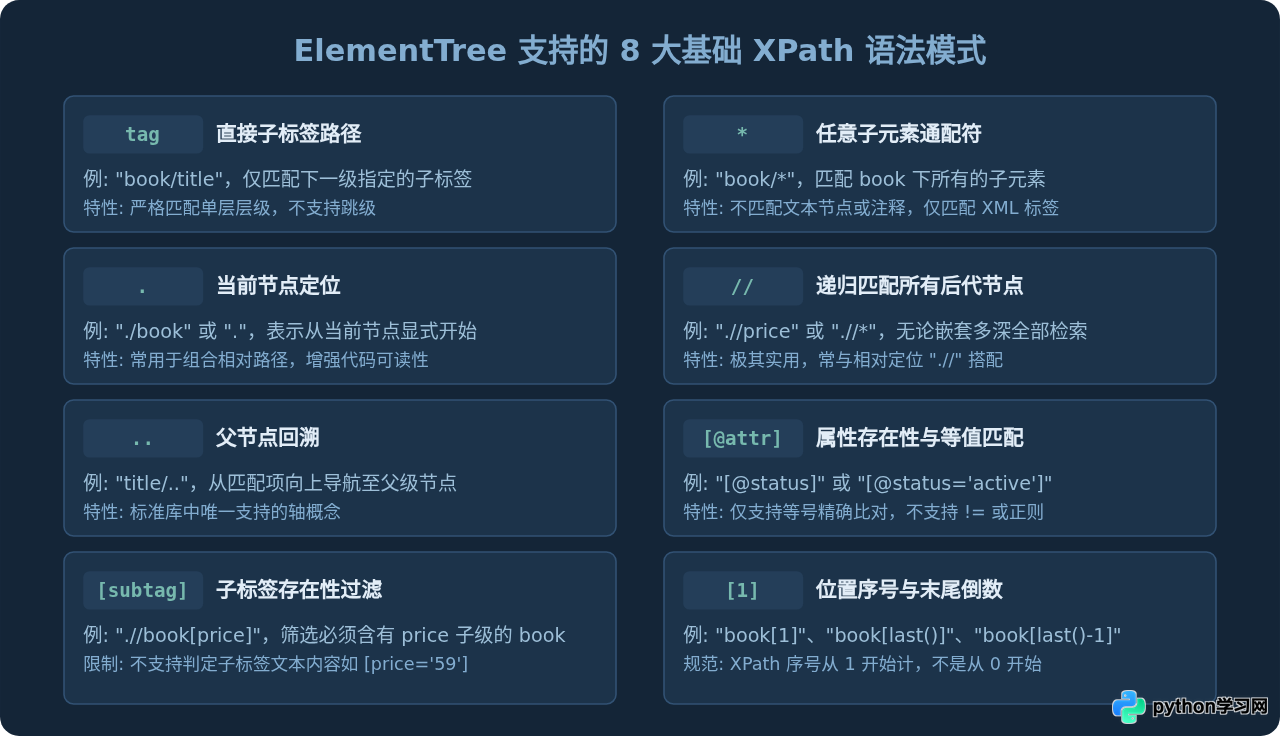
尽管受到限制,ElementTree 支持的语法子集设计得非常紧凑实用,能够覆盖多数常规树结构的定位需求。根据官方规范,以下是其完整支持的语法特征列表:
实战演示:合法语法的代码运行示例
import xml.etree.ElementTree as ET

xml_data = """<store>
    <category name="tech">
        <item id="101" available="true">
            <name>Mechanical Keyboard</name>
            <price>120</price>
        </item>
        <item id="102" available="false">
            <name>Wireless Mouse</name>
        </item>
        <item id="103" available="true">
            <name>USB-C Hub</name>
            <price>45</price>
        </item>
    </category>
</store>"""

root = ET.fromstring(xml_data)

# 1. 递归查找所有带有 price 子标签的 item
items_with_price = root.findall(".//item[price]")
print([item.find("name").text for item in items_with_price])
# 输出: ['Mechanical Keyboard', 'USB-C Hub']

# 2. 匹配属性 available="true" 的所有项目
active_items = root.findall(".//item[@available='true']")
print([item.find("name").text for item in active_items])
# 输出: ['Mechanical Keyboard', 'USB-C Hub']

# 3. 通过位置获取最后一个 item
last_item = root.find(".//item[last()]")
print(last_item.find("name").text)
# 输出: 'USB-C Hub'

# 4. 从 name 向上回溯到父级 item,并读取 id 属性
name_node = root.find(".//name")
parent_item = name_node.find("..")
print(parent_item.attrib.get("id"))
# 输出: '101'
四、不能做什么:ElementTree 明确不支持的功能边界
了解不能做什么,比盲目猜测能节省大量调试时间。如果你尝试在 ElementTree 中使用以下任何一项特性,解释器均会直接抛出语法解析异常:
| 特性分类 | XPath 标准语法示例 | ElementTree 行为与原因 |
|---|---|---|
| 内置函数 | //item[contains(name, 'Key')]//item[starts-with(@id, '10')] |
不支持 抛出 SyntaxError: cannot use xpath function。无内置函数执行引擎。 |
| 文本比较谓词 | //item[price='120']//item[text()='USB-C Hub'] |
不支持 谓词内仅支持 [@attr='val'],无法直接对子标签文本或 text() 设值比对。 |
| 轴选择器 (Axes) | following-sibling::itemancestor::category |
不支持 除了简写的父级 .. 之外,不支持任何正规轴指令。 |
| 逻辑与算术运算 | //item[@id='101' and @available='true']//item[price > 50] |
不支持 不支持 and、or、not(),不支持数值大小比较操作符。 |
| 联合查询 | //item/name | //item/price |
不支持 不支持用管道符 | 一次性合并多个查询集合。 |
命名空间(Namespaces)的处理边界
在解析带有命名空间(如 RSS、Atom 或 SOAP 文档)的 XML 时,ElementTree 也不支持隐式前缀匹配。必须采用两种标准形式之一:
xml_with_ns = """<feed xmlns="http://www.w3.org/2005/Atom">
    <title>Engineering Blog</title>
</feed>"""

root = ET.fromstring(xml_with_ns)

# 方式一:使用完整 Clark 记号({URI}tag)
title_node = root.find("{http://www.w3.org/2005/Atom}title")

# 方式二:传入命名空间映射字典(推荐)
ns = {'atom': 'http://www.w3.org/2005/Atom'}
title_node = root.find("atom:title", namespaces=ns)
print(title_node.text) # 输出: 'Engineering Blog'
五、应对方案:当标准库不足时的两套破局策略
策略一:标准库“两段式”过滤(Python 原生逻辑弥补)
如果项目受限于安全规范或交付环境,坚决不能引入任何第三方库,可以通过两段式思路:先用 ElementTree 提取粗粒度节点列表,再用 Python 原生列表推导式完成函数比对与复合逻辑:
# 目标:实现类似 //item[contains(name, 'Key') and price > 100] 的效果
matched_items = []
for item in root.findall(".//item"):
    name_el = item.find("name")
    price_el = item.find("price")

    # 在 Python 中执行复杂的包含判断与数值转换比较
    if name_el is not None and "Key" in (name_el.text or ""):
        if price_el is not None and float(price_el.text or 0) > 100:
            matched_items.append(item)

print(f"匹配到满足条件的节点数: {len(matched_items)}")
策略二:平滑迁移至 lxml
如果查询表达式高度动态、或者 XPath 逻辑是从配置文件读取的复杂规则,直接引入 lxml 是行业标准做法。lxml.etree 的 API 与标准库高度兼容,代码改动极小:
# 仅需调整导入语句,并使用 lxml 独有的 xpath() 方法
from lxml import etree

tree = etree.fromstring(xml_data.encode('utf-8'))

# 完整支持 contains、starts-with、数值比较与逻辑运算
results = tree.xpath(".//item[contains(name, 'Key') and number(price) > 100]")
for el in results:
    print(el.findtext("name"))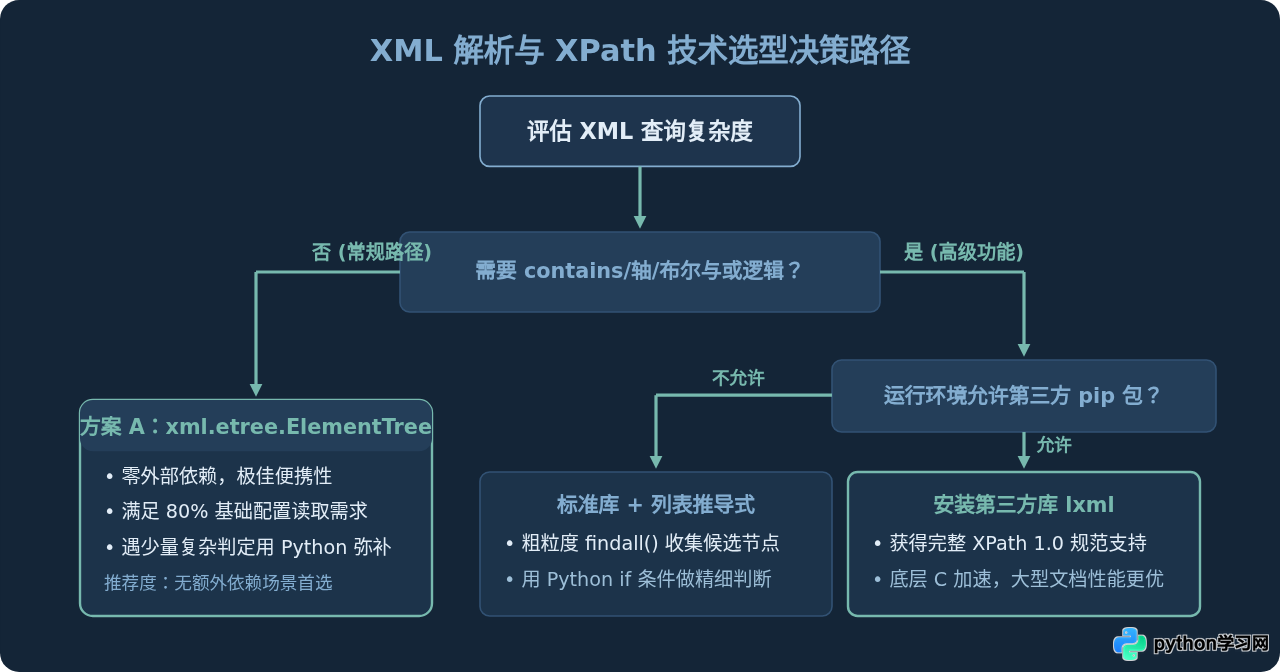
六、总结与开发备忘
综上所述,Python 标准库中并非“没有 XPath”,而是提供了一个**实用主义的轻量子集**。记住以下三条核心准则,即可在实际开发中少走弯路:
- 能用的语法记这几个:标签相对层级、
*通配符、//全树后代搜索、..父级返回、[@attr='val']属性精确匹配、以及[1]或[last()]序号筛选。 - 不能用的绝对不要写:所有函数(
contains、starts-with等)、所有正向与反向轴(following-sibling::等)、布尔算符(and、or)、以及数值比较运算符。一旦出现,标准库直接报语法错误。 - 选型分水岭:小型脚本与标准环境直接用
xml.etree.ElementTree,辅以 Python 原生判断;如果面临复杂数据提取或大规模工业级 XML 解析,果断引入lxml。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















