


Python任务管理系统开发中怎么解决数据一致性与并发冲突?

在开发 Python 任务管理系统(如基于 Celery、RQ 或自定义异步 Worker 的调度系统)时,解决数据一致性与并发冲突的核心方案是:消除无保护的读取-修改-写回(Read-Modify-Write)周期。具体实施路径分为三个层面:底层通过关系型数据库的原子条件更新与版本号乐观锁保证状态流转原子性;分布式调度层借助 Redis 分布式租约锁防止任务被多个节点重复申领;消费执行层结合唯一业务标识与幂等表确保网络重试或异常恢复时不产生脏数据。
一、并发冲突从何而来:任务状态机与竞争条件
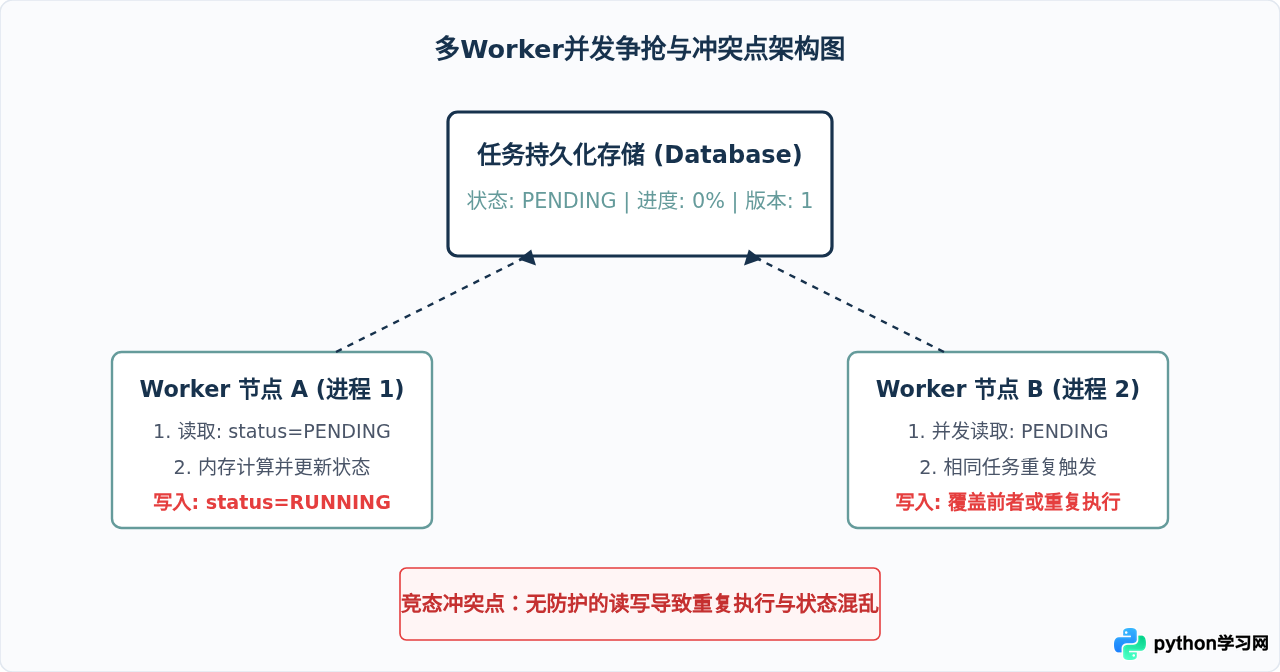
一个典型的任务生命周期包含多个状态阶段:PENDING(待处理)、RUNNING(执行中)、SUCCESS(成功)与 FAILED(失败)。当系统扩展为多进程或多分布式节点时,多个 Worker 进程会同时从数据库或队列中拉取任务。
常见的严重并发隐患包括:
- 任务被重复申领(Double Claiming):Worker A 和 Worker B 同时查询到某条处于
PENDING状态的任务,并在各自的内存中将其置为RUNNING,最终导致同一个后台计算或扣费任务被执行两次。 - 丢失更新(Lost Update):两个进程并发更新任务进度或附带的重试计数。两者读取了相同的旧计数值并各自加 1,后写入者的更新完全覆盖了前者的改动,导致计数失真。
- 超时假死与交错执行:任务 A 正在 Worker 1 执行,但由于网络卡顿超过心跳周期,调度器判定超时并将任务重新分派给 Worker 2;此时 Worker 1 恢复并写入完成状态,与 Worker 2 的写入产生冲突。
二、数据库层面的并发控制:原子操作与锁机制
关系型数据库本身支持 ACID 事务,因此在 Python 应用层,最直接、最可靠的防御手段是在 SQL 执行层面化解竞争。
1. 条件原子更新(Compare-and-Swap)
避免在 Python 代码中“先查后改”,直接利用数据库执行单条带有前提条件的 UPDATE 语句,并利用受影响行数(Rowcount)来判断是否抢占成功:
import psycopg2

def claim_task(conn, task_id: int, worker_id: str) -> bool:
    with conn.cursor() as cur:
        # 仅当任务状态仍然为 PENDING 时才允许变更为 RUNNING
        cur.execute(
            """
            UPDATE tasks
            SET status = 'RUNNING', worker_id = %s, updated_at = NOW()
            WHERE id = %s AND status = 'PENDING';
            """,
            (worker_id, task_id)
        )
        # 如果受影响行数为 1,说明当前 worker 抢到了该任务;为 0 则已被其他 worker 抢占
        return cur.rowcount == 1
这种机制天然具备原子性,无需额外的锁管理,数据库引擎会在行级写锁保护下完成条件验证与写入。
2. 行级悲观锁:SELECT ... FOR UPDATE
若任务申领不仅需要修改状态,还需要连续检查关联的多表数据(例如配额校验、前置任务依赖),单条 UPDATE 无法囊括全部逻辑,此时应使用数据库行级悲观锁:
from sqlalchemy.orm import Session
from models import Task

def process_task_with_pessimistic_lock(session: Session, task_id: int):
    # with_for_update 加上排他行锁,SKIP LOCKED 可让并发 worker 跳过锁定行寻找下一个任务
    task = session.query(Task).filter(Task.id == task_id).with_for_update(skip_locked=True).first()
    if not task:
        return None  # 任务不存在或正被其他 Worker 处理中

    if task.status == 'PENDING':
        task.status = 'RUNNING'
        session.commit()
        return task
    return None
配合 skip_locked=True(PostgreSQL / MySQL 8.0+ 支持),各个 Worker 可以并行扫描任务表而不会相互阻塞挂起,大幅提升吞吐量。
3. 版本号乐观锁(Optimistic Locking)
对于任务进度上报、多步骤参数追加等高频修改场景,悲观锁会导致严重的事务等待。此时可以在任务表增加 version 字段:
def update_task_progress(session: Session, task_id: int, new_progress: int, current_version: int) -> bool:
    rows = session.query(Task).filter(
        Task.id == task_id,
        Task.version == current_version
    ).update({
        Task.progress: new_progress,
        Task.version: Task.version + 1
    })
    session.commit()
    return rows == 1  # 为 0 则说明版本已被其他操作并发递增,调用方可选择重试
三、分布式协调与幂等执行流程
在跨微服务或跨队列架构中,数据库往往不作为任务队列的核心媒介(例如使用 RabbitMQ 或 Kafka)。此时需要将“分布式锁”与“幂等执行”结合起来控制冲突。
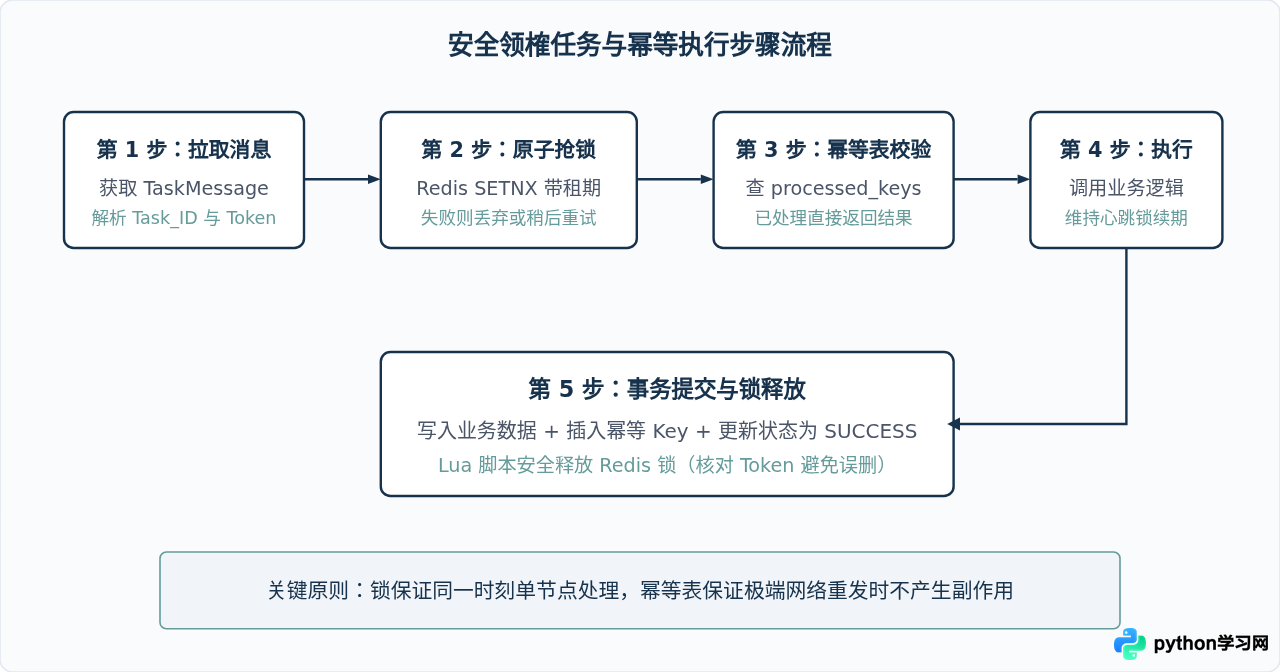
实战:基于 Redis 的安全分布式锁
单纯使用 SETNX 容易产生死锁(Worker 崩溃无法释放)或误删锁(Worker 执行过久锁自动超时,被后续节点获得后被前节点删除)。在 Python 中应使用带随机 UUID 的原子设置,并搭配 Lua 脚本进行归属验证:
import uuid
import redis

r = redis.Redis(host='localhost', port=6379, db=0)

# 安全释放锁的 Lua 脚本:只有键值与当前 token 相同时才执行 del
RELEASE_LOCK_LUA = """
if redis.call("get", KEYS[1]) == ARGV[1] then
    return redis.call("del", KEYS[1])
else
    return 0
end
"""

class DistributedTaskLock:
    def __init__(self, task_id: str, expire_seconds: int = 30):
        self.lock_key = f"lock:task:{task_id}"
        self.token = str(uuid.uuid4())
        self.expire = expire_seconds

    def acquire(self) -> bool:
        # NX: 键不存在时才设置; EX: 超时时间(秒)
        return bool(r.set(self.lock_key, self.token, nx=True, ex=self.expire))

    def release(self):
        r.eval(RELEASE_LOCK_LUA, 1, self.lock_key, self.token)
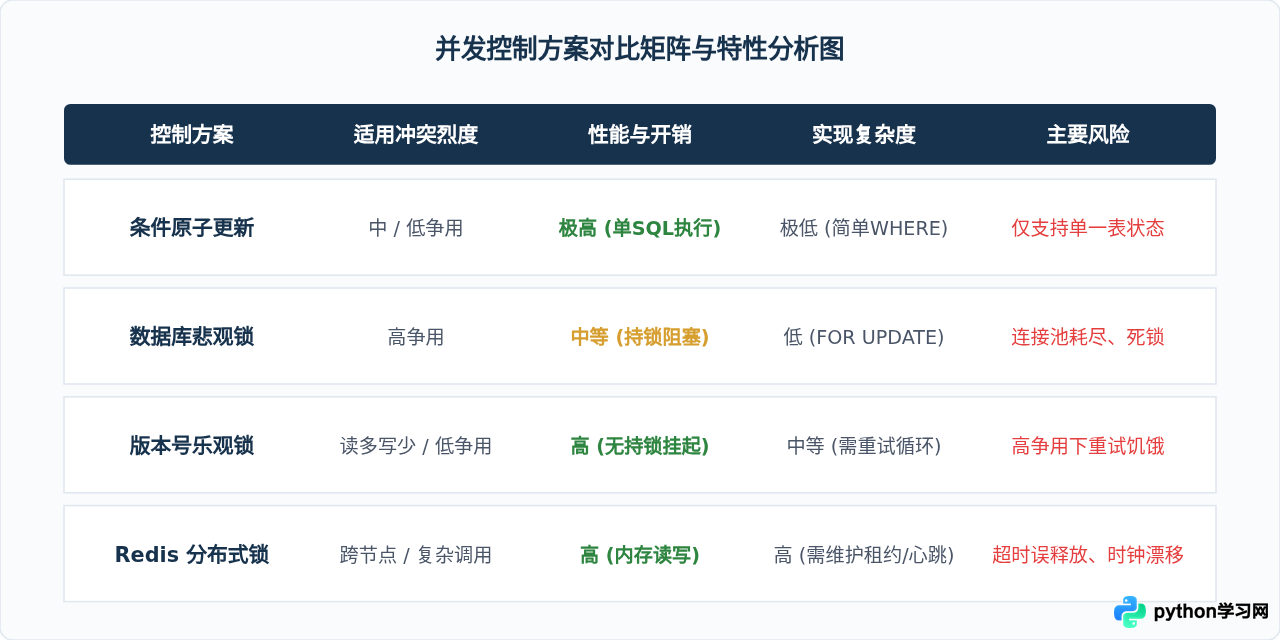
四、四种并发控制方案全方位对比
在实际系统开发中,没有适用于所有场景的“银弹”。开发者需要根据系统吞吐量、节点分布、事务复杂度来选择合适的控制方案:
五、架构选型决策与落地总结
为了在实际 Python 系统中快速选型,可以遵循以下决策路径:
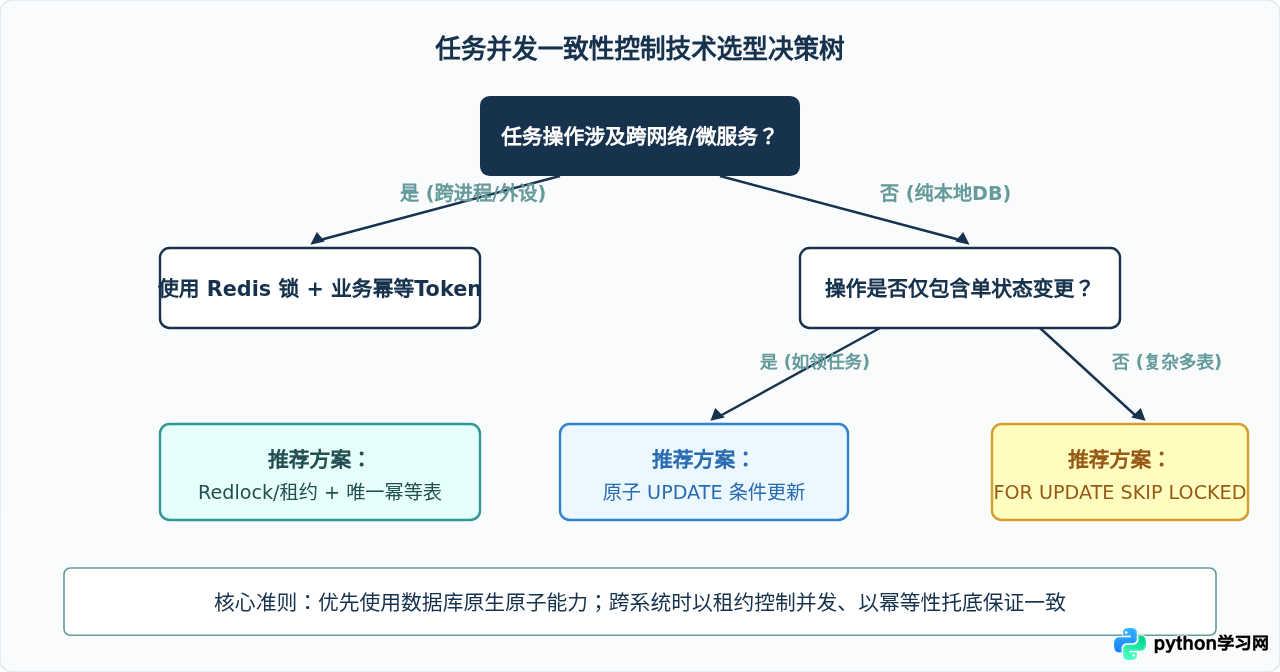
总结而言,在 Python 任务管理系统开发中保证数据一致性与解决并发冲突,应当采取分层递进的策略:
- 不要依赖 Python 应用内存保证一致性:多进程、GIL 切换以及分布式节点使得应用层内存检查完全不可靠,判断必须推给具备原子能力的存储组件(数据库或 Redis)。
- 轻量级状态流转使用原子条件更新:状态变更(如
PENDING -> RUNNING)直接用带有WHERE status = 'PENDING'的 SQL 语句,避免无谓的显式锁开销。 - 任务队列消费采用 SKIP LOCKED:使用数据库充当队列时,
FOR UPDATE SKIP LOCKED既能杜绝重复消费,又消除了节点间的锁排队等待。 - 分布式任务辅以带租约的分布式锁:外部复杂长耗时调用使用 Redis 分布式锁,配合 Watchdog 机制维持租期。
- 所有可能重试的节点均建立幂等保护:网络波动与进程崩溃不可避免,通过数据库唯一索引或幂等日志表,确保任务即使被重复调度执行,产生的最终业务状态依然恒定正确。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















