


Python自动化平台开发中怎么解决高并发任务冲突
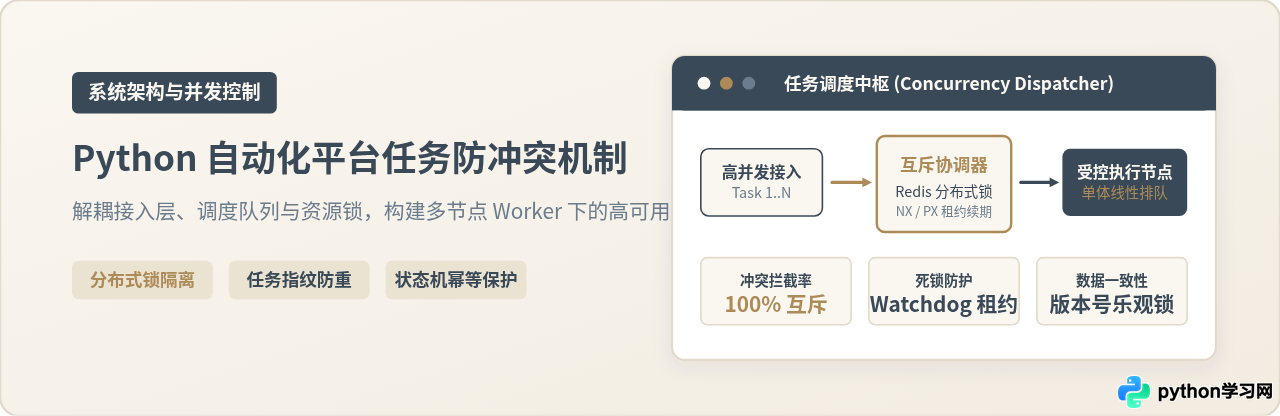
针对Python自动化平台在多Worker高并发场景下的任务冲突问题,系统剖析物理资源抢占、重复触发和数据覆写的成因,并提供任务指纹防重、Redis分布式锁与租约续期、队列隔离及数据库乐观锁等落地解决方案与完整代码实现。
一、高并发场景下任务冲突的三大根因剖析
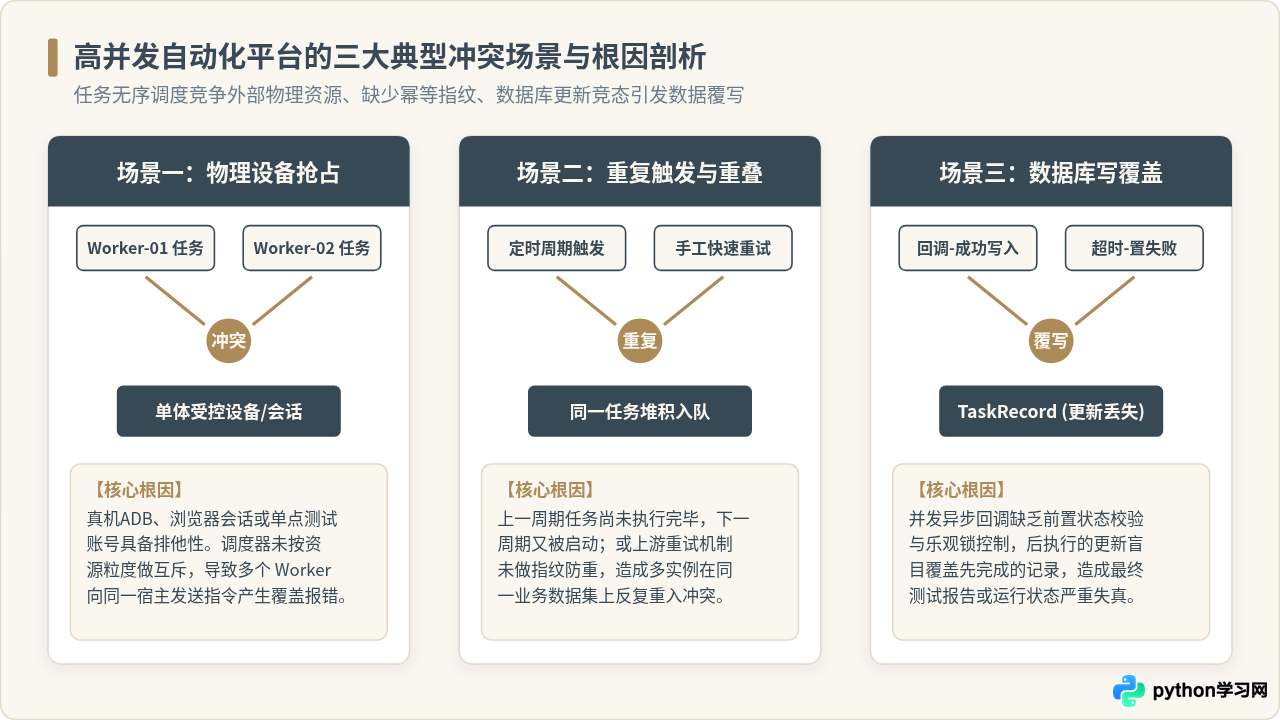
在典型的自动化测试、运维批量巡检或RPA自动化平台中,后端调度系统通常采用分布式架构部署(如Celery多进程Worker、FastAPI结合Redis队列或K8s容器化副本)。当任务调度量暴增或上游定时作业扎堆触发时,冲突往往集中在以下三个典型层面:
- 物理与受控资源的排他性争抢:自动化脚本往往依赖外部不可瞬时复制的实体资源,例如真实的移动端测试机(ADB连接)、固定的远程浏览器WebDriver节点、独占的系统管理员登录账号等。若调度器不对这些资源做排他标记,两个并行的Worker可能同时向同一部手机发送按键指令,导致测试界面被中断甚至系统崩溃。
- 定时重叠与重试风暴引发的重复入队:某个耗时较长的数据同步或端到端拨测任务尚未完成,定时调度器又按照既定周期触发了下一次执行;或者上游因网络短暂抖动发起了重试请求,导致同一批测试集同时存在多个运行中的实例,造成重复执行与外部数据污染。
-
异步回调并发写引发的更新丢失(Lost Update):自动化执行器在向持久层回写任务状态、日志片段与测试用例报告时,若多个异步协程或子任务同时对同一条主任务记录执行无差别
UPDATE,后提交的事务极易覆盖先完成的正确结果,导致最终状态失真。
初学者常尝试使用 Python 标准库中的 threading.Lock 或 asyncio.Lock 来避免冲突。但在现代自动化平台中,应用通常采用 Gunicorn 多工作进程、Celery 分布式节点或多 Docker 容器运行,彼此拥有独立的内存空间与解释器进程。进程内锁无法跨越进程边界,必须借助中心化协调媒介(如 Redis 或数据库)进行跨进程互斥。
二、解决高并发任务冲突的核心实战步骤
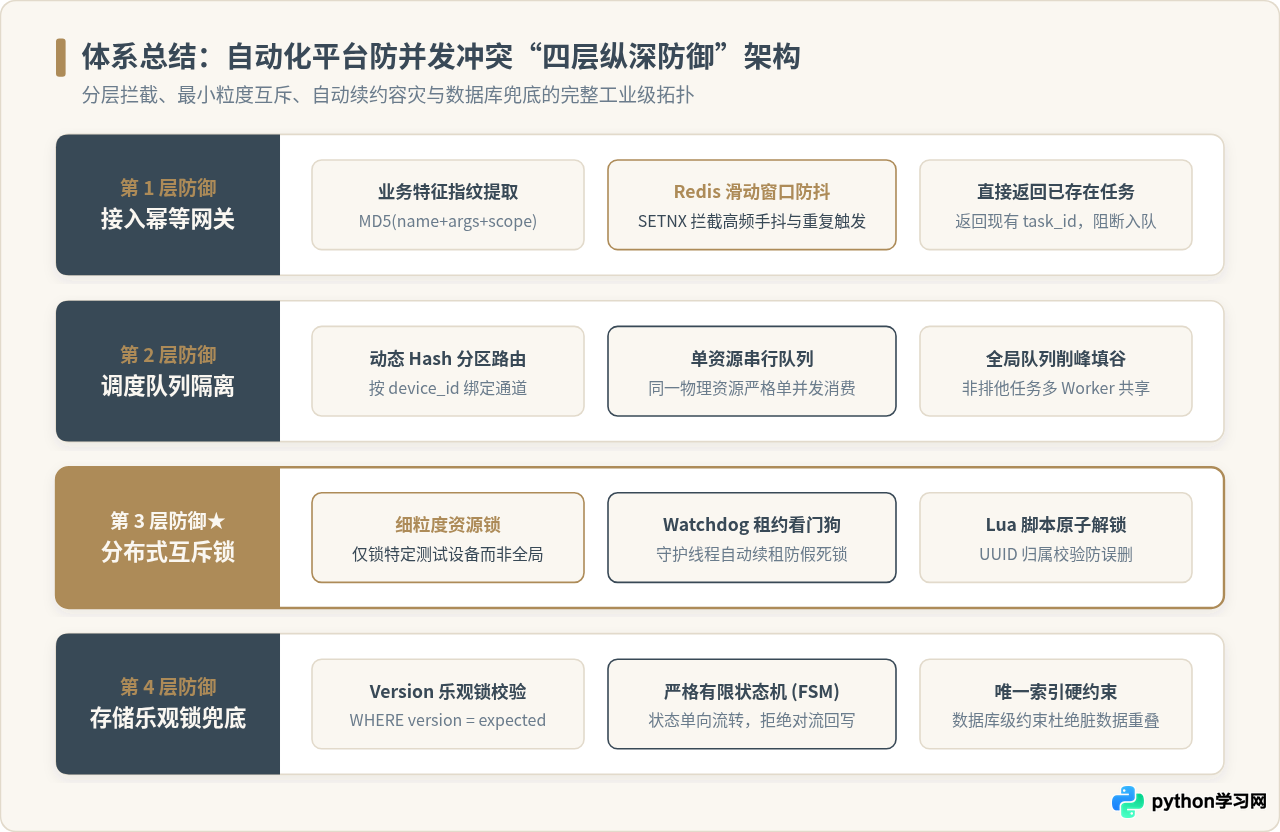
要彻底消除冲突,应遵循“由外及内、层层分流”的工程原则。下面按照任务从请求吸收到最终结果沉淀的完整生命周期,拆解标准实施步骤。
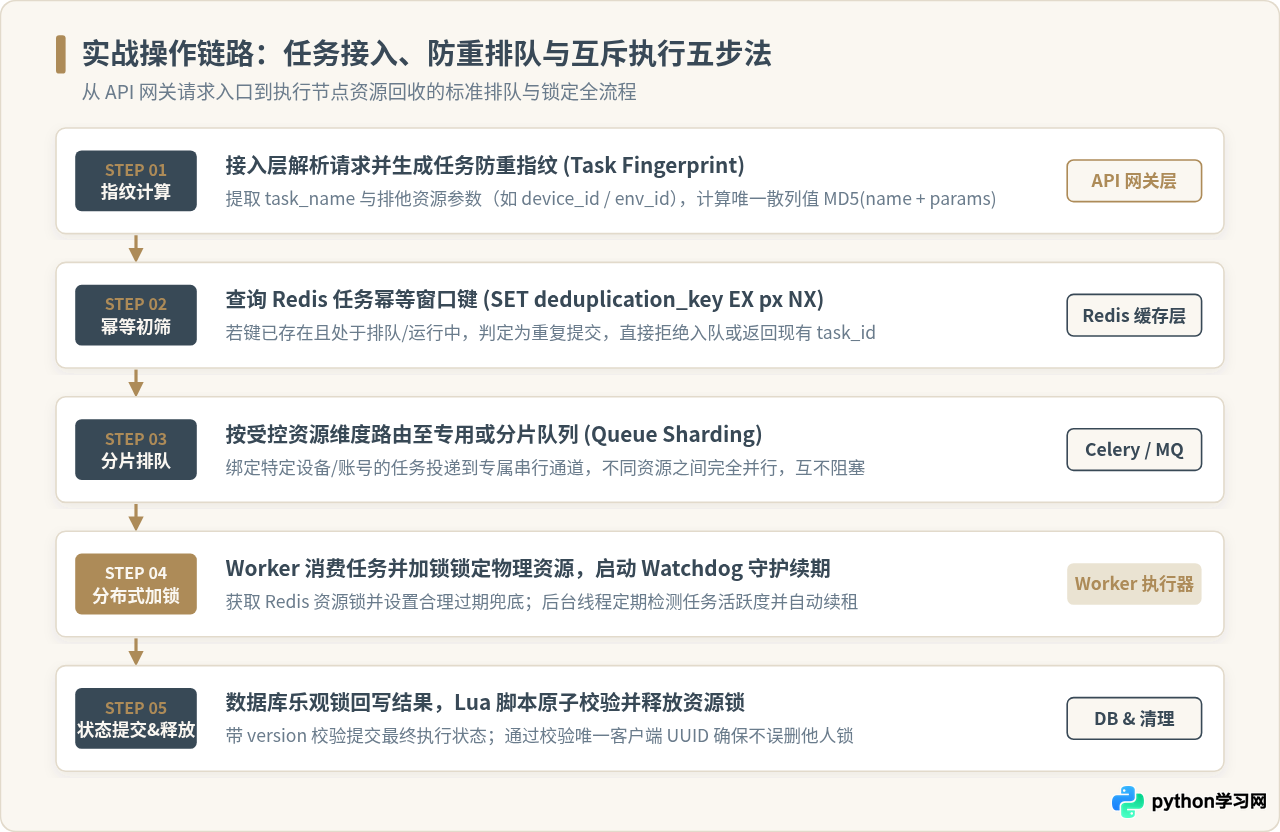
步骤一:计算任务指纹并在接入层拦截重复提交
在API网关或接入层,首先提取任务的业务唯一特征,组合生成“任务指纹”(Fingerprint)。例如,将任务名称、目标设备ID、执行参数按照键名字典序排序后进行哈希计算。
利用 Redis 的 SET key value EX seconds NX 指令,在接受请求的第一时间建立防抖窗口(如 30 秒或任务最大允许周期)。若键已存在,说明相同特征的任务已在排队或正在运行中,系统可直接返回现有任务ID或提示“任务排队中”,杜绝重复生成下游作业。
步骤二:按照排他资源进行队列分片与串行隔离
避免让所有任务混在一个无差异的公共队列中由全局Worker自由竞争抢占。更好的做法是按照“互斥资源维度”构建分片队列(Sharded Queues)。
例如,平台管理着编号为 device_01 至 device_10 的10台真机,那么就应为每个设备分配独立的队列键名,或者使用 Celery 的 routing_key 进行分发。针对 device_01 的全部测试任务在入队时便被精确投递到专属于它的队列中,由绑定该设备的专属 Worker 单线程线性消费。这种架构设计直接从调度源头上消除了锁竞争开销。
步骤三:在执行层实施健壮的分布式锁与租约续期
对于无法提前静态分片或者资源动态绑定的场景,Worker 在从队列取出任务后、执行真正自动化逻辑前,必须向 Redis 请求资源锁。锁必须具备三个核心特征:
- 原子性获取与过期兜底:使用
SET resource_key client_uuid NX PX timeout,保证同一时刻仅有一个 Worker 能拿到锁,并附带超时时间以防 Worker 进程崩溃产生死锁。 - 后台看门狗(Watchdog)自动续期:自动化脚本执行时长具有波动性。如果为了防止死锁将过期时间设得太短,可能脚本还没跑完锁就自动失效,导致其他 Worker 乘虚而入;若设得太长,崩溃恢复成本过高。因此需开启守护线程,在任务正常运行时定期为锁延长有效期(Renew Lease)。
- 原子性安全释放(Lua 脚本校验):释放锁时必须核验 Redis 中的 value 是否仍然是自己持有的
client_uuid,严禁使用盲目DEL,以防误删已经由于偶发超时被其他进程持有的新锁。
三、执行层生产级分布式锁的 Python 实现
以下给出一个包含原子加锁、心跳守护续期与 Lua 安全释放的生产级 Python 方案。该模块可直接封装为上下文管理器,供自动化任务执行器无缝调用:
import time
import uuid
import threading
import logging
import redis

logger = logging.getLogger("TaskLockManager")

class RedisResourceLock:
    """
    高并发自动化平台专用的分布式资源锁
    支持自动看门狗续期与 Lua 安全原子释放
    """
    RELEASE_LUA = """
    if redis.call("get", KEYS[1]) == ARGV[1] then
        return redis.call("del", KEYS[1])
    else
        return 0
    end
    """

    def __init__(self, redis_client: redis.Redis, resource_name: str,
                 lease_ms: int = 10000, heartbeat_interval_s: float = 3.0):
        self.client = redis_client
        self.key = f"lock:resource:{resource_name}"
        self.lease_ms = lease_ms
        self.heartbeat_interval = heartbeat_interval_s
        self.lock_token = str(uuid.uuid4())
        self._renew_thread = None
        self._stop_renew = threading.Event()
        self._release_script = self.client.register_script(self.RELEASE_LUA)

    def acquire(self, timeout_s: float = 5.0) -> bool:
        start_time = time.time()
        while time.time() - start_time < timeout_s:
            # 使用 NX PX 指令实现互斥加锁与超时兜底
            acquired = self.client.set(self.key, self.lock_token, nx=True, px=self.lease_ms)
            if acquired:
                self._start_watchdog()
                logger.info(f"成功获取资源锁 [{self.key}], token: {self.lock_token}")
                return True
            time.sleep(0.1)  # 适当休眠后重试
        return False

    def _start_watchdog(self):
        """后台守护线程:定期续租以防长任务被意外释放"""
        self._stop_renew.clear()
        def watchdog_loop():
            while not self._stop_renew.wait(self.heartbeat_interval):
                # 只有当前锁 token 匹配时才续约
                check_script = """
                if redis.call("get", KEYS[1]) == ARGV[1] then
                    return redis.call("pexpire", KEYS[1], ARGV[2])
                else
                    return 0
                end
                """
                res = self.client.eval(check_script, 1, self.key, self.lock_token, self.lease_ms)
                if not res:
                    logger.warning(f"续约失败,锁已被抢占或过期: {self.key}")
                    break

        self._renew_thread = threading.Thread(target=watchdog_loop, daemon=True)
        self._renew_thread.start()

    def release(self):
        """终止看门狗并执行原子解锁"""
        self._stop_renew.set()
        if self._renew_thread and self._renew_thread.is_alive():
            self._renew_thread.join(timeout=1.0)

        # 必须使用 Lua 脚本比对 token,确保不误删别人持有的锁
        result = self._release_script(keys=[self.key], args=[self.lock_token])
        logger.info(f"释放锁 [{self.key}] 结果: {result}")
        return bool(result)

    def __enter__(self):
        if not self.acquire():
            raise RuntimeError(f"无法获取资源锁 [{self.key}], 存在并发冲突")
        return self

    def __exit__(self, exc_type, exc_val, exc_tb):
        self.release()
在 Celery 或自定义 Worker 中使用时,代码只需保持清晰的结构:
from distributed_lock import RedisResourceLock
import redis

r_client = redis.Redis(host="127.0.0.1", port=6379, db=0)

def run_device_automation_task(task_id: str, device_id: str):
    logger.info(f"收到执行指令,准备锁定设备: {device_id}")

    try:
        # 尝试对特定设备资源加锁,限制竞争粒度
        with RedisResourceLock(r_client, resource_name=device_id, lease_ms=8000):
            logger.info(f"成功独占设备 {device_id},开始执行自动化脚本...")
            # 模拟执行测试脚本逻辑
            execute_test_suite(task_id, device_id)
            logger.info(f"自动化用例执行完毕,退出代码块自动释放锁")
    except RuntimeError as err:
        logger.warning(f"任务 [{task_id}] 争抢设备 {device_id} 失败,延后重试或标记排队中: {err}")
        raise  # 触发队列的退避重试 (Exponential Backoff)
四、持久层数据库并发安全防护(乐观锁与状态机)
即使在执行层实施了分布式锁,当系统存在外部异步回调(如云测厂商回调、CI/CD管道钩子)、手动强制终止等旁路操作时,持久层数据库的状态更新依然可能发生并发覆写。必须在数据库层建立最后一道防线。
1. 基于版本号的乐观锁(Optimistic Locking)
在任务表 tasks 中增加一个整型字段 version。每次更新任务执行状态时,必须带上前置版本号比较:
-- 仅当数据库中的当前版本与内存读取到的预期版本一致时,才允许更新
UPDATE platform_tasks
SET
    status = 'SUCCESS',
    result_summary = '用例全量通过',
    version = version + 1,
    updated_at = NOW()
WHERE
    id = 'task_20261101_0089'
    AND version = 2;
如果受影响行数(affected rows)为 0,说明在当前事务执行期间,已有其他线程或回调先行修改了这条任务数据。此时系统可以捕获该异常,放弃陈旧的覆盖写,或者重新读取最新记录进行合并。
2. 单向有限状态机(Finite State Machine, FSM)
自动化任务的状态流转必须具备严格的单向约束,严禁随意任意跳转。典型合法路径为:
PENDING(排队中) ➔ RUNNING(执行中) ➔ SUCCESS / FAILED / TIMEOUT(终态)
在编写数据库更新代码时,应将前置合法状态作为 WHERE 条件的一部分。例如:进入 RUNNING 必须满足当前处于 PENDING;标记 TIMEOUT 必须满足处于 RUNNING。一旦任务进入了终态,任何迟到的中间状态回调都无法在数据库层面命中更新,彻底消除脏数据。
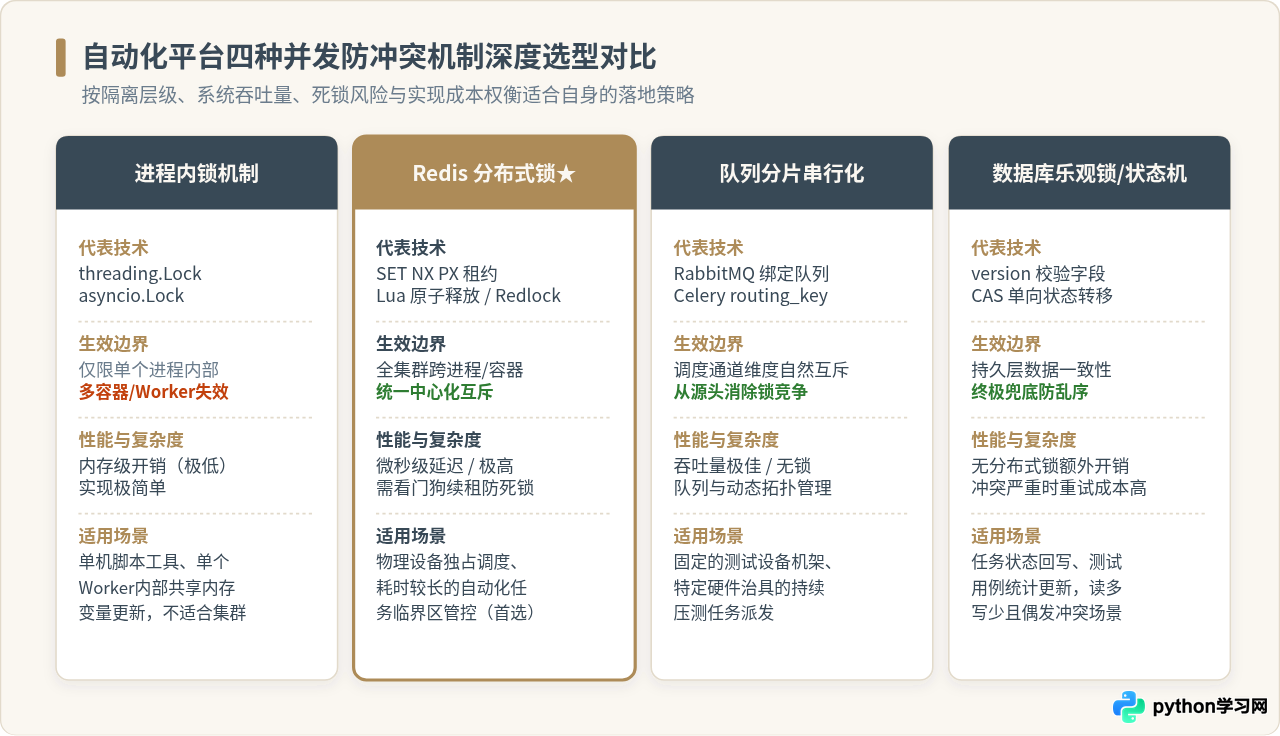
| 方案类型 | 控制边界 | 吞吐量影响 | 死锁风险 | 最适合的业务场景 |
|---|---|---|---|---|
| Redis 分布式锁 | 全集群跨节点 | 高(毫秒级调度开销) | 需租约超时与Watchdog防死锁 | 独占设备、单点账号、外设硬件的动态抢占 |
| 队列分片串行化 | 消息中间件层 | 极高(完全无锁化) | 极低(无锁死隐患) | 已知固定受控硬件机架、设备池的平稳调度 |
| 数据库乐观锁 | 持久化记录层 | 中(写冲突严重时重试耗资源) | 零(不阻塞数据库连接) | 任务进度回写、状态机变更、报告汇总持久化 |
| 进程内互斥锁 | 单工作进程 | 极高(内存级) | 代码不当可能永久挂起 | 单节点内部共用全局变量,不适合多机架构 |
五、生产环境落地实施的四大关键避坑建议
避免将锁键设置为如 lock:platform:auto_test 这样的全局大锁。锁的粒度越细,系统并发性能越高。应将锁细化至“最小不可拆分物理资源”,例如 lock:device:serial_9876 或 lock:user_session:1042,确保不同设备上的用例能够全并行推进。
抢锁失败时,绝不要使用紧凑的 while True: pass 空转循环,这会迅速打满 CPU 并压垮 Redis。应加入随机抖动退避(如 time.sleep(0.05 + random.uniform(0, 0.05))),并在达到最大重试次数后主动放弃并转入延迟队列。
若执行 Worker 被宿主机 OOM-Killer 杀死或网络断连,Watchdog 线程自然终止。Redis 上的键将在租约超时(lease_ms)后自动过期。平台需具备死信检测机制,自动识别那些长时间处于 RUNNING 却已失去 Redis 活跃标记的任务,重置其状态或告警通知。
在高并发运行期间,必须对“任务抢锁耗时”、“加锁失败次数”以及“重试等待时长”打点监控。当某个资源的锁争抢等待时长持续上升时,说明该硬件资源已成为测试流水线的瓶颈,应及时扩充硬件节点或动态调整调度权重。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















