


Python连接SQLite数据库完整代码实例:增删改查操作演示
使用Python内置sqlite3模块连接SQLite数据库的完整实践教程,包含创建数据表、插入数据、查询数据、修改数据与删除数据的完整代码实例与避坑指南。
在Python中开发本地应用程序、小型工具或处理离线数据时,SQLite通常是最理想的数据库选择。Python标准库自带的 sqlite3 模块无需额外部署独立数据库服务,仅靠单个磁盘文件即可完成高可靠的关系型数据存储。本文将通过可直接运行的完整代码实例,系统演示如何从零开始建立连接、设计表结构,并逐一落实增(Insert)、删(Delete)、改(Update)、查(Select)四大基础核心操作。
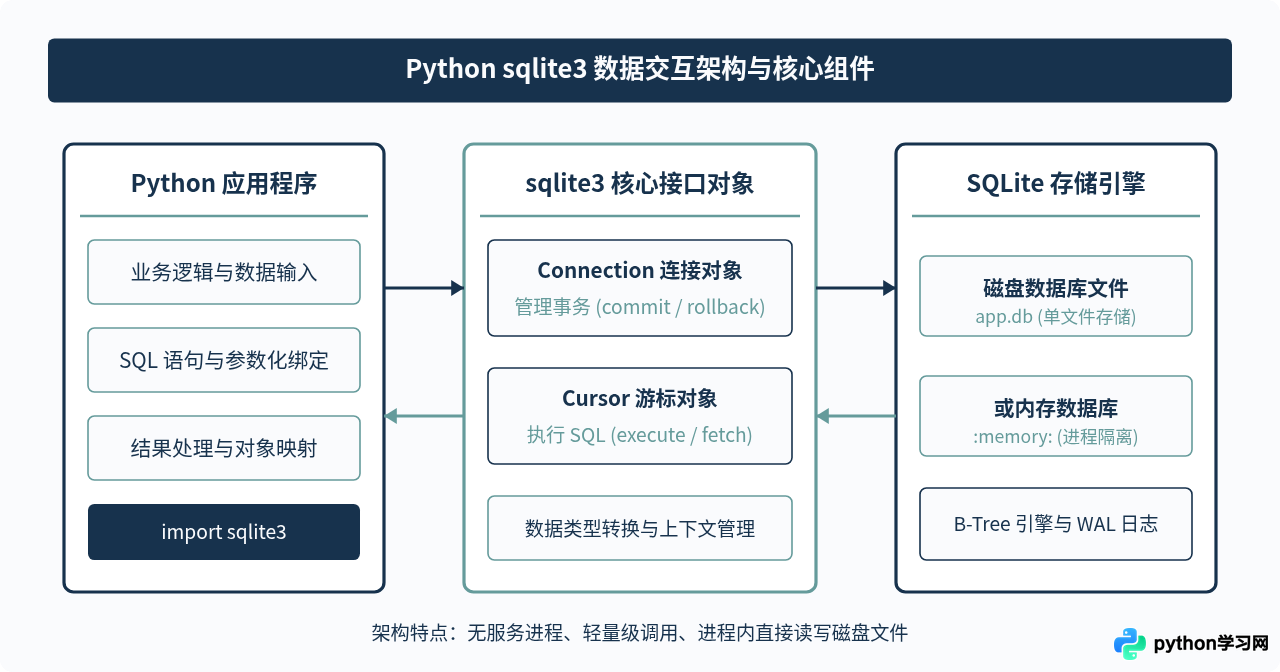
一、准备工作:连接数据库与创建游标
使用SQLite时,首要工作是通过 sqlite3.connect() 指定数据库文件。如果指定的数据库文件在磁盘上尚不存在,系统会自动在对应路径创建该文件。建立连接之后,程序需要创建游标(Cursor)对象来负责具体SQL命令的派发与执行。
为了让每次查询返回的结果支持像字典一样通过字段名读取(而不是只能通过数字索引解包元组),推荐设置连接的 row_factory = sqlite3.Row。
import sqlite3

# 1. 建立连接(若 demo.db 不存在则会自动创建)
conn = sqlite3.connect("demo.db")

# 2. 优化:允许通过字段名获取查询数据
conn.row_factory = sqlite3.Row

# 3. 创建执行游标
cursor = conn.cursor()

print("数据库连接成功,游标已创建!")
执行完成后,当前目录下将生成 demo.db 文件。若仅用于单元测试或临时计算,可将路径换为 ":memory:",数据库便会完全保存在内存中,程序退出后自动释放。
二、创建数据表(DDL操作)
在存储数据之前,必须先规划并创建表结构。我们以常见的“用户表(users)”为例,包含用户编号(自增主键)、姓名、电子邮箱及账户状态。
create_table_sql = """
CREATE TABLE IF NOT EXISTS users (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    name TEXT NOT NULL,
    email TEXT UNIQUE NOT NULL,
    status TEXT DEFAULT 'active'
);
"""

cursor.execute(create_table_sql)
conn.commit()
print("数据表 users 检查/创建成功!")conn.commit() 提交事务,否则改动可能未落盘。
三、数据库增删改查标准操作流程
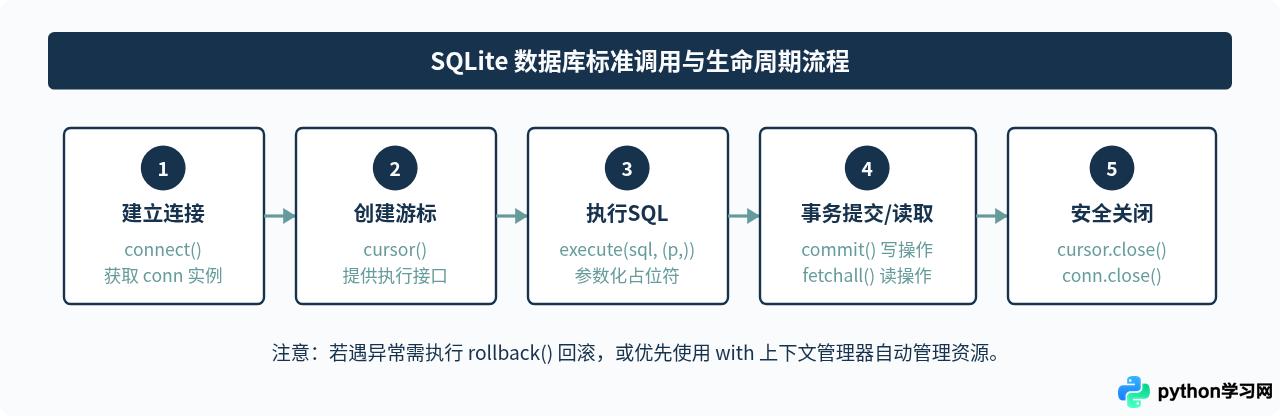
在对SQLite执行增删改查时,应严格遵循标准工作流:从获取连接开始,准备参数化SQL,执行后按需提交事务,并最终妥善关闭资源。规范的流程是避免锁库和连接泄露的关键。
四、插入数据(Create / Insert)
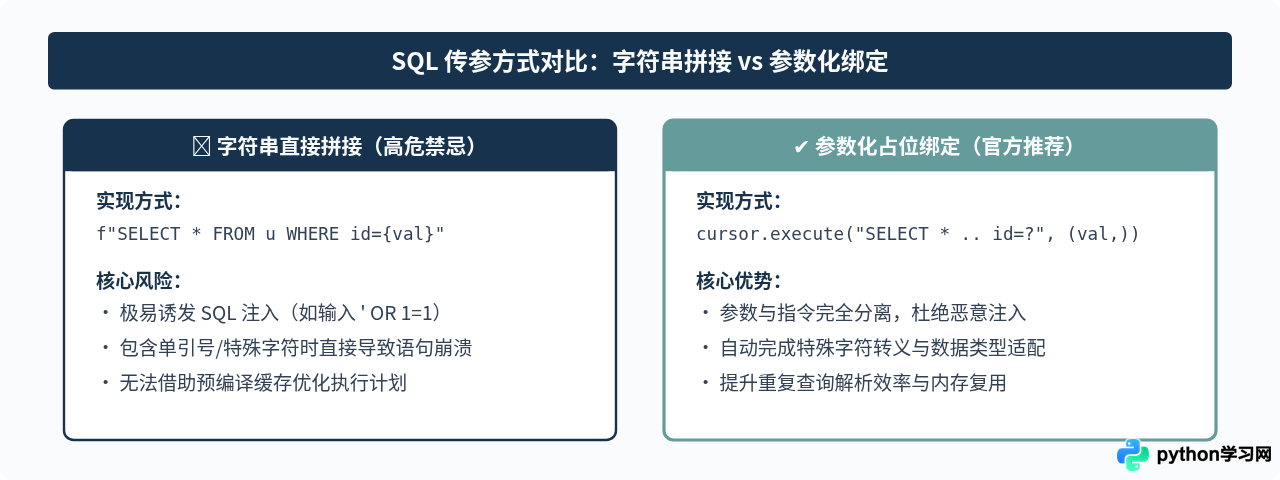
插入操作分为单条插入与批量插入。在传入数据时,切忌使用字符串拼接(如 f-string 或 % 格式化),必须使用问号 ? 占位符进行参数绑定,以规避 SQL 注入攻击。
1. 单条记录插入
# 单条插入:传入元组作为参数
insert_sql = "INSERT INTO users (name, email, status) VALUES (?, ?, ?)"
cursor.execute(insert_sql, ("张三", "zhangsan@example.com", "active"))
conn.commit()

print(f"成功插入单条记录,生成的自增ID为: {cursor.lastrowid}")
2. 批量记录插入
当需要一次性写入多条数据时,使用 executemany() 可以大幅减少事务开销,提升执行效率:
users_data = [
    ("李四", "lisi@example.com", "active"),
    ("王五", "wangwu@example.com", "inactive"),
    ("赵六", "zhaoliu@example.com", "active")
]

cursor.executemany(insert_sql, users_data)
conn.commit()
print(f"批量插入完成,本次受影响行数: {cursor.rowcount}")
五、查询数据(Read / Select)
查询数据不会更改数据库状态,因此无需调用 commit()。执行查询后,可以通过游标提供的读取方法提取结果集:
cursor.fetchone():获取下一行数据,没有更多数据时返回None。cursor.fetchall():获取符合条件的所有剩余行,返回列表。cursor.fetchmany(size):分批提取指定数量的行。
# 1. 查询全部活跃用户
query_sql = "SELECT id, name, email, status FROM users WHERE status = ?"
cursor.execute(query_sql, ("active",))

all_active = cursor.fetchall()
print(f"共查询到 {len(all_active)} 位活跃用户:")
for row in all_active:
    # 借助 sqlite3.Row,可以通过列名直接访问
    print(f"ID: {row['id']} | 姓名: {row['name']} | 邮箱: {row['email']}")

# 2. 单条查询(根据唯一邮箱查询)
cursor.execute("SELECT * FROM users WHERE email = ?", ("zhangsan@example.com",))
user = cursor.fetchone()
if user:
    print(f"\n找到张三记录:ID={user['id']}, 状态={user['status']}")
六、更新数据(Update)
更新数据用于修改既有行的数据值。通过 WHERE 子句锁定目标行,并通过 cursor.rowcount 验证修改实际影响的记录数量。
update_sql = "UPDATE users SET status = ? WHERE name = ?"
cursor.execute(update_sql, ("suspended", "王五"))
conn.commit()

print(f"更新操作成功,受影响行数: {cursor.rowcount}")
七、删除数据(Delete)
删除操作根据特定条件清除指定记录。务必带上精确的 WHERE 条件,防止误清空全表。
delete_sql = "DELETE FROM users WHERE email = ?"
cursor.execute(delete_sql, ("zhaoliu@example.com",))
conn.commit()

print(f"删除记录成功,被删除行数: {cursor.rowcount}")
八、SQL拼接防范与参数化绑定对比
许多初学者容易忽视 SQL 注入风险,直接将用户变量拼接进 SQL 语句中。下面两组实现方式展现了直接拼接与参数化绑定的根本差异:
九、完整整合代码实例
下面是一个封装好的完整独立脚本,涵盖建表、增、删、改、查全链路操作,并结合了 try...finally 块确保资源正常释放:
import sqlite3

def run_sqlite_crud_demo():
    db_file = "app_demo.db"
    conn = None

    try:
        # 1. 建立连接并配置结果集属性
        conn = sqlite3.connect(db_file)
        conn.row_factory = sqlite3.Row
        cursor = conn.cursor()

        # 2. 创建数据表
        cursor.execute("""
            CREATE TABLE IF NOT EXISTS products (
                id INTEGER PRIMARY KEY AUTOINCREMENT,
                title TEXT NOT NULL,
                price REAL NOT NULL,
                stock INTEGER DEFAULT 0
            );
        """)
        conn.commit()
        print("[1] 表结构检查/初始化完毕")

        # 3. 增 (Insert) - 单条与多条
        cursor.execute("INSERT INTO products (title, price, stock) VALUES (?, ?, ?)",
                       ("机械键盘", 399.00, 50))

        batch_products = [
            ("无线鼠标", 129.50, 100),
            ("4K显示器", 1899.00, 20),
            ("降噪耳机", 699.00, 35)
        ]
        cursor.executemany("INSERT INTO products (title, price, stock) VALUES (?, ?, ?)",
                          batch_products)
        conn.commit()
        print(f"[2] 新增数据成功,当前新增产品数: {1 + len(batch_products)}")

        # 4. 查 (Select) - 读取并打印商品清单
        cursor.execute("SELECT * FROM products WHERE price > ? ORDER BY price DESC", (200.0,))
        rows = cursor.fetchall()
        print(f"\n[3] 查询单价高于 200 元的商品列表:")
        for item in rows:
            print(f"    - ID: {item['id']} | 名称: {item['title']} | 单价: ¥{item['price']} | 库存: {item['stock']}")

        # 5. 改 (Update) - 更新机械键盘库存与单价
        cursor.execute("UPDATE products SET price = ?, stock = ? WHERE title = ?",
                       (369.00, 45, "机械键盘"))
        conn.commit()
        print(f"\n[4] 修改商品数据成功,影响行数: {cursor.rowcount}")

        # 6. 删 (Delete) - 删除下架 4K显示器
        cursor.execute("DELETE FROM products WHERE title = ?", ("4K显示器",))
        conn.commit()
        print(f"[5] 删除指定商品成功,删除行数: {cursor.rowcount}")

        # 7. 最终核验剩余数据
        cursor.execute("SELECT id, title, price, stock FROM products")
        final_list = cursor.fetchall()
        print(f"\n[6] 最终库内剩余商品统计 ({len(final_list)} 项):")
        for p in final_list:
            print(f"    * [{p['id']}] {p['title']} - 现价: {p['price']} - 剩余库存: {p['stock']}")

    except sqlite3.Error as e:
        if conn:
            conn.rollback()
        print(f"数据库执行发生错误,事务已回滚: {e}")
    finally:
        if conn:
            cursor.close()
            conn.close()
            print("\n[7] 数据库连接已安全断开")

if __name__ == "__main__":
    run_sqlite_crud_demo()
十、核心要点与常见问题总结
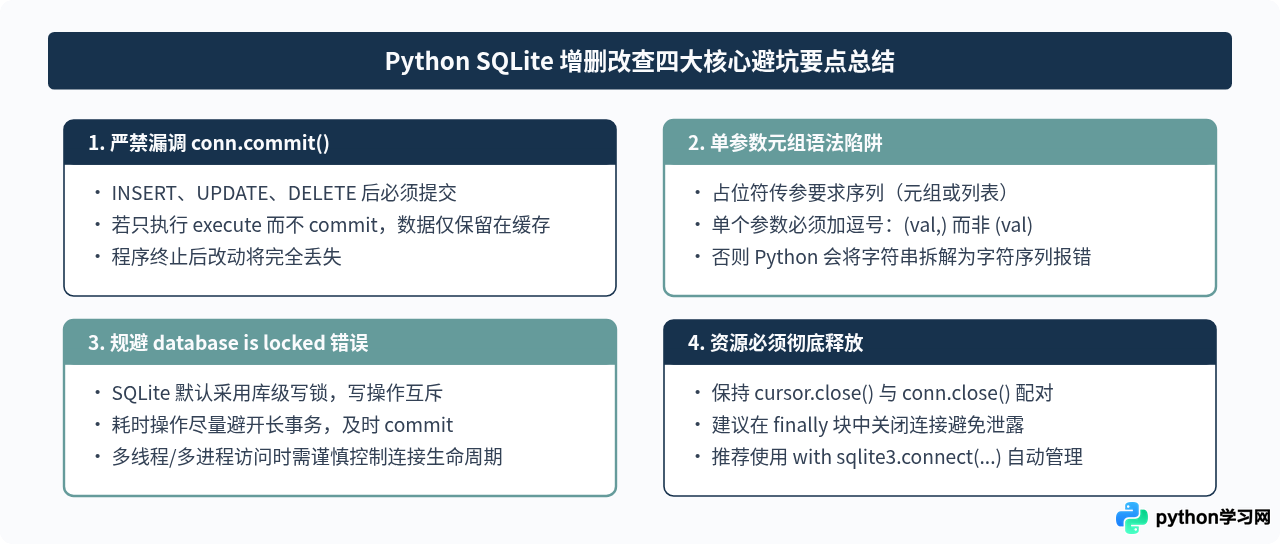
在日常使用 Python 操作 SQLite 时,牢记以下几项核心规程与最佳实践,能有效避免数据损坏、锁库及安全风险:
- 使用上下文管理器自动提交:
with conn:会在代码块正常结束时自动提交事务,发生异常时自动回滚,是编写高健壮性代码的利器。 - 使用
row_factory = sqlite3.Row: 让字段可通过名称提取(如row['name']),大幅提升代码可读性与后期重构安全性。 - 单值参数传参务必带逗号: 当 SQL 只有一个占位符时,传入参数必须写成包含单元素的元组
(param,),若写成(param)会被 Python 识别为普通括号运算,从而导致字符串拆解错误。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















