


Python全栈适用性:从Web开发到自动化脚本的多领域覆盖

Python的全栈适用性并非指它在每一个细分垂直技术栈上都能取得极限吞吐量,而是指它凭借高度一致的语法规范、强大的标准库以及丰富的工程生态,让开发者能够用同一套语言体系无缝串联Web服务端、后台API通信、数据库调度、系统运维以及桌面与网络自动化任务。本文将系统拆解Python在Web开发、自动化脚本与异步架构中的分工方式与协同实现,明确其落地场景与工程边界。
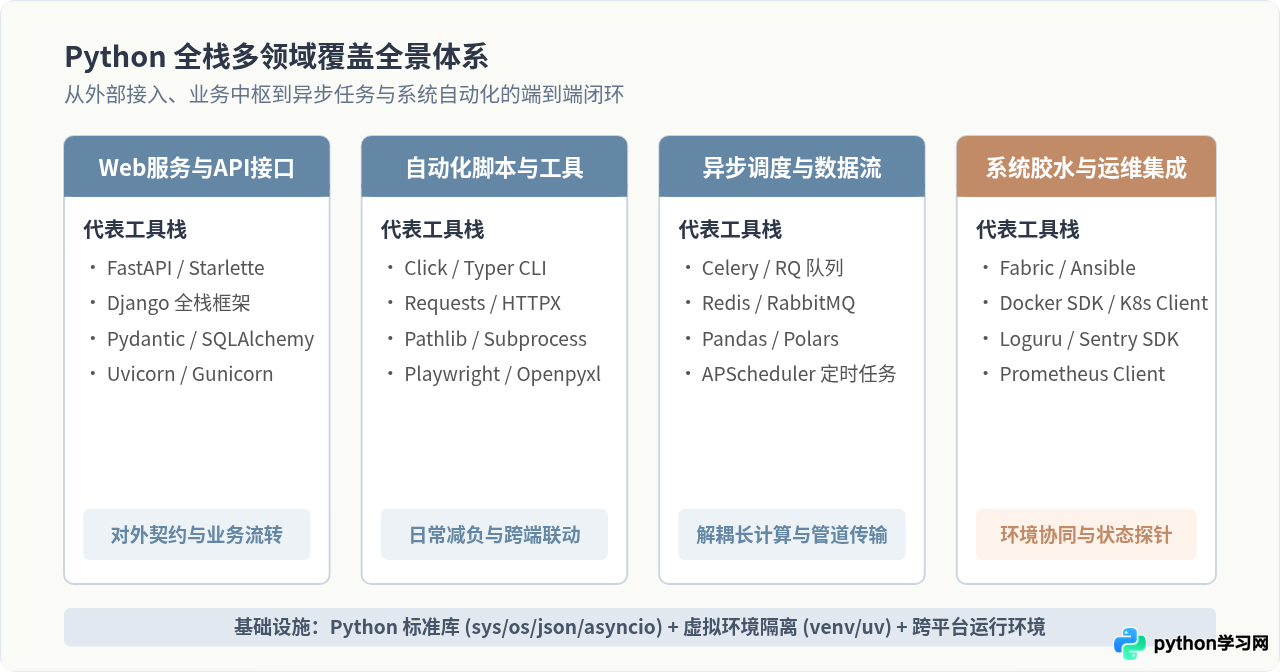
一、Web服务与API开发:从轻量微服务到企业级中枢
在Web开发领域,Python能够覆盖从极轻量的RESTful/GraphQL微服务接口,到包含权限、ORM模型与管理后台的企业级全功能系统。现代Python Web开发以两种主流路径为核心代表:
- FastAPI / Starlette 异步栈:基于Python原生
async/await语法和 Pydantic 类型系统,针对高频I/O读写、网关反向代理和现代前端单页应用(SPA)提供极高开发效率与自动化的OpenAPI交互文档。 - Django 全栈框架:提供高度集成的ORM、身份鉴权、迁移管理(Migrations)和内置管理后台(Admin),适合中大型数据驱动型管理系统,能够在最短时间内建立结构清晰的数据模型与安全屏障。
以下为一个典型的基于FastAPI的异步服务代码结构。该示例不仅处理HTTP请求并校验参数,同时演示了如何与底层数据层和后续的异步调度服务进行平滑对接:
# main.py - 现代化异步API服务示例
from fastapi import FastAPI, HTTPException, BackgroundTasks, status
from pydantic import BaseModel, Field
from typing import Optional
import uuid

app = FastAPI(title="任务集成管理服务", version="1.0.0")

class TaskCreateRequest(BaseModel):
    task_name: str = Field(..., min_length=2, max_length=50, description="任务名称")
    target_url: str = Field(..., description="需要自动化抓取或探测的目标地址")
    max_retries: int = Field(default=3, ge=1, le=5, description="最大失败重试次数")

class TaskResponse(BaseModel):
    task_id: str
    status: str
    message: str

def execute_automation_routine(task_id: str, target_url: str, retries: int):
    # 模拟在后台交由自动化逻辑处理,不阻塞主接口响应
    # 在生产环境中,此处通常直接分发至 Celery 任务队列
    import time
    time.sleep(1)
    # 记录执行日志与落库操作

@app.post("/api/v1/tasks", response_model=TaskResponse, status_code=status.HTTP_202_ACCEPTED)
async def create_task(payload: TaskCreateRequest, background_tasks: BackgroundTasks):
    task_id = str(uuid.uuid4())
    # 快速校验并提交后台异步逻辑
    background_tasks.add_task(
        execute_automation_routine,
        task_id=task_id,
        target_url=payload.target_url,
        retries=payload.max_retries
    )
    return TaskResponse(
        task_id=task_id,
        status="PENDING",
        message="自动化作业已成功接收入队,后台执行中"
    )
二、自动化脚本与系统工具:低成本解决碎片化需求
与Web开发偏重规范、路由与服务持久化不同,自动化脚本的核心诉求是快速编写、环境易得、容错强健与即开即用。Python之所以成为事实上的自动化标准语言,根源在于其标准库提供的系统级操作支持,以及极其成熟的第三方系统交互库:
- 文件与目录体系操作:使用
pathlib.Path取代过时的路径拼接,提供高可读性、跨操作系统的路径导航与批量文件匹配。 - 外部进程与CLI驱动:使用
subprocess.run可以安全捕获Shell输出、传参隔离,并处理标准错误流。 - 异构格式转换:通过
json、csv及openpyxl库,无需启动重量级桌面软件即可完成表格、结构化日志与数据库导出文件之间的双向转换。
一个健壮的自动化脚本不应只是简单按顺序执行几行指令,而必须包含防御性异常捕获与退出码管理。下面是一个符合生产规范的自动化数据同步脚本范例:
# sync_worker.py - 具备异常重试与日志记录的自动化脚本
import sys
import logging
from pathlib import Path
import httpx

logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(message)s",
    handlers=[logging.StreamHandler(sys.stdout)]
)

def run_sync_job(source_dir: Path, upload_endpoint: str) -> int:
    if not source_dir.exists() or not source_dir.is_dir():
        logging.error(f"源目录不存在或无效: {source_dir}")
        return 1

    target_files = list(source_dir.glob("*.json"))
    logging.info(f"在目录 {source_dir} 中发现 {len(target_files)} 个待同步文件")

    with httpx.Client(timeout=10.0) as client:
        for file_path in target_files:
            try:
                content = file_path.read_text(encoding="utf-8")
                response = client.post(upload_endpoint, json={"filename": file_path.name, "payload": content})
                response.raise_for_status()
                logging.info(f"成功上传文件: {file_path.name},状态码: {response.status_code}")
            except httpx.HTTPError as err:
                logging.warning(f"上传 {file_path.name} 失败: {err},跳过此文件并记录告警")
            except Exception as ex:
                logging.error(f"处理文件 {file_path.name} 时发生未知错误: {ex}")
                return 2

    logging.info("所有可处理文件执行完毕")
    return 0

if __name__ == "__main__":
    work_dir = Path("./data_queue")
    api_url = "https://internal.service.local/api/sync"
    exit_code = run_sync_job(work_dir, api_url)
    sys.exit(exit_code)
三、多领域协同架构:Web中枢与自动化任务的联动
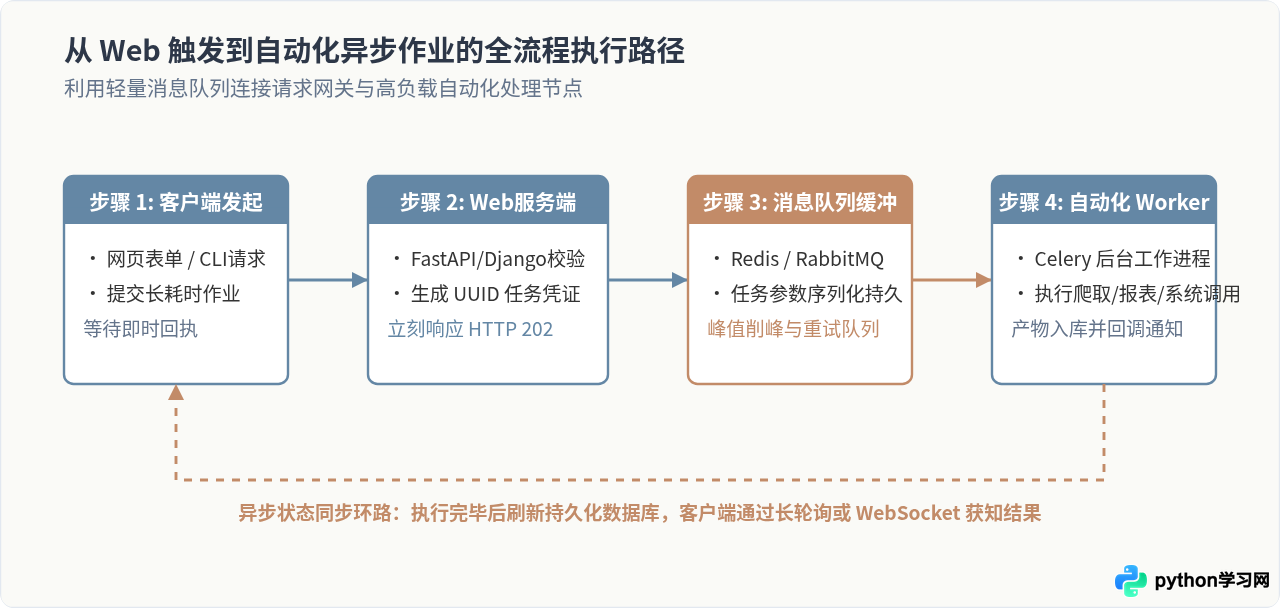
在实际企业应用中,Python的“全栈性”最直观的体现是Web端业务入口与自动化工作流之间的平滑解耦与联动。常见场景包括:用户在Web前端点击“导出十万条报表”或“触发跨云主机巡检”,该操作如果直接在Web服务请求线程内同步运行,会迅速耗尽HTTP连接并引发网关超时(如Nginx 504)。
标准解法是将Python Web服务作为“任务接纳中枢”,验证参数合法性后将作业放入消息队列(Redis/RabbitMQ),独立的Python Worker进程消费任务并调用自动化底层逻辑,执行完毕后通过数据库状态更新或WebSocket广播向用户呈现结果。
四、各技术维度的特性、选型与性能边界对比
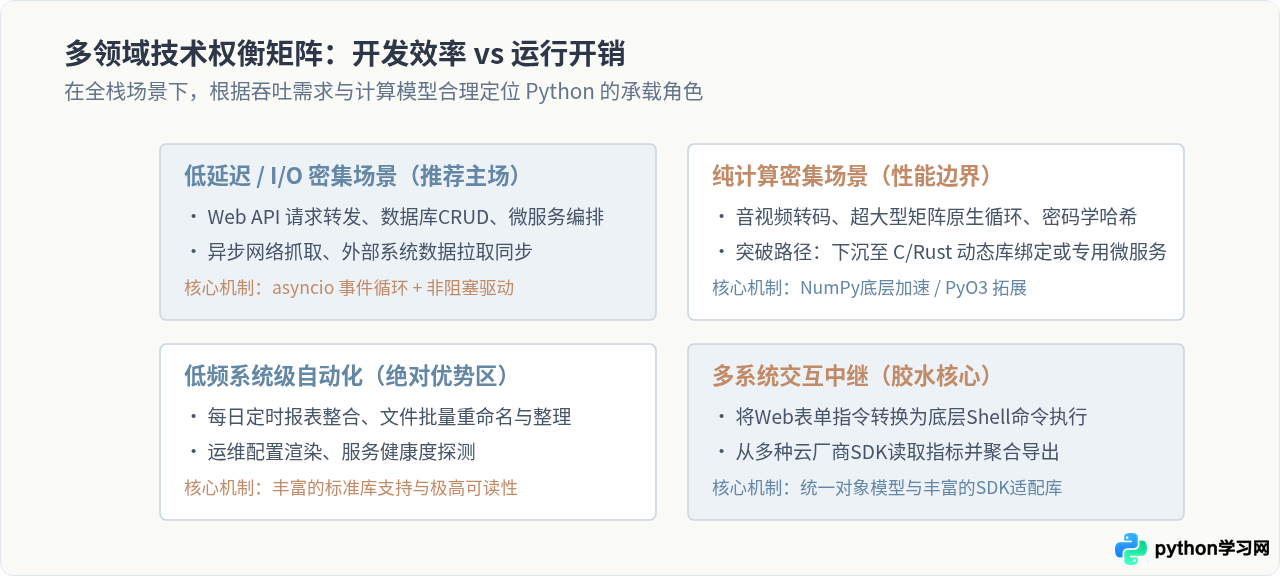
理解Python全栈适用性的前提,是理性认识其在各个领域的优势与边界。Python不是万能的银弹,在不同的开发模式下有着截然不同的权衡点:
| 应用领域 | 核心推荐技术栈 | 典型开发优势 | 关键技术边界与应对方案 |
|---|---|---|---|
| Web与API开发 | FastAPI, Django, Pydantic | 原型开发极快,ORM完善,文档自动生成,异步I/O吞吐出色 | CPU密集运算受制于GIL,单机高负载需多进程(Gunicorn Worker)部署 |
| 系统自动化脚本 | Click, Pathlib, Subprocess | 标准库开箱即用,免编译即可运行,能直接操控系统管道 | 复杂运行环境依赖易冲突,必须结合虚拟环境(venv)或独立容器运行 |
| 异步与任务调度 | Celery, Redis, RQ | 生态成熟,天然支持分布式多Worker横向扩容 | 任务状态跟踪消耗内存,需妥善规划任务超时阈值与死信队列机制 |
| 运维与异构胶水 | Fabric, Docker SDK, Paramiko | 统一跨平台API,屏蔽Linux/macOS/Windows底层细微差异 | 独立打包分发(如PyInstaller)体积偏大,冷启动速度慢于静态编译语言(Go/Rust) |
五、落地全栈能力时的工程化实践与决策演进
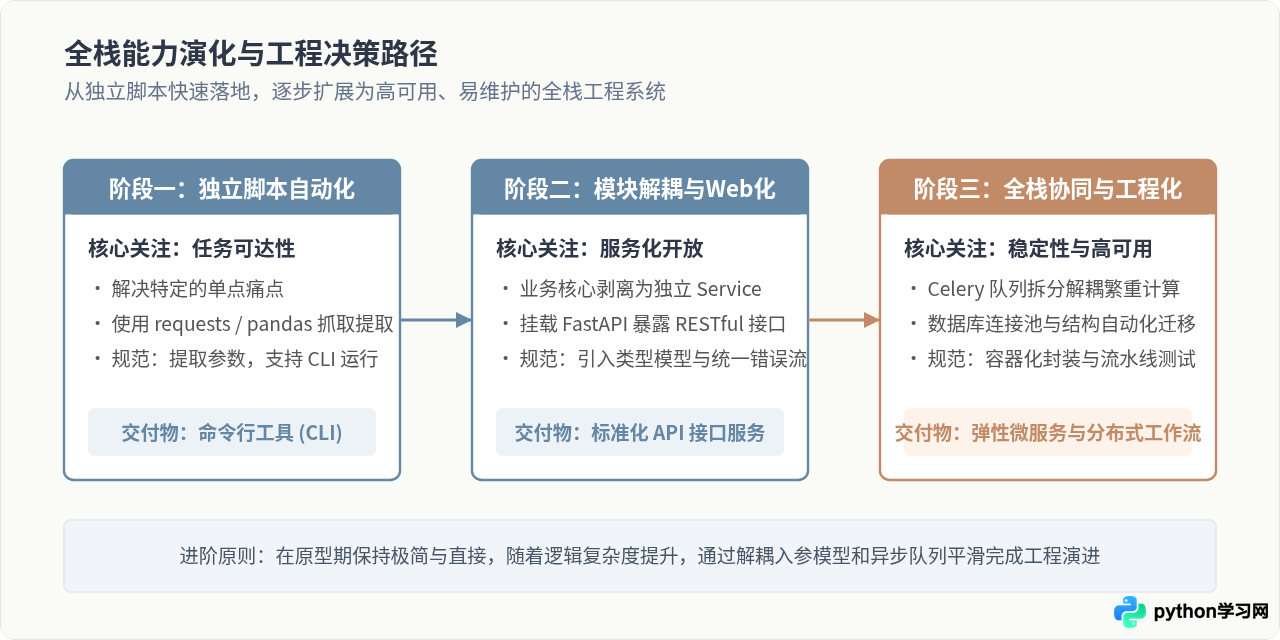
在实际团队或个人技术演进中,将Python从简单的“单一脚本工具”提升为“全栈系统支柱”,需要经历清晰的工程化升级。无序的代码累积容易导致“脚本写完即弃、Web依赖冲突、线上报错难以追踪”的困境。
1. 严格的依赖隔离:避免在系统全局Python环境中直接执行 pip install,使用 venv、uv 或 Docker 保证各项目依赖独立。
2. 类型提示(Type Hinting)与静态校验:在跨函数传递字典与数据模型时,必须使用 typing 与 Pydantic,避免脚本随着规模扩大变成维护黑洞。
3. 通用逻辑与入口分离:将核心的数据提取、算法与接口调用封装在独立的类或模块中。Web路由文件和CLI命令行入口只做参数解析与调用分发,实现同一套业务代码既能通过命令行直接运行,也能作为Web服务的一个路由对外提供服务。
六、总结与实践建议
Python在“全栈”概念下的真正价值,不仅在于其能够胜任多大体量的Web并发,更在于其在整个软件研发与系统运营链路中充当无所不在的高效率生产力底座。从编写10行代码的日常数据清洗脚本,到搭建支撑数万人并发访问的异步RESTful服务,再到驱动分布式集群的自动化运维作业,Python以高度统一的语言心智模型极大降低了跨技术维度的上下文切换成本。
在实际架构设计中,建议遵循“分层清晰、接口先行、重载下沉、异步解耦”的十六字原则:以类型提示与标准库作为基础保障,将复杂或长时耗业务通过消息队列转移到异步Worker运行,并在遇到真正不可逾越的CPU密集型极限时合理利用C/Rust扩展或独立专用服务。如此即可最大化释放Python全栈技术栈的效能红利。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















