


Python内置SQLite无需下载:怎么直接使用本地数据库

sqlite3 模块,读者不需要执行 pip install 安装任何第三方库,也不需要单独下载或配置 MySQL、PostgreSQL 等数据库服务进程。只要运行几行 Python 代码,程序就会在指定的本地路径生成一个独立的单文件数据库,并直接完成数据建表、插入、事务提交与查询。
一、为什么 SQLite 无需下载与配置
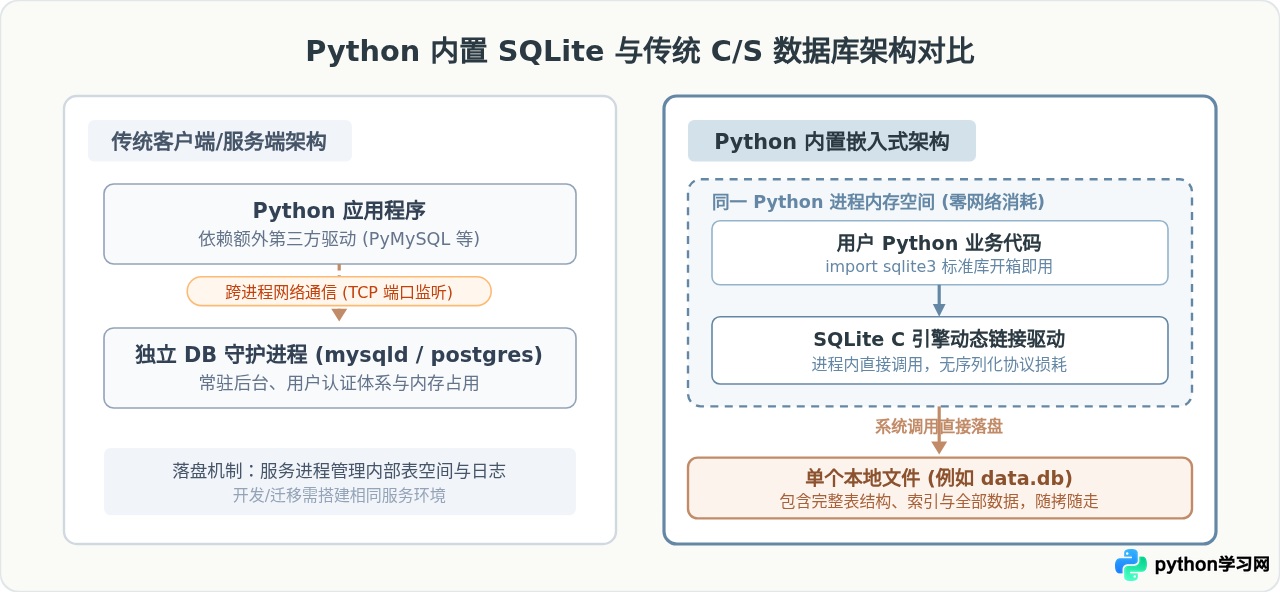
大部分主流关系型数据库(例如 MySQL 或 PostgreSQL)采用客户端-服务端(Client/Server)架构。在这种模式下,开发者必须先在操作系统中安装守护进程、配置端口监听、创建数据库账号并分配权限,Python 程序再通过第三方网络驱动库发起 TCP 连接通信。
SQLite 则完全不同,它是一款自包含、无服务器(Serverless)、零配置的嵌入式数据库引擎。Python 在底层已经直接将 SQLite 的 C 语言核心库链接进了官方运行时中。当你在代码中引入 import sqlite3 时,数据库引擎就在当前 Python 进程的内存空间中协同运行,所有 SQL 执行均转为直接的进程内函数调用,并由底层驱动与操作系统的文件系统进行交互。
二、直接使用本地数据库的核心操作流程
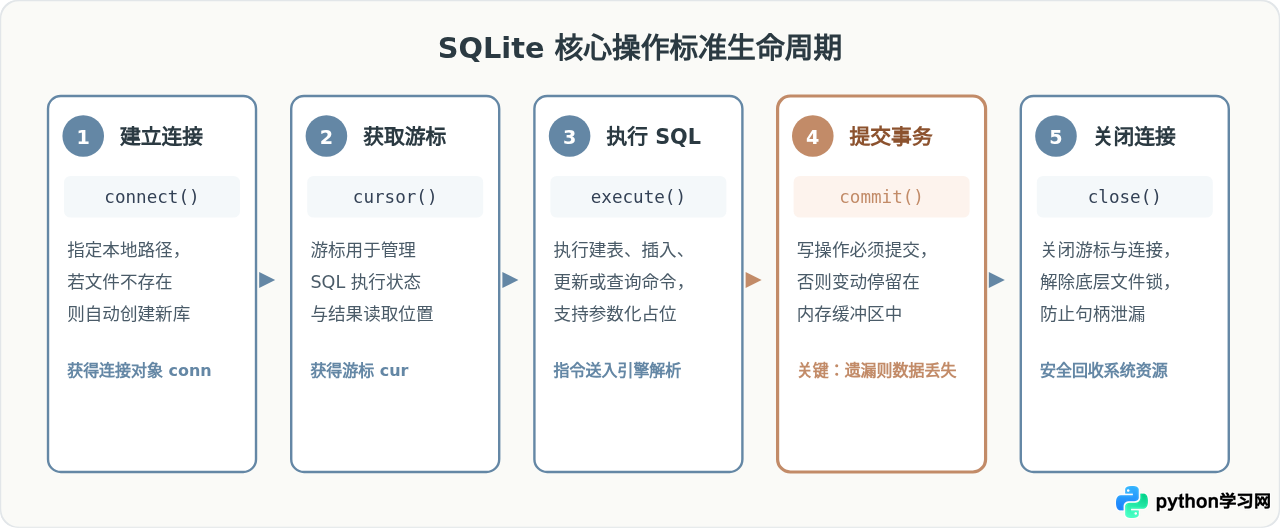
操作 SQLite 本地数据库遵循明确的生命周期:建立连接、创建游标、执行 SQL、提交持久化事务、释放连接句柄。整个过程无需任何前置建库命令,只需提供目标文件路径。
1. 完整代码示例:从创建到读写
下面是一个可直接在本地运行的完整脚本。执行后,会在当前目录下自动生成名为 project.db 的数据库文件,并在其中建表、写入示例数据并读取输出。
import sqlite3

# 步骤 1:连接到本地数据库文件(文件不存在时会自动在当前目录创建)
connection = sqlite3.connect("project.db")

# 步骤 2:创建游标对象
cursor = connection.cursor()

# 步骤 3:编写并执行建表 SQL 语句
cursor.execute("""
CREATE TABLE IF NOT EXISTS articles (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    title TEXT NOT NULL,
    read_count INTEGER DEFAULT 0
)
""")

# 步骤 4:插入测试数据(使用参数化问号占位符)
sample_data = [
    ("Python内置模块完全指南", 1250),
    ("SQLite本地存储实践技巧", 890),
    ("自动化数据清洗脚本", 340)
]
cursor.executemany("INSERT INTO articles (title, read_count) VALUES (?, ?)", sample_data)

# 步骤 5:显式提交事务,确保写入磁盘持久化
connection.commit()

# 步骤 6:查询数据
cursor.execute("SELECT id, title, read_count FROM articles WHERE read_count > ?", (500,))
results = cursor.fetchall()

print("符合条件的查询结果:")
for row in results:
    print(f"ID: {row[0]}, 标题: {row[1]}, 阅读量: {row[2]}")

# 步骤 7:释放游标与连接
cursor.close()
connection.close()
2. 为什么写了数据却看不到:事务(commit)的作用
初学者使用 SQLite 最容易遇到的现象是:代码运行没有报任何错误,但重新打开数据库或去磁盘检查时,发现表是空的。
根本原因在于 SQLite 默认开启了事务机制。在执行 INSERT、UPDATE 或 DELETE 时,数据变更首先停留在内存日志缓存中。如果没有调用 connection.commit(),在调用 close() 或程序退出时,未提交的事务会被隐式回滚,所有写入都会丢失。
3. 更优雅的实践:使用上下文管理器(with 语句)
为了避免忘记提交事务或因中途抛出异常导致连接句柄未关闭,推荐使用 Python 的 with 上下文管理器:
import sqlite3

# connection 作为上下文管理器时,代码块正常结束会自动 commit,发生异常会自动 rollback
with sqlite3.connect("project.db") as conn:
    cur = conn.cursor()
    cur.execute("UPDATE articles SET read_count = read_count + 1 WHERE id = ?", (1,))
# 离开 with 作用域后,更新已自动持久化落盘
三、避免踩坑的关键进阶技巧
1. 绝对不要使用字符串拼接传参
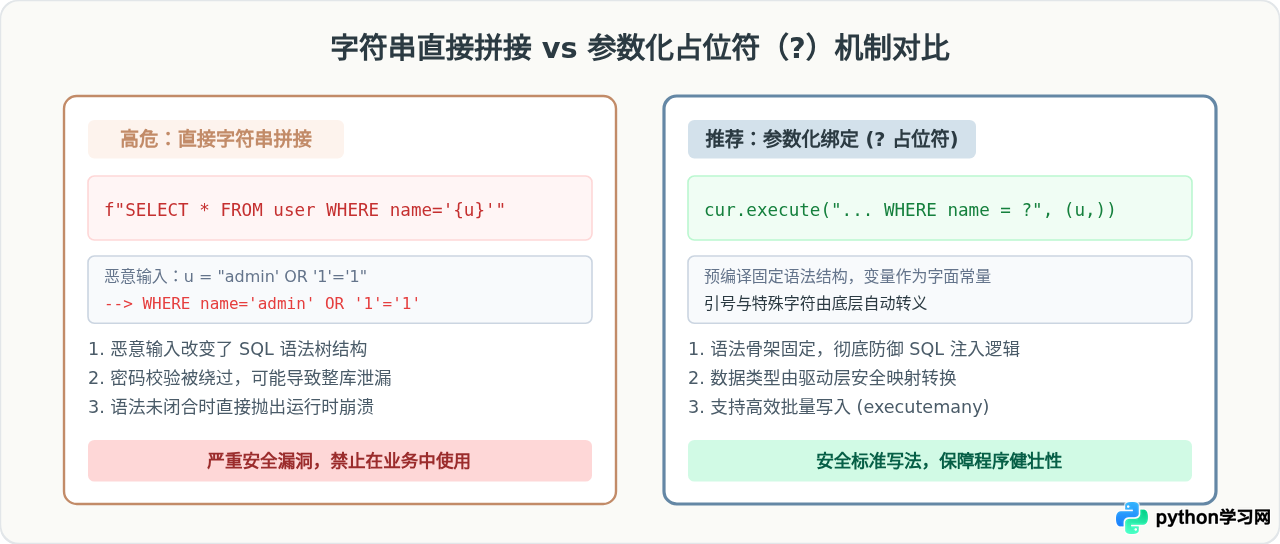
很多刚接触数据库的开发者习惯用 f-string 或 %s 构造 SQL 语句,例如 f"SELECT * FROM users WHERE name = '{username}'"。这种写法会将用户输入的字符串直接当成 SQL 语法树的一部分进行解析,极易引发 SQL 注入漏洞。
正确的做法是始终使用问号 ? 占位符,并将变量打包成元组传给 execute()。此时 SQLite 引擎会先完成 SQL 语句的语法编译,随后将参数单纯作为常量字面量处理,从根本上隔离了代码逻辑与数据内容。
2. 将查询结果转为字典格式访问
默认情况下,cursor.fetchall() 返回的是元组列表,只能通过数字索引 row[0]、row[1] 访问列。当表结构调整或查询字段较多时,维护数字下标容易出错。
只需设置连接对象的 row_factory = sqlite3.Row,即可让每一行结果既支持按列名键访问,又保留了元组的高性能:
conn = sqlite3.connect("project.db")
conn.row_factory = sqlite3.Row  # 启用字典式访问

cur = conn.cursor()
cur.execute("SELECT title, read_count FROM articles")
for row in cur.fetchall():
    print(f"文章:{row['title']},浏览:{row['read_count']}")
3. 高速单元测试神器:内存数据库(:memory:)
如果编写测试用例或需要对一批数据进行临时的复杂 SQL 分析,但并不想在磁盘上产生文件,可以直接将连接路径设为 :memory::
# 数据库完全在 RAM 中运行,速度极快,连接关闭后自动随进程彻底销毁
mem_conn = sqlite3.connect(":memory:")
四、SQLite 的适用边界与选型建议
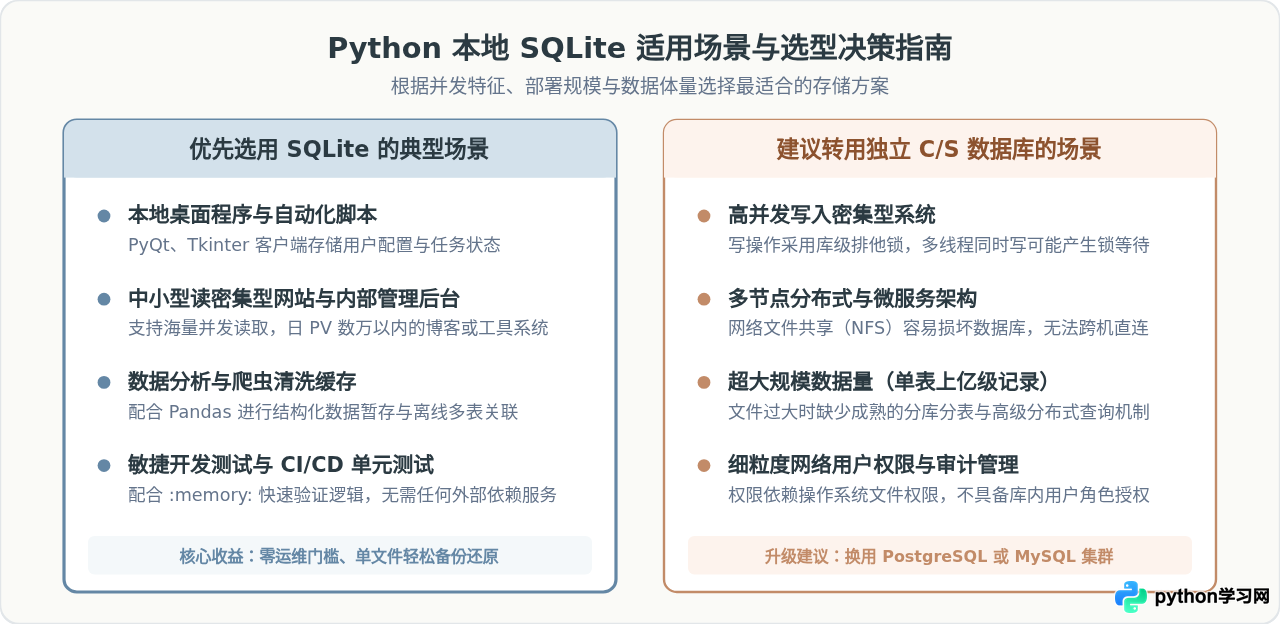
尽管 SQLite 极其方便且性能强劲,但它并不是所有业务场景的通用解决方案。理解它的架构边界,有助于在项目选型时做出正确的决策。
总结
Python 内置的 sqlite3 彻底省去了下载安装数据库客户端与守护服务的繁琐步骤。通过简单的 sqlite3.connect(),就能直接获得一个具备完整 ACID 特性的关系型数据库。在实际编码中,牢记“写操作后执行 commit()”、“查询使用 ? 参数化绑定”,并在需要更方便地访问列值时启用 sqlite3.Row,便能安全、高效地满足各类本地应用与中小型项目的数据持久化需求。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















