


Python操作SQLite数据库:无需安装服务的轻量级管理方案

深入讲解如何使用Python内置sqlite3模块操作与管理SQLite数据库。内容包含免安装无服务架构解析、连接生命周期管理、参数化查询防注入、Row映射、WAL高并发模式及技术选型边界。
在开发数据存储模块、桌面应用程序、轻量级 Web 服务或本地自动化脚本时,配置和维护独立的数据库服务往往会带来额外的心智负担。Python 内置的 sqlite3 模块配合 SQLite 数据库,提供了一套无需安装守护服务、零网络配置、单文件持久化的轻量级解决方案。本文将系统讲解其运作机制、核心操作方法、进阶性能调优与架构选型依据。
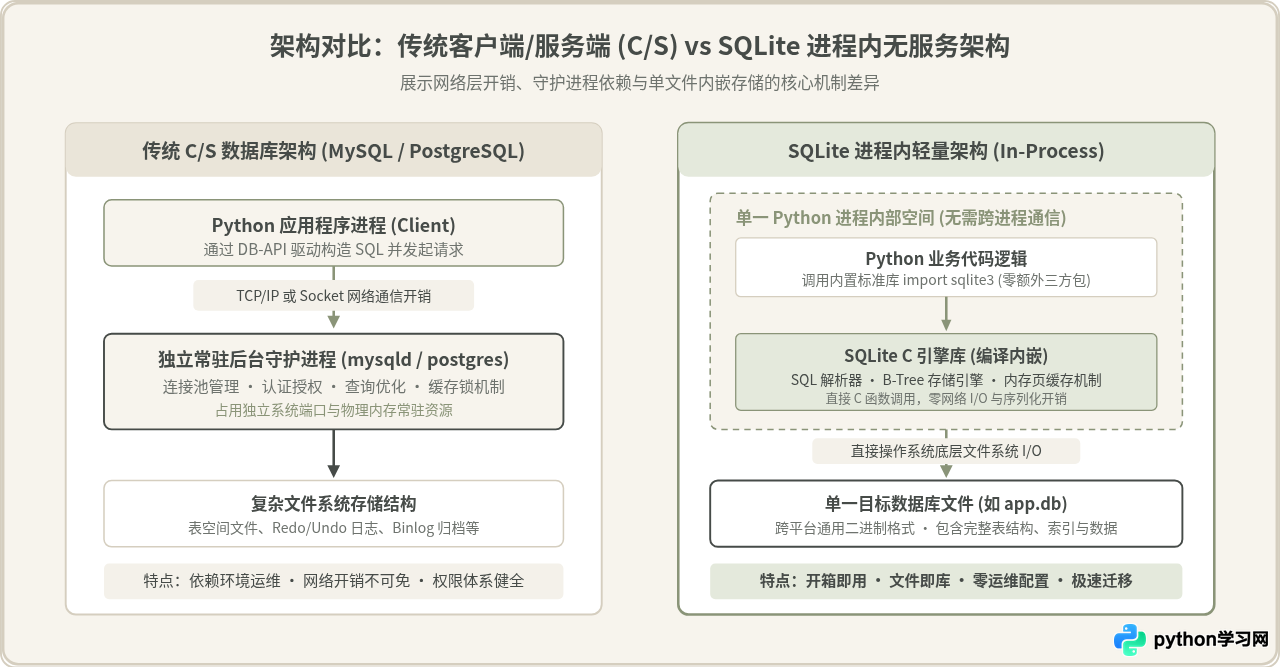
一、无需安装服务的轻量级架构本质
传统的关系型数据库(如 MySQL、PostgreSQL)采用典型的客户端-服务端(Client-Server)架构。应用通过网络协议(TCP/IP)或本地套接字向独立运行的数据库守护进程发起请求,由该服务进程完成查询解析、锁竞争处理和磁盘文件读写。这种架构适合大规模分布式部署,但在独立工具、小型系统或嵌入式设备中,服务安装、端口配置、权限初始化与进程保活都会带来不必要的开销。
SQLite 则采用截然不同的“进程内嵌入式(In-Process)”架构。SQLite 实际上是一个高度优化且自包含的 C 语言函数库。当在 Python 中执行 import sqlite3 时,数据库引擎会直接嵌入到当前的 Python 进程中运行。数据库的所有表格、索引、视图及元数据都被完整存储在一个普通的单一磁盘文件中,甚至可以直接在内存中创建。
二、核心操作生命周期:从连接到游标流转
在 Python 中操作 SQLite 遵循标准的 Python DB-API 2.0 规范。整体流程可以抽象为五个明确的阶段:建立数据库连接、获取操作游标、执行 SQL 指令、提交或回滚事务、以及安全释放资源。
1. 建立连接与初始化数据库
通过调用 sqlite3.connect() 函数,如果指定的数据库文件不存在,SQLite 会自动在指定路径创建该文件;如果文件已存在,则直接打开:
import sqlite3

# 连接到磁盘文件数据库
conn = sqlite3.connect("storage.db")

# 或者创建纯内存数据库,生命周期随进程结束而销毁,适合单元测试
# conn = sqlite3.connect(":memory:")
2. 游标的作用与基本 DDL 操作
数据库连接对象(Connection)代表与物理文件的会话,而游标对象(Cursor)则是执行 SQL 语句并遍历结果集的控制指针。通过游标可以执行数据定义语言(DDL)建表:
cursor = conn.cursor()

# 创建员工信息表
cursor.execute("""
CREATE TABLE IF NOT EXISTS employees (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    name TEXT NOT NULL,
    department TEXT NOT NULL,
    salary REAL CHECK(salary >= 0),
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);
""")
conn.commit()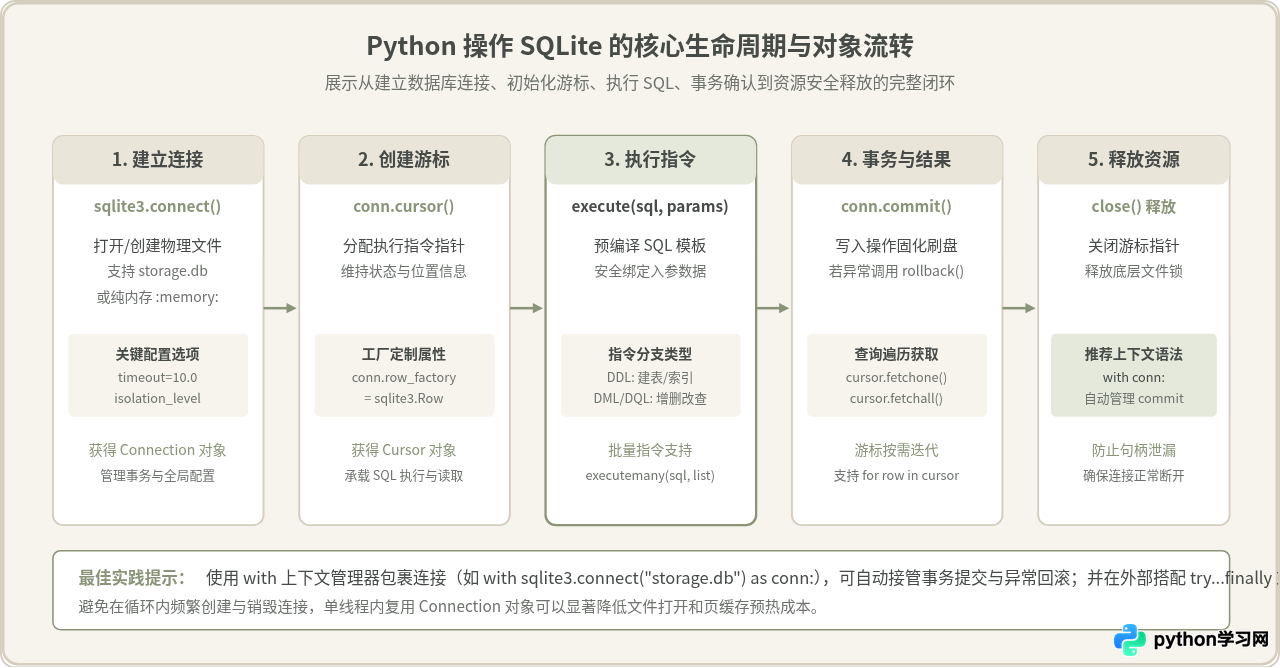
三、核心数据操作与参数化安全防线
在日常数据管理中,绝大多数操作归结为增加(Create)、读取(Read)、更新(Update)与删除(Delete)。操作 SQLite 时,必须牢记防御 SQL 注入的基本规范。
1. 参数化查询:杜绝 SQL 注入的核心原则
许多初学者习惯使用 Python 的 f-string 或 % 格式化拼接 SQL 语句。这是极其危险的做法。如果外部输入包含闭合引号或恶意指令,SQL 语句的原有逻辑会被篡改。
正确做法是使用占位符 ?(位置参数)或 :key(命名参数),将 SQL 骨架与入参数据严格分离传输:
# 危险示例(严禁在生产代码中使用):
# cursor.execute(f"SELECT * FROM employees WHERE name = '{user_input}';")

# 正确示例 1:使用 ? 占位符元组
cursor.execute(
    "INSERT INTO employees (name, department, salary) VALUES (?, ?, ?);",
    ("张伟", "技术部", 12500.0)
)

# 正确示例 2:使用命名参数字典(推荐字段较多时使用,提升可读性)
cursor.execute(
    """
    INSERT INTO employees (name, department, salary)
    VALUES (:name, :dept, :salary);
    """,
    {"name": "李娜", "dept": "运营部", "salary": 9800.0}
)
conn.commit()
2. 批量操作优化:executemany 的效率优势
如果需要插入成百上千条记录,反复在循环中调用 cursor.execute() 会带来巨大的解析和事务同步开销。通过 cursor.executemany() 可以批量提交数据,执行速度通常有数十倍的提升:
batch_data = [
    ("王芳", "市场部", 10200.0),
    ("赵强", "技术部", 14000.0),
    ("刘洋", "财务部", 11500.0)
]

cursor.executemany(
    "INSERT INTO employees (name, department, salary) VALUES (?, ?, ?);",
    batch_data
)
conn.commit()
3. 数据读取与 sqlite3.Row 字典化映射
默认情况下,cursor.fetchall() 返回的是包含普通元组(Tuple)的列表。访问字段只能依靠索引下标(如 row[0]、row[1]),这在字段较多或表结构变更时极易引发 Bug。通过为连接配置 sqlite3.Row 工厂,可以让行对象同时支持下标索引与列名键值访问:
# 将结果集映射工厂设置为 sqlite3.Row
conn.row_factory = sqlite3.Row
cursor = conn.cursor()

cursor.execute("SELECT id, name, department, salary FROM employees WHERE salary > ?", (10000.0,))
rows = cursor.fetchall()

for row in rows:
    # 既可以通过列名像字典一样访问,也可以按下标访问
    print(f"工号: {row['id']}, 姓名: {row['name']}, 部门: {row['department']}, 薪资: {row['salary']}")
    # 还可以非常便捷地转为标准字典,方便序列化为 JSON
    row_dict = dict(row)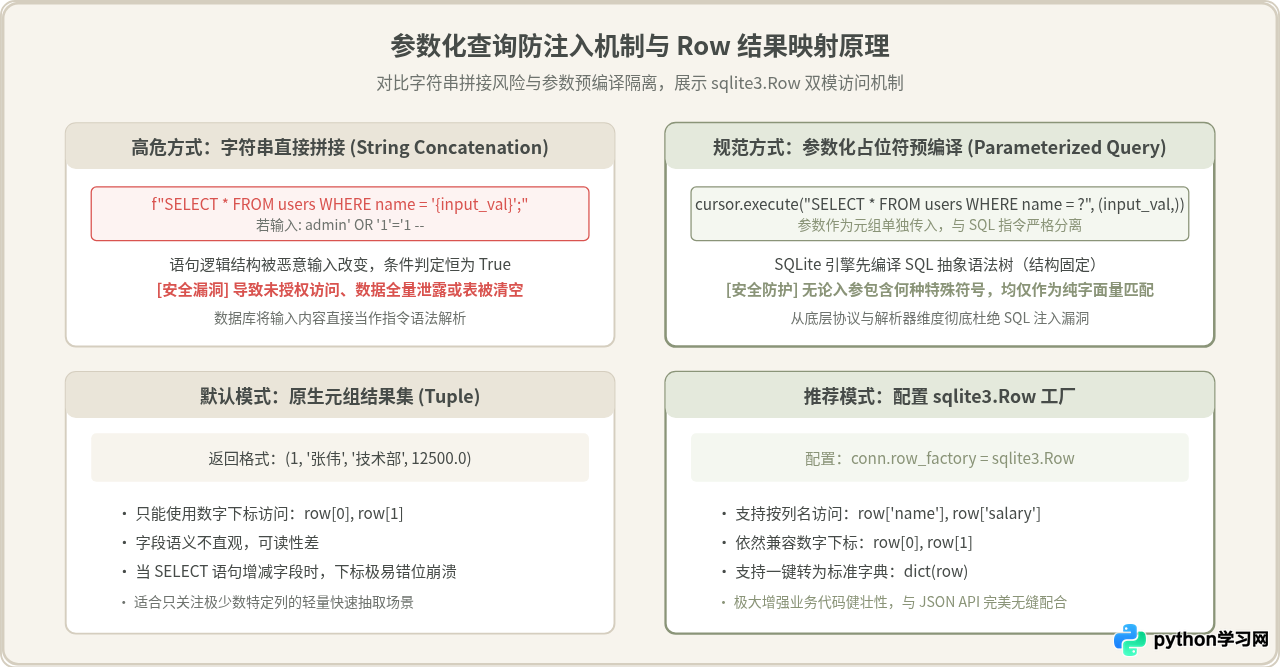
四、进阶管理:事务控制与 WAL 高并发模式
虽然 SQLite 使用极为轻量,但它在事务处理上完全支持严格的 ACID 特性(原子性、一致性、隔离性、持久性)。理解其事务与锁机制,是避免应用出现 database is locked 错误的关键。
1. 事务的自动管理机制
在 Python 的 sqlite3 模块中,默认会在遇到 DML 语句(如 INSERT、UPDATE、DELETE)时自动开启一个事务,而不会自动提交。必须显式调用 conn.commit() 将修改持久化写入磁盘。如果中途发生异常,应调用 conn.rollback() 撤回该事务。
使用上下文管理器可以极大地简化这一处理流程:
try:
    # with conn 自动管理事务提交与异常回滚
    with conn:
        cursor.execute("UPDATE employees SET salary = salary * 1.05 WHERE department = ?", ("技术部",))
        cursor.execute("INSERT INTO log_table (action) VALUES (?)", ("全员加薪5%",))
        # 若上方无异常,退出代码块时自动执行 commit()
except sqlite3.Error as e:
    # 若上方出现异常,自动执行 rollback(),并在此捕获异常
    print(f"事务执行失败,已自动回滚:{e}")
2. 开启 WAL 模式以应对读写并发
默认情况下,SQLite 采用回滚日志(Rollback Journal)模式。在该模式下,当有线程或进程在执行写入操作时,会获取排他写锁,此时所有的读操作都会被完全阻塞;同样,如果有读操作正在进行,写操作也会被阻塞。
为了大幅提升多线程/多进程读写并发能力,推荐在建立连接后开启 WAL 模式(Write-Ahead Logging)。在 WAL 模式下:
- 读写互不阻塞:读操作直接读取主库文件与 WAL 日志文件中的快照,写操作直接追加到 WAL 日志文件尾部。
- 写入速度更快:因为写入是连续追加到日志文件,而不是频繁随机写主库数据页。
只需执行一条 PRAGMA 指令即可开启 WAL 模式(该设置在物理数据库文件中持久生效):
conn = sqlite3.connect("storage.db", timeout=10.0)
# 开启 WAL 日志模式
conn.execute("PRAGMA journal_mode = WAL;")
# 开启外键约束检查(SQLite 默认关闭外键)
conn.execute("PRAGMA foreign_keys = ON;")即使开启了 WAL 模式,SQLite 在同一瞬间仍然只允许一个写入事务。为了防止多线程写入争用时立即抛出 sqlite3.OperationalError: database is locked,务必在 connect() 时传入 timeout=10.0(单位为秒)。这样当遇到锁竞争时,当前线程会在指定时间内自动轮询重试,而不是立刻报错崩溃。
五、认知辨析与选型决策:SQLite 能否用于生产?
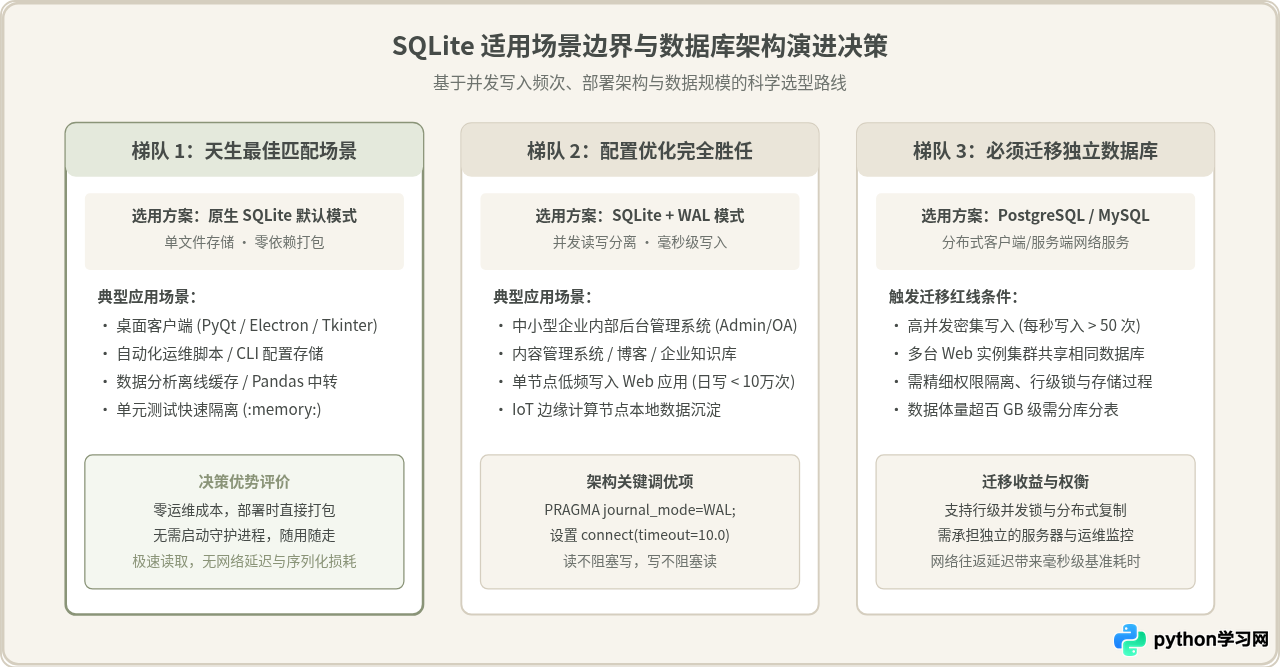
在技术社区中,常常存在一种刻板印象:“SQLite 只是一个玩具数据库,或者仅能用于学生做 Demo 和编写单元测试,绝不能在生产环境中使用”。这种说法看似有其合理性,因为许多开发者遇到过并发写锁死或单文件损坏的困扰,但这种观点并不准确,需要根据实际业务指标加以修正。
1. 为什么“不能用于生产”是片面的?
事实上,SQLite 是全球部署数量最多的数据库引擎。每一台 iPhone、Android 手机、Windows/Mac 操作系统、Chrome 浏览器内部都运行着数百个 SQLite 实例。不仅如此,在服务器端:
- 对于读多写少(Read-Heavy)的系统(如绝大多数内容发布平台、企业知识库、配置中心、低频报表系统),配合 WAL 模式与内存缓存,SQLite 单机能够轻松承载数千 QPS 的查询请求,且响应耗时比跨网络通信的 MySQL 更低。
- 对于微服务本地状态与边缘计算,每个独立节点自包含一个 SQLite 文件,完全省去了搭建与维护外部数据库集群的巨额成本。
2. 何时需要坚定迁移到 MySQL / PostgreSQL?
SQLite 的真正局限在于它的物理模型:全库单写锁与缺乏网络多租户权限体系。当业务系统出现以下特征时,应当果断迁移到外部独立数据库:
- 高频并发持续写入:每秒需要处理数十次以上的并发写入事务(如高并发秒杀、在线交易流水记账)。
- 多台应用服务器分布式共享:多台无状态 Web 服务器通过网络挂载同一个 NFS/Samba 目录访问 SQLite 极易出现文件锁失效和数据库损坏,此时必须使用网络数据库。
- 细粒度用户权限控制:需要按数据库、按数据表、按行级别分配只读、只写、管理权限(SQLite 无用户认证概念,权限完全等同于操作系统文件读写权限)。
六、工程实践要点与常见问题排查
1. 多线程并发访问注意:check_same_thread 设置
默认情况下,由 sqlite3.connect() 创建的连接对象只能在创建它的当前线程中使用。如果将连接跨线程传递,Python 会抛出 ProgrammingError: SQLite objects created in a thread can only be used in that same thread。
虽然可以在连接时指定 check_same_thread=False 禁用此项安全检查,但强烈不建议多个线程共用同一个连接对象进行并发写入,因为底层的 C 游标状态并非绝对线程安全。推荐工程规范是:每个工作线程独立创建专属的 Connection 连接对象,各线程依托 SQLite 底层的文件锁和 WAL 机制进行并发协调。
2. 在线无锁热备份:conn.backup() 接口
直接在操作系统层面拷贝一个正在被写入的 SQLite 文件(如 cp storage.db backup.db),很可能拷贝到中间脏状态而导致备份文件损坏。Python 原生提供了专用的热备份接口 conn.backup():
def backup_database(source_conn, target_file_path):
    # 创建目标备份文件连接
    target_conn = sqlite3.connect(target_file_path)
    try:
        # 使用原生 backup 接口实现在线安全备份,期间主库仍可并发响应读请求
        source_conn.backup(target_conn, pages=100)
        print("数据库热备份完成!")
    finally:
        target_conn.close()

# 示例调用
backup_database(conn, "storage_backup.db")
七、核心总结
Python 原生内置的 SQLite 管理方案,通过极致的进程内无服务架构,消除了独立数据库服务带来的网络延迟和运维配置开销。通过掌握以下四条核心准则,即可在实际工程中安全、高效地使用它:
- 全生命周期管理:善用
with上下文管理器,自动保障事务提交与异常回滚,并确保物理连接得到安全释放。 - 防御注入底线:坚决杜绝字符串拼接 SQL,统一使用
?占位符或:key命名参数传递变量。 - 结构化数据映射:配置
conn.row_factory = sqlite3.Row,兼具字典易用性与元组高性能。 - 高并发稳健运行:始终在建连时配置合理
timeout,并开启PRAGMA journal_mode = WAL;,让单机系统在轻量与高吞吐之间取得完美平衡。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















