


Dify知识库数据清洗技巧:预处理文档提升RAG效果

明明上传了公司最新的员工手册,AI 却总是引用两年前的旧版本?或者问一个具体的报销额度,它却把整段无关的行政废话都读给你听?这通常不是模型不够聪明,而是喂给它的“饲料”里杂质太多。在 Dify 中构建知识库时,很多人习惯直接把 PDF 或 Word 丢进去,指望自动分段能搞定一切。但现实是,页眉页脚、乱码表格和无意义的换行符,都会成为检索时的噪声。
最值得先检查的,不是向量模型的参数,而是你的源文件本身。干净的数据比昂贵的模型更能决定 RAG 的上限。
1. 剔除视觉噪声与无效字符
PDF 转文本时最容易带入“隐形垃圾”。比如每页都重复出现的页眉“某某公司内部资料”,或者页脚的页码。这些内容在分段时会被强行拼接到正文中,导致检索匹配度下降。
在上传到 Dify 之前,建议先用简单的文本编辑器或脚本跑一遍清洗。重点删除重复率极高的短行(通常是页眉页脚),以及孤立的页码数字。如果文档中有大量的扫描图片转文字产生的乱码符号,如 `` 或无意义的空格堆叠,必须替换为空。Dify 的分段器虽然能处理一定程度的格式混乱,但它无法理解哪些是“噪音”。
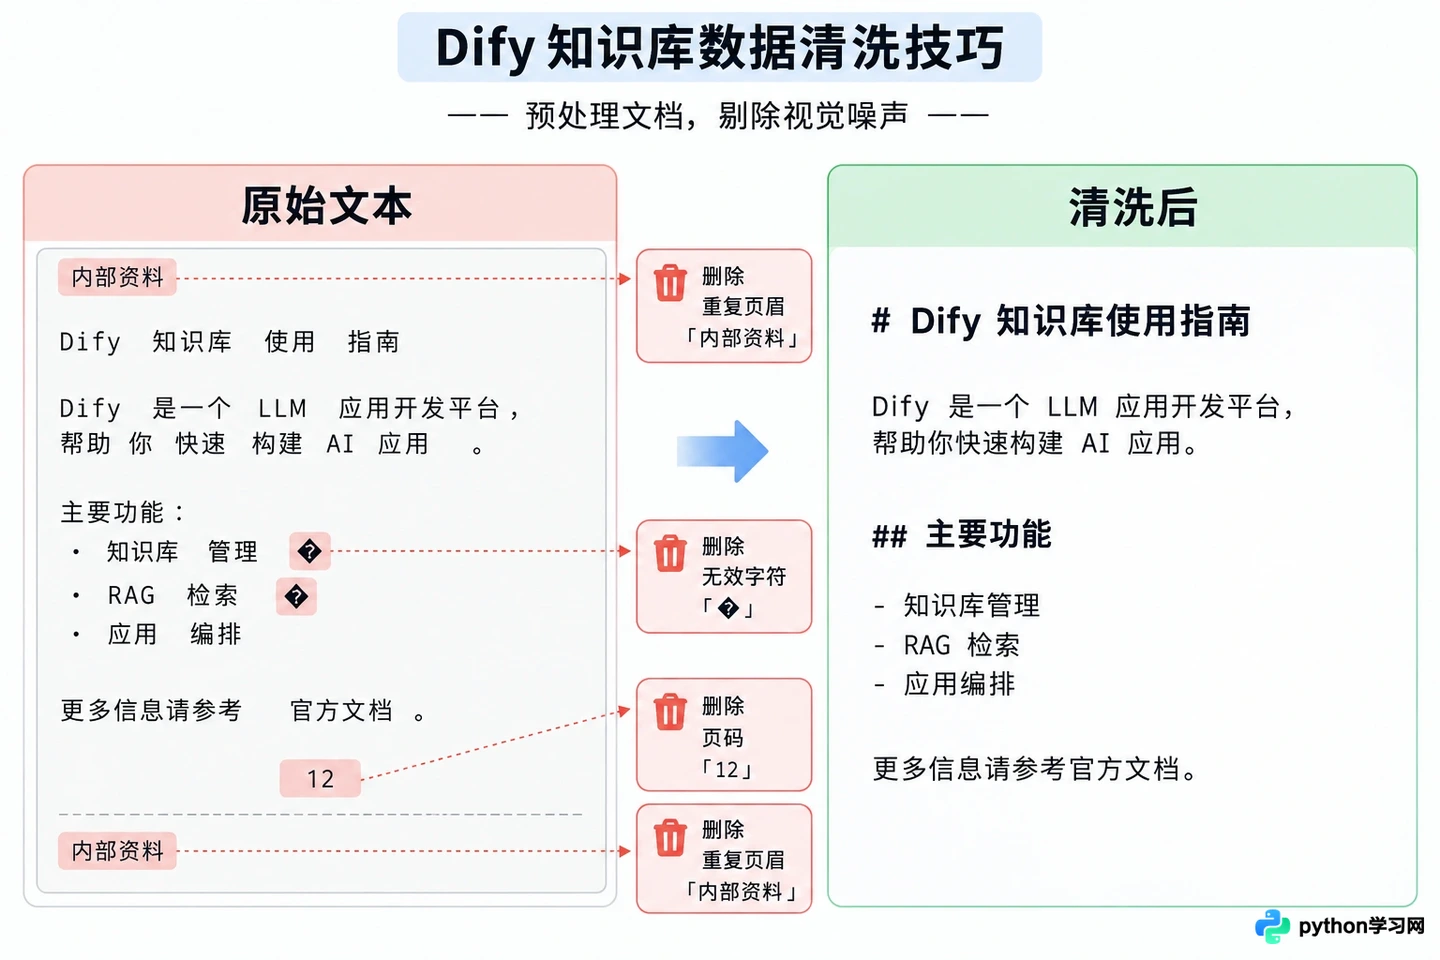
左侧为包含页眉页脚和乱码的原始文本,右侧为清洗后干净的 Markdown 文本
另外,注意检查列表符号。有些 PDF 转换后,列表项变成了奇怪的 ASCII 字符或乱码,这会打断语义的连贯性。将其统一替换为标准的 Markdown 列表符号 - 或 1.,能让后续的分段更准确地识别条目边界。
2. 用 Markdown 重构非结构化文档
Dify 对 Markdown 格式的支持远优于纯文本或复杂的 HTML。如果你的源文件是 Word 或 PDF,不要直接上传原始文件,而是尝试将其转换为结构清晰的 Markdown。
标题层级是关键。确保一级标题 # 代表文档主题,二级标题 ## 代表主要章节,三级标题 ### 代表具体知识点。Dify 的分段策略(尤其是父子索引模式)非常依赖这种层级关系来保持上下文完整。如果原文档没有清晰的标题,手动添加简短的描述性标题,能帮 AI 更好地定位信息块。
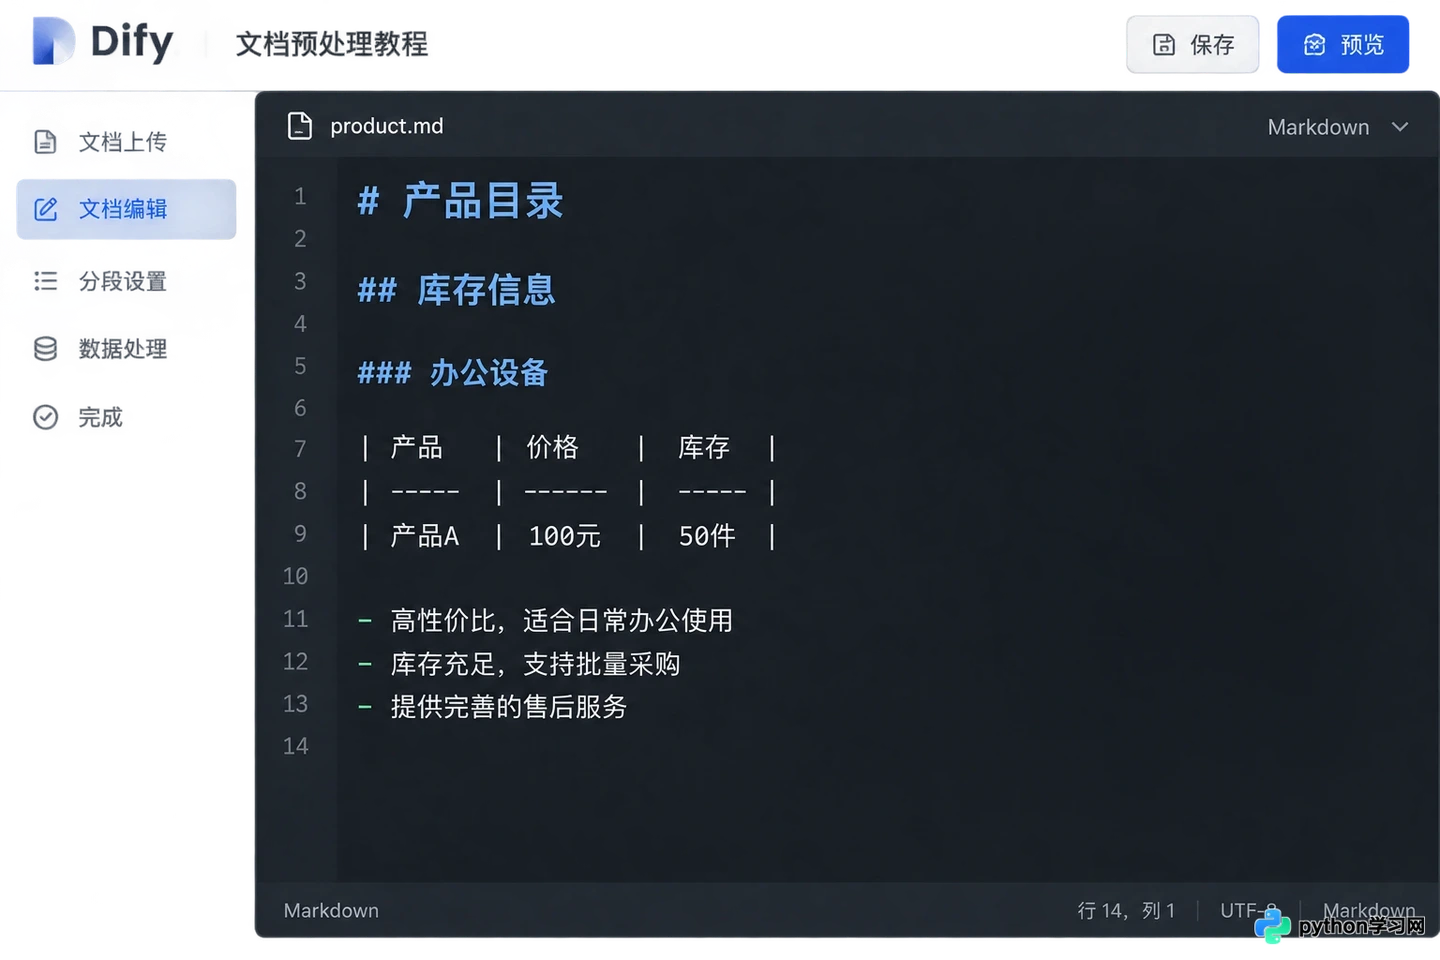
使用清晰的标题层级和标准表格的 Markdown 文档结构
对于表格数据,尽量避免使用截图或复杂的嵌套表格。将其简化为标准的 Markdown 表格,或者如果表格逻辑复杂,干脆拆解为“键值对”形式的文本描述。例如,将“产品A | 价格100 | 库存50”转化为“产品A的价格为100元,当前库存50件”。这样在向量化时,每个属性都能被独立索引,而不是作为一个整体被模糊匹配。
3. 优化分段粒度与重叠设置
在 Dify 的知识库设置中,分段规则直接影响检索效果。默认的自动分段往往过于机械,可能把一个完整的操作步骤切断在两段落里。
对于操作指南或政策条款,建议使用“自定义分段”而非自动分段。观察你的文档,找到自然的语义断点。通常,一个完整的问答对、一个独立的步骤说明或一个具体的定义,应该保持在同一个分段内。如果一段内容超过 500-800 字,考虑手动拆分;如果少于 50 字,考虑合并到上一段。
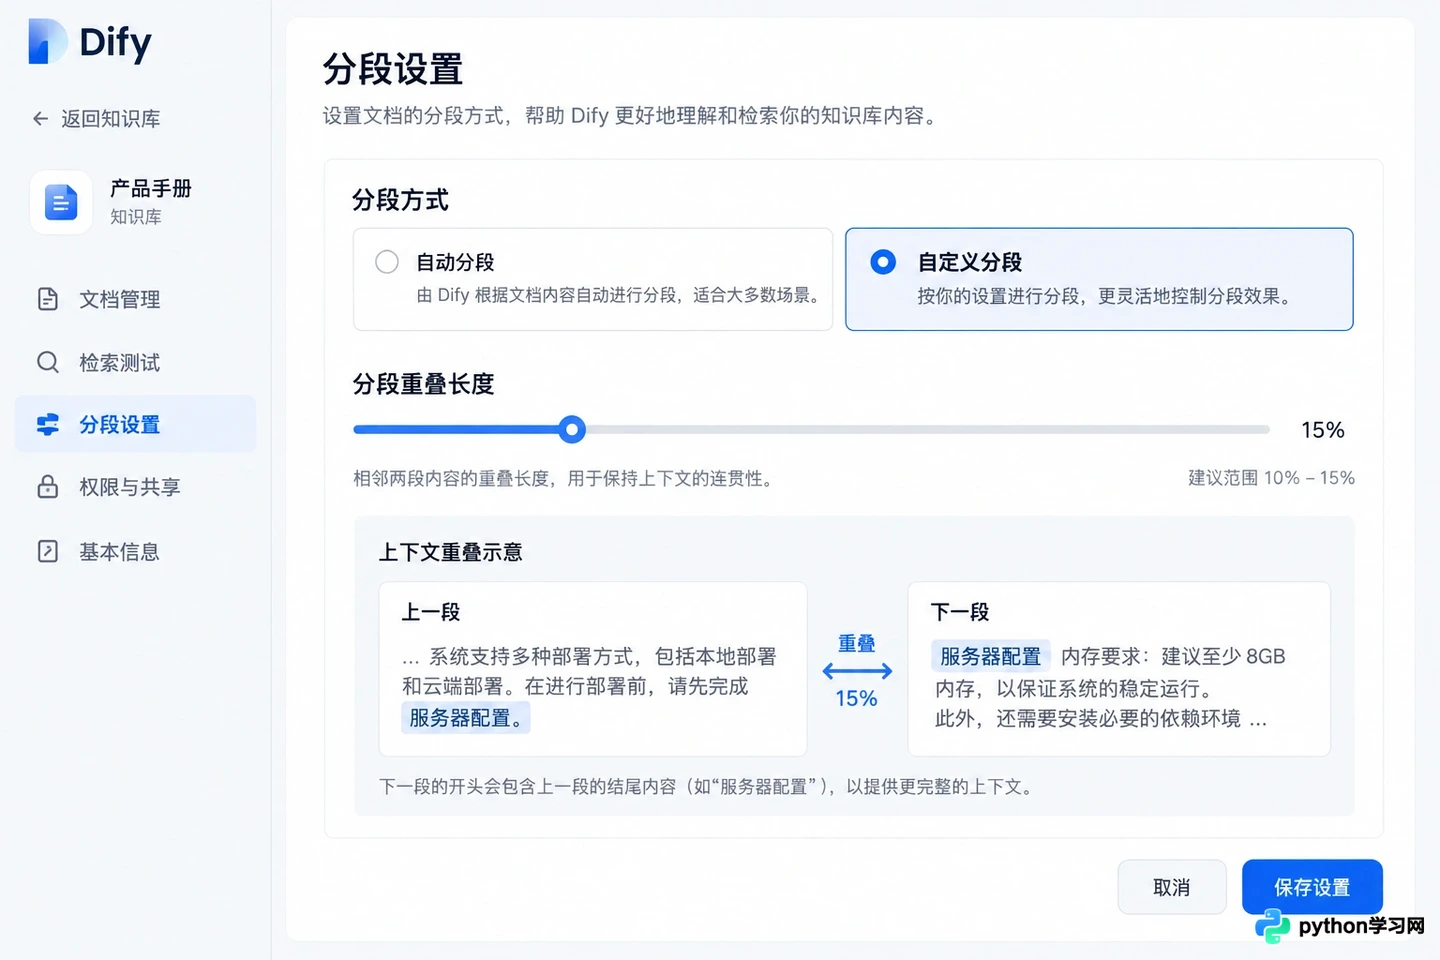
Dify 平台中自定义分段规则和重叠长度的设置面板
同时,适当增加“分段重叠长度”(Overlap)。设置为 10%-15% 的重叠可以确保上下文关键词不会因切割而丢失。比如,前一段的结尾提到了“服务器配置”,后一段开头接着说“其内存要求”,重叠部分能让这两者在向量空间中保持更紧密的联系。
4. 补充元数据与混合检索开关
清洗不仅是做减法,也是做加法。在上传文档时,利用 Dify 提供的元数据功能,为不同来源或类型的文档打上标签。例如,区分“2023版”和“2024版”,或者标记“技术部”与“人事部”。
这在混合检索模式下尤为有用。当用户提问时,系统不仅可以基于语义相似度,还可以基于元数据过滤掉过时或无关部门的信息。如果你发现 AI 经常混淆新旧政策,检查是否没有在元数据中明确版本标识,或者没有在提示词中要求优先引用最新元数据的文档。
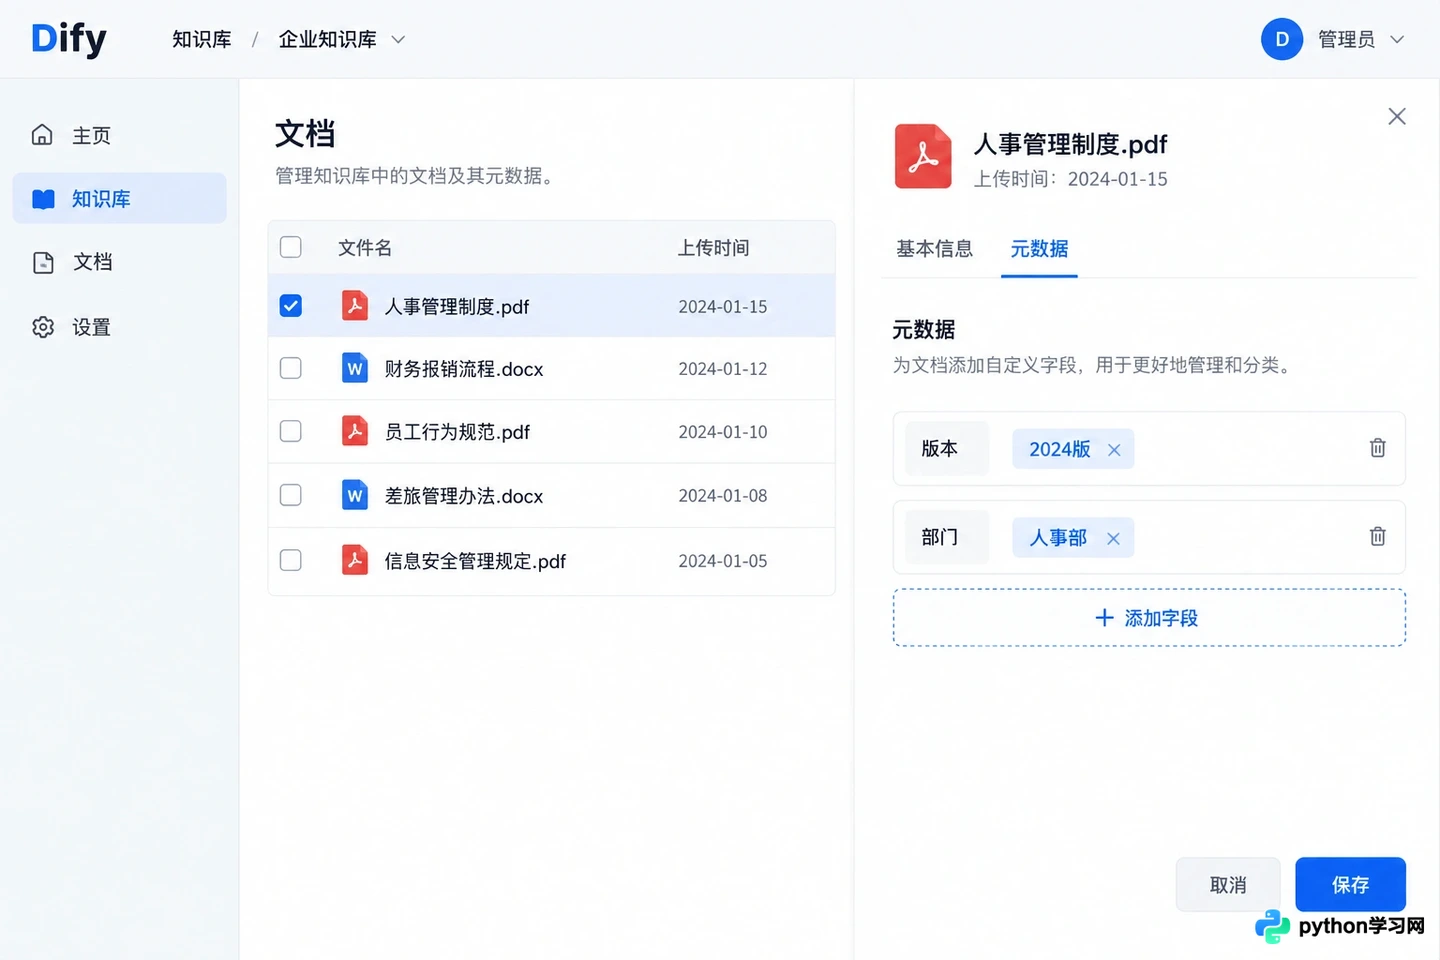
为知识库文档添加版本和部门元数据标签的操作示意
最后,记得在知识库设置中开启“混合检索”并调整重排得分阈值。清洗后的干净数据配合重排模型(Rerank),能进一步剔除那些虽然语义相近但事实错误的答案。
数据清洗没有一劳永逸的按钮,它是一个迭代过程。先从最核心的几十篇文档入手,按照上述步骤手动优化,观察回答质量的变化。当你看到 AI 不再胡言乱语,而是精准地引用了你整理好的 Markdown 段落时,你就知道方向对了。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















