



很多 SQL 注入问题,并不是出在“少做了一步过滤”,而是从一开始就选错了方向:把用户输入直接拼进 SQL 字符串。要真正把风险降下来,核心做法只有两步,一是改用数据库驱动原生支持的参数化查询,二是把无法参数化的动态标识符改成严格白名单。这样做之后,你也更容易判断现有代码里哪些写法仍然处在高危区。
为什么转义和黑名单挡不住 SQL 注入
很多项目里仍能看到 mysql_real_escape_string、addslashes,或者“过滤关键字”“拦截特殊字符”这一类做法。问题在于,这些方法只能覆盖少数输入形态,无法真正约束 SQL 解析方式,因此并不可靠。
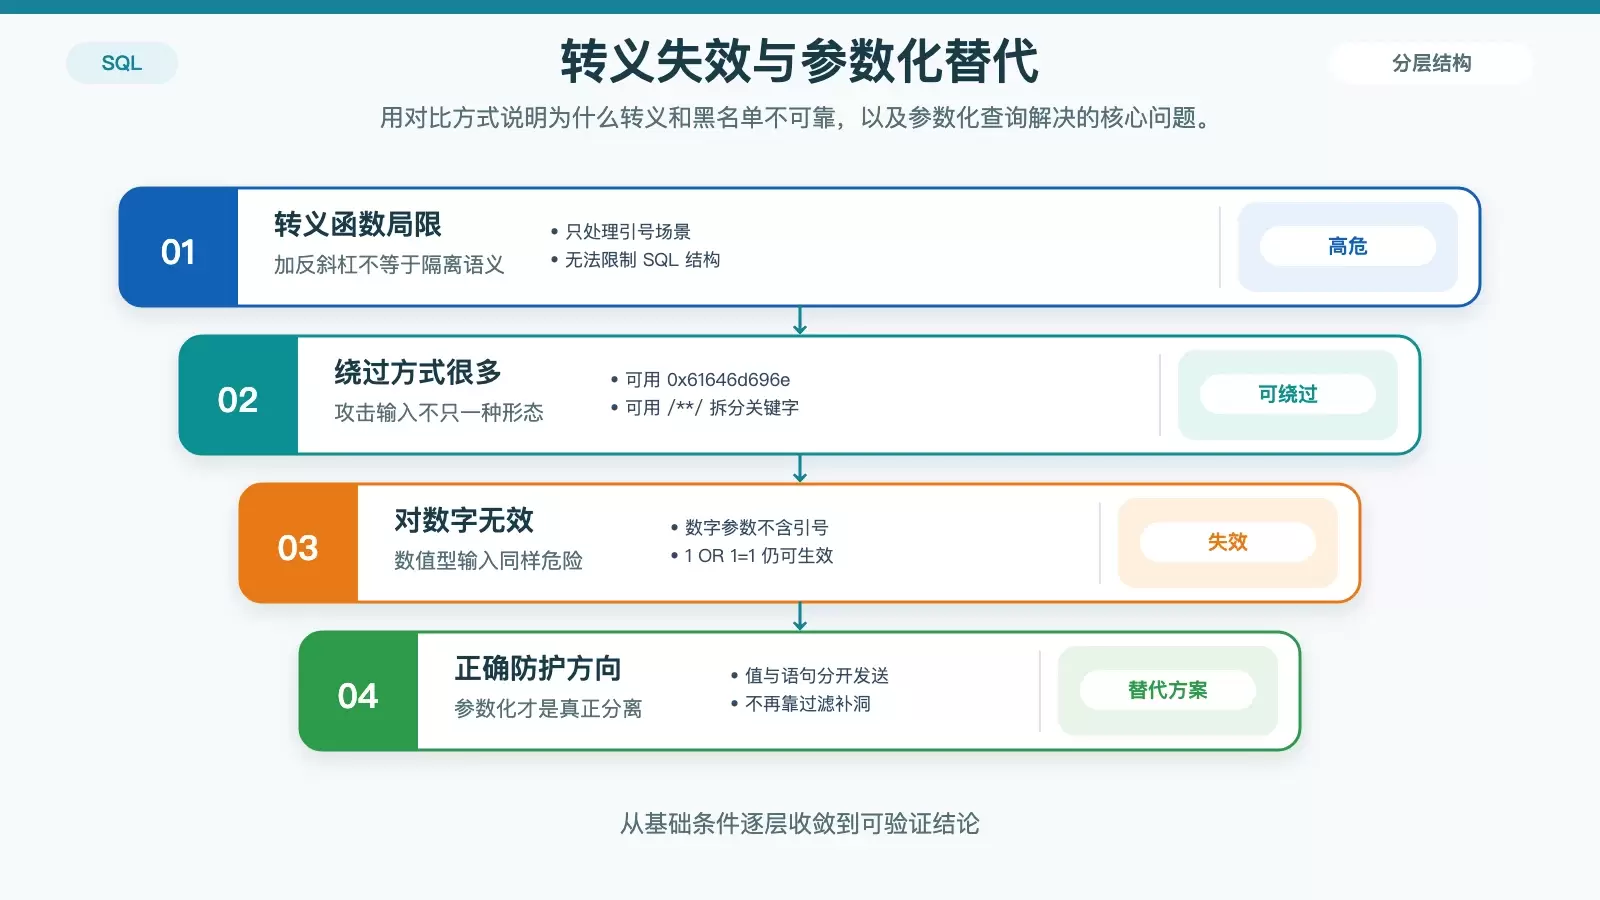
例如,转义函数的典型思路,只是给单引号补上反斜杠。但攻击输入并不一定依赖单引号,攻击者还可以使用十六进制编码,例如 0x61646d696e,也可以借助注释符 /**/ 拆开关键字,甚至通过双写如 seleselectct 诱导不严谨的检测逻辑误判。
更关键的是,这类函数对数字型参数几乎没有帮助。像 1 OR 1=1 这样的输入,不包含单引号,却依然可能改变原本的查询条件。也就是说,只要 SQL 结构仍由拼接形成,所谓“过滤”和“转义”就只是补丁,不是解决方案。
实际排查时,如果你在代码里看到下面这类写法,就应该直接视为高危信号:
"WHERE id = " + user_id
'username=' + name
它们的问题不在语言语法,而在于用户输入已经进入了 SQL 结构本身。
PHP 中 Prepared Statements 的正确用法
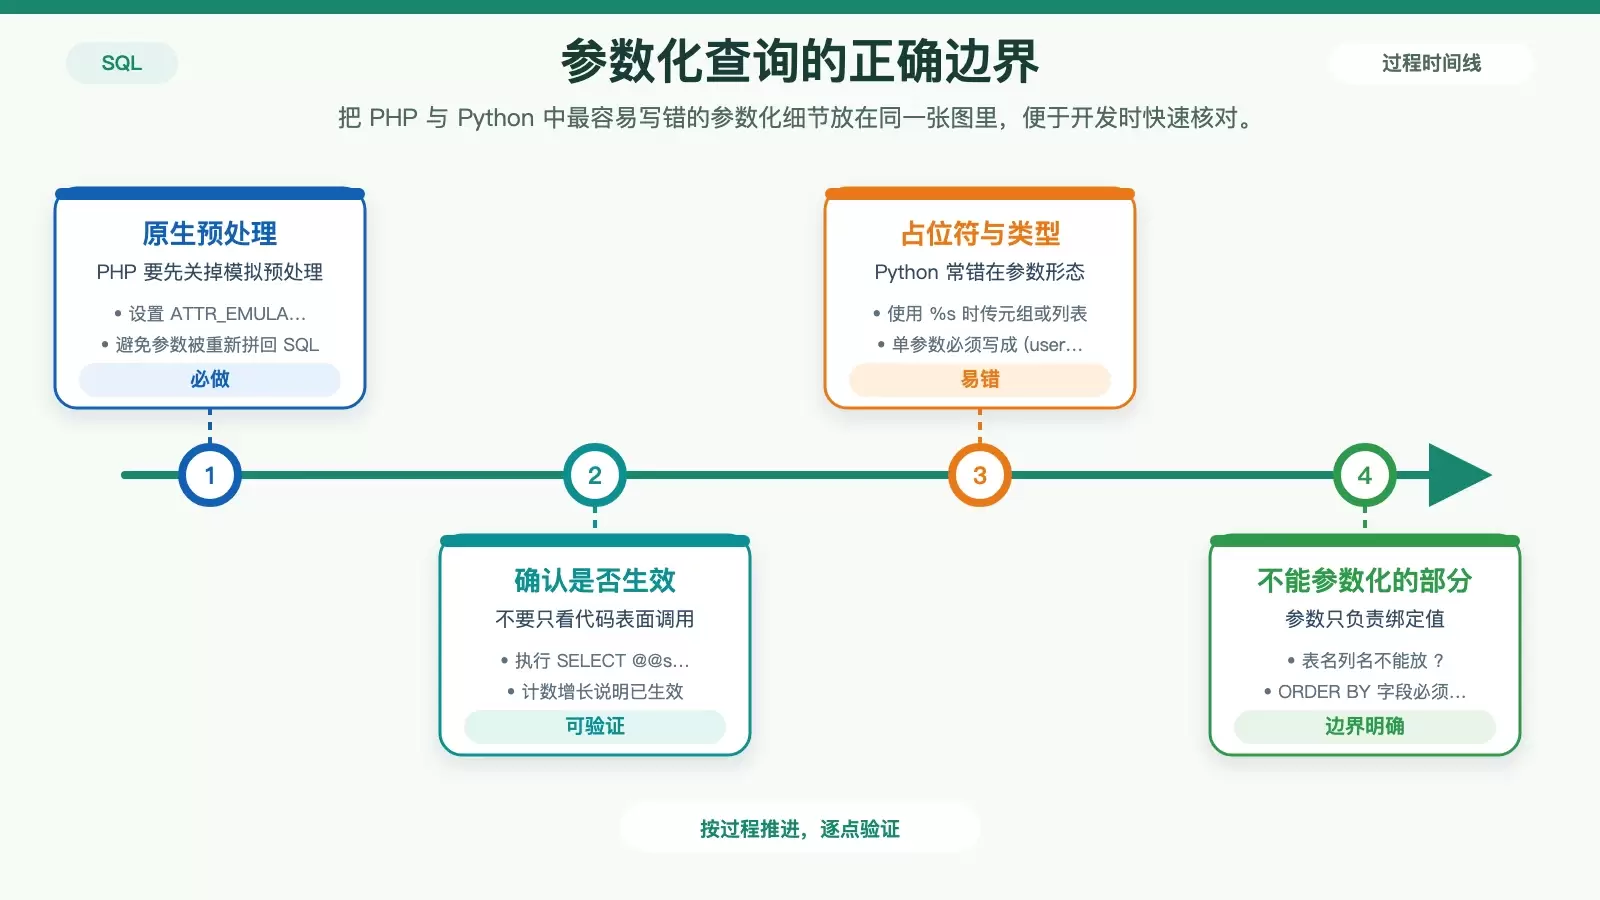
在 PHP 环境里,应该优先使用数据库驱动原生支持的参数化查询,也就是 Prepared Statements。常见接口包括 PDO::prepare() 和 mysqli_prepare()。不过,这里有一个很容易被忽略的点:调用了 prepare(),不代表就一定在使用真正的预编译。
如果启用了模拟预处理(emulated prepares),参数仍可能先被拼回 SQL 字符串,再发送给 MySQL。这样表面上用了预处理,实际却没有获得应有的隔离效果。
因此,正确做法至少包括以下几项:
- 显式关闭模拟预处理:
$pdo->setAttribute(PDO::ATTR_EMULATE_PREPARES, false) - 确认连接使用的是原生预处理,可以执行
SELECT @@session.prepared_stmt_count,若数值增长,说明确实生效 - 明确参数的适用范围:参数只能绑定“值”,例如
WHERE name = ?,不能用来替代表名、列名或排序字段
这也是很多人误判安全性的原因。真正有效的参数化查询,是把“数据”与“SQL 结构”分开传递;如果底层仍在重组字符串,那就没有达到目的。
Python 里 cursor.execute() 最常见的误用
Python 开发里,大家通常知道要用 cursor.execute() 传参数,但实战中最常见的问题,不是完全不用参数,而是占位符写错、参数形态不对,或者中途又退回字符串拼接。
一个典型的安全写法如下:
cursor.execute("SELECT * FROM t WHERE id = %s", (user_id,))这里有两个细节需要特别注意。第一,使用 %s 占位符时,参数必须是元组或列表;第二,单个参数时结尾那个逗号不能省略,否则 (user_id) 只是一个 int,不是 tuple。
与之相对,下面这些写法都属于高危:
f"WHERE id = {user_id}"
"WHERE id = {}".format(user_id)
无论是 f-string 还是 .format(),本质上都还是把值直接拼回 SQL 字符串,风险并不会因为语法看起来更整洁而降低。
不同数据库驱动的占位符习惯也要分清。比如 PostgreSQL 的 psycopg2 使用 %s,而不是 ?;SQLite 虽然两者都支持,但在同一项目里尽量保持统一,会更利于排查问题和代码审计。
动态表名、列名和 ORDER BY 应该怎么处理
参数化查询并不能解决所有动态 SQL 场景。像表名、列名、ORDER BY 字段这类标识符,通常无法直接放进占位符。很多问题正是在这里出现的:开发者尝试参数化失败后,又退回字符串拼接,于是把最危险的一段逻辑重新放开。
这类需求可行的办法只有白名单校验,而且要做成严格匹配,而不是模糊过滤。
例如,排序字段可以先定义一个允许集合:
allowed_sort_fields = {"created_at", "name", "status"}随后只接受集合中的值:
if sort_field not in allowed_sort_fields: raise ValueError("Invalid sort field")表名处理逻辑也是一样。不能靠“过滤掉 ;”或“只允许字母”来碰运气,而要明确枚举哪些值是合法的。因为这里要防的不是字符长得像不像危险输入,而是它是否属于业务允许的 SQL 结构。
这一节真正难的地方,其实不在代码写法,而在后续维护。业务字段变化后,如果白名单没有同步更新,问题往往不会立即暴露,却会在审计时留下隐患。相比显眼的字符串拼接,这种遗漏更隐蔽,也更容易被忽略。
一套可落地的判断标准
如果要快速判断一段数据库访问代码是否安全,可以直接按下面的逻辑看:
- 只要用户输入参与了字符串拼接,就应视为存在注入风险
- 只使用
prepare()还不够,还要确认不是模拟预处理 - 参数化只能处理“值”,不能处理表名、列名、排序字段
- 动态标识符必须使用白名单,并且是穷举式白名单
- 类型绑定要和驱动要求一致,尤其要留意单参数元组、占位符格式和数据库差异
归根结底,避免 SQL 注入的关键不是“把输入洗得更干净”,而是从设计上切断输入与 SQL 结构之间的直接拼接关系。只要这一点没有做到,再多的转义、过滤和正则规则,都只是看起来更忙,实际上并不更安全。















